Python实现单例模式的三种常见方式解析
本文详细解析Python中实现单例模式的三种主要方法:通过装饰器缓存实例、重写基类__new__方法以及利用元类控制类创建。每种方式均附有代码示例,帮助开发者理解不同场景下的最佳实践与实现细节。
2026-10-13
12
本文详细解析Python中实现单例模式的三种主要方法:通过装饰器缓存实例、重写基类__new__方法以及利用元类控制类创建。每种方式均附有代码示例,帮助开发者理解不同场景下的最佳实践与实现细节。
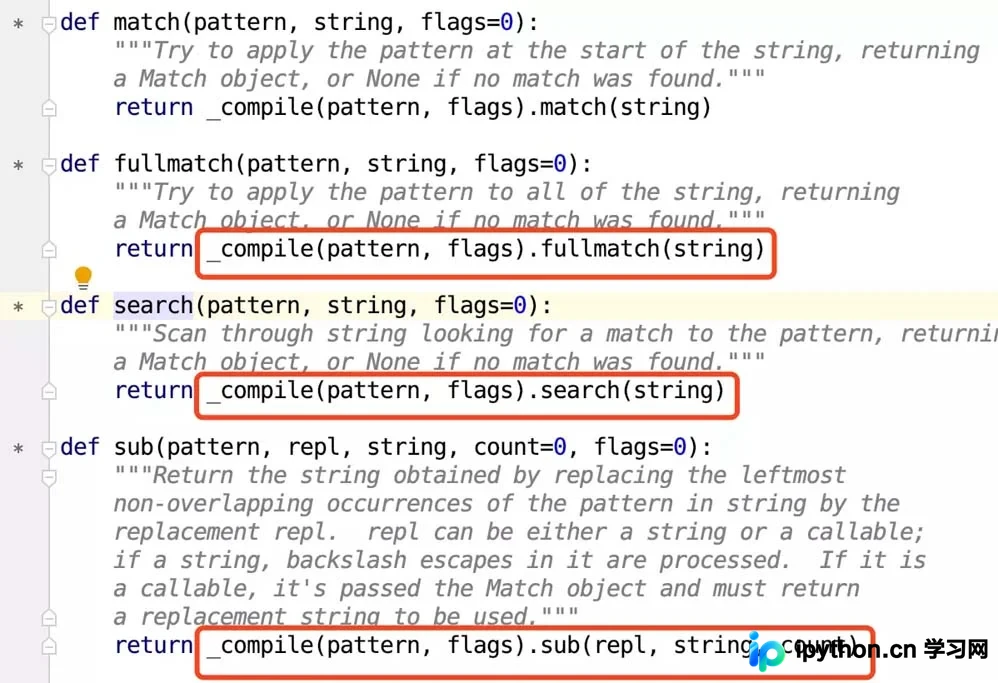
本文通过Python源码深入解析,指出re模块中的search、findall等方法内部已自动调用_compile并具备缓存机制。手动调用re.compile不仅多余,且源自其他语言的不良习惯。文章澄清了关于百万级数据匹配的性能误区,建议开发者直接使用内置方法以获得更简洁高效的代码。
本文介绍在Python中遍历列表时获取元素下标的两种常见方式。通过range(len())手动计算索引是基础方法,而使用内置enumerate函数则是更地道、高效的Pythonic写法。文章还解析了enumerate的start参数用法,并指出了随意命名变量及不必要的list转换等常见代码瑕疵,帮助开发者写出更规范的Python代码。
本文详细解析Python中获取WebSocket实时数据的四种常见链接方式。通过对比create_connection、ws4py客户端、原生WebSocket模块以及WebSocketApp类,分析各方案在连接稳定性、耗时及代码复杂度上的差异。文章提供了完整的代码示例,帮助开发者根据实际需求选择最合适的实现方案,并指出各方法的潜在优缺点。
本文介绍如何利用Python将MySQL数据库中的数据转换为JSON格式,以简化第三方推送平台的数据录入工作。通过实例代码展示连接数据库、查询数据、处理字典结构及生成JSON文件的全过程,帮助开发者高效完成数据格式转换任务。
本文详解如何在 Python Pandas 中高效获取满足特定条件的行索引。对比了低效的迭代方式,重点介绍了使用布尔索引直接获取 index 列表的方法,并深入解析了 iloc(位置索引)与 loc(标签索引)的区别。同时提供了利用 np.flatnonzero 获取序数索引的技巧,帮助开发者避免常见的索引混淆错误。
本文介绍如何使用Python的Numpy库计算两个数组的平均值。通过示例展示了数组相加后除以2的操作,生成包含浮点数的平均向量,适用于基础数据处理场景。
本文提供两个经典的C语言数据结构应用案例:基于链表的通讯录管理和基于图结构的教学任务分配系统。前者演示了节点的动态创建、内存释放、按名排序及文件I/O读写;后者通过二维数组映射教师专长与课程,实现了自动匹配与冲突解决的排课逻辑。代码涵盖基础语法到复杂算法,适合数据结构初学者深入理解指针与内存管理。
本文详解Python中基于TCP协议的套接字编程。通过模拟电话沟通、文件传输及SSH远程命令执行等场景,分别展示服务端与客户端的代码实现。内容涵盖Socket创建、绑定、监听、连接及数据收发流程,并针对粘包问题、命令执行结果获取及跨平台编码处理进行说明,帮助读者掌握网络通信核心原理。
本文介绍如何在Django框架的模板中直接访问Request对象的各种信息。通过配置setting.py中的TEMPLATE_CONTEXT_PROCESSORS,并在视图函数中使用RequestContext渲染模板,可以在HTML模板中直接获取Session、GET参数等数据,无需在视图层额外传递。
本文介绍如何在Python项目中封装日志操作类,并结合RotatingFileHandler实现日志自动轮转。通过示例展示INetLogger类的单例模式实现,以及logger.ini配置文件中对日志级别、输出格式和文件轮转策略(如大小2000000字节、保留9个文件)的具体配置方法,帮助开发者在生产环境中有效管理日志文件。
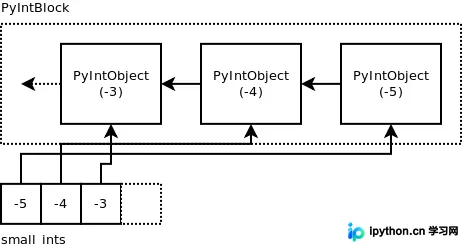
本文深入解析Python中整数对象的内部实现机制。通过PyIntObject结构体,Python利用小整数对象池缓存[-5, 257)范围内的整数以实现共享。对于大整数,Python采用PyIntBlock缓冲池和free_list链表进行内存复用,避免频繁malloc带来的性能损耗。文章详细阐述了整数创建、缓存获取及销毁时的内存处理逻辑,揭示Python在性能与代码简洁性之间的权衡策略。