


Python使用random模块打乱数组顺序的两种方法
本文介绍Python中利用random模块打乱数组顺序的两种方法。通过iris数据集示例,演示如何使用sample()生成新索引序列以重排数据,以及shuffle()直接修改原列表。重点强调shuffle无返回值及sample返回新列表的区别,帮助开发者避免常见错误。
2026-10-13
7
本文介绍Python中利用random模块打乱数组顺序的两种方法。通过iris数据集示例,演示如何使用sample()生成新索引序列以重排数据,以及shuffle()直接修改原列表。重点强调shuffle无返回值及sample返回新列表的区别,帮助开发者避免常见错误。
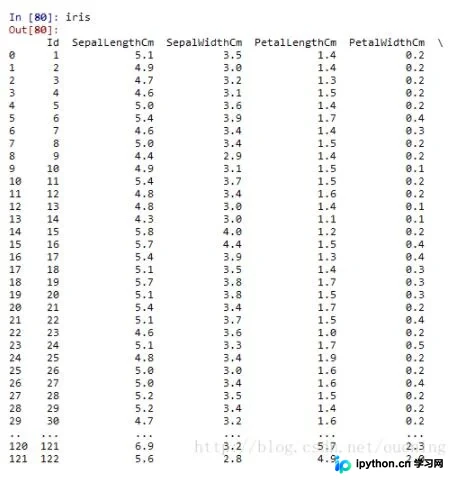
本文介绍Python中训练数据与标签同步打乱的两种常用方法。第一种通过生成并打乱索引数组来重排数据,适用于大数据量以节约内存且每次结果不同;第二种利用随机种子固定打乱顺序,分别对数据和标签执行shuffle。两者各有适用场景,可根据需求选择。
本文介绍Python中random.shuffle()函数的使用方法。该函数用于将序列元素原地打乱,不返回新序列而是直接修改原对象。通过示例展示如何对列表进行随机重排,并强调其返回值为None的特性,帮助用户正确理解和使用该功能。
本文详细介绍 Python 3.5 引入的列表拼接新语法。相比传统的列表相加或 extend 方法,新语法允许在列表前使用星号 * 进行解包,从而支持将 range 对象直接合并到列表中。文章通过代码示例对比了旧版报错与新版正确用法,帮助开发者掌握这一特性。
本文深入解析Django URL路由机制,涵盖URLconf模块加载、正则匹配顺序及参数传递方式。详细对比无名与有名分组的传参差异,讲解reverse与url标签实现反向解析,并阐述路由分发、命名空间解决冲突及伪静态URL配置技巧,帮助开发者构建规范的后端路由系统。
本文通过Python Pika库详细演示了RabbitMQ中Fanout、Direct和Topic三种Exchange模式的具体实现。内容涵盖广播、精确路由及通配符路由的配置方法、代码示例及运行结果分析,帮助开发者理解不同场景下的消息分发机制。
本文介绍使用Python将Word文档内容批量导入MySQL数据库的方法。通过解析文档标题中的数字作为编号,并提取勾选内容与常规文本分别处理,实现数据自动化入库。代码包含数据库连接、游标操作及文件遍历逻辑,适用于需要批量处理文档数据的场景。
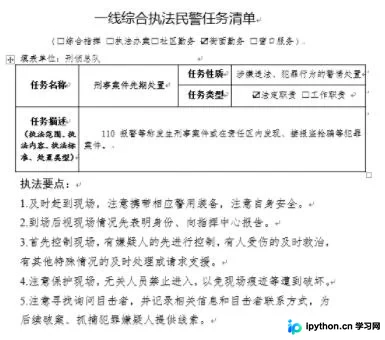
本文介绍如何在Python中使用列表生成式替代传统的嵌套for循环,以提取嵌套列表中的元素。通过对比传统循环与列表生成式的写法,展示代码简化技巧,帮助开发者提升代码可读性与执行效率。
本文介绍Python中两种将嵌套列表转换为一维列表的方法。第一种利用列表推导式,通过双重循环遍历元素;第二种借助内置sum函数或itertools模块的chain函数,实现简洁的一行代码平铺。文章包含具体代码示例与运行结果,帮助开发者快速掌握相关技巧。
本文介绍如何使用Python SymPy库求解矩阵方程。重点解析AX=A+2X与XA=A+2X两种情形下,因矩阵乘法不可交换性导致的左乘与右乘求逆差异。通过具体代码示例展示如何定义矩阵、计算逆矩阵并验证解的正确性,帮助开发者避免常见的运算顺序错误。
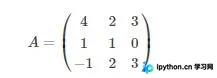
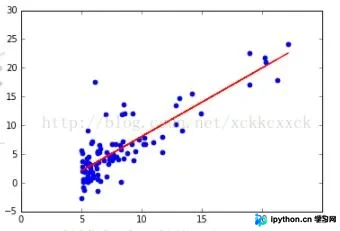
本文介绍如何利用Python的sklearn库实现单变量线性回归。通过读取数据文件,使用LinearRegression进行模型训练,并展示预测与可视化结果。重点解析fit、predict及score方法的应用,适合机器学习初学者参考。
本文分享一个基于Python的大文件去重示例代码,支持GB级别数据。通过正则表达式提取词元并利用集合去重,实现高效处理。代码包含文件读取、去重逻辑及结果保存功能,适用于需要处理海量文本数据的场景。