


Python实现MySQL数据库跨服务器迁移脚本
本文介绍使用Python 2.7实现MySQL数据库跨服务器迁移的方法。通过分页查询与提交机制,每5000条数据进行一次处理,确保迁移过程的稳定性和效率。代码支持自定义每次查询提交的数量,适用于需要大规模数据迁移的场景。
2026-10-13
7
本文介绍使用Python 2.7实现MySQL数据库跨服务器迁移的方法。通过分页查询与提交机制,每5000条数据进行一次处理,确保迁移过程的稳定性和效率。代码支持自定义每次查询提交的数量,适用于需要大规模数据迁移的场景。
本文提供了一段Python脚本,用于每日将MySQL数据库中的历史数据迁移至归档库。脚本通过命令行参数配置源与目标数据库连接、表名及迁移策略,支持按时间区间自动清理旧数据,适用于需要定期归档历史记录的数据库维护场景。
本文详解Python读取中文TXT文本的方法,重点区分Python2与Python3的实现差异。针对Python2,需以unicode为中间编码进行转换,并特别注意处理UTF-8文件头部的BOM字符;Python3则可通过open函数的encoding参数直接指定编码。文章提供了具体的代码示例及decode方法的错误处理策略,帮助开发者避免乱码问题。
本文介绍在Python中使用Pandas处理数据时,将DataFrame对象转换为NumPy数组的具体方法。通过调用DataFrame的values属性,可以高效获取底层数组数据,适用于需要高性能数值计算的场景。
本文详细解析Python原生list与NumPy数组之间的相互转换方法。通过示例展示如何将list转换为np.array,以及利用tolist()方法将数组还原为list,帮助开发者高效处理数据结构转换需求。
本文深入对比Java与Python在速度、历史遗留、敏捷性、市场普及度及架构五大维度的表现。Java凭借JIT编译和多核支持在性能上占优,且在企业级应用和测试生态中更为成熟;Python则在脚本简洁性和DevOps集成上具备敏捷优势。尽管两者各有千秋,但Java在企业招聘和大型系统稳定性方面仍具传统优势,适合不同场景的开发者参考。
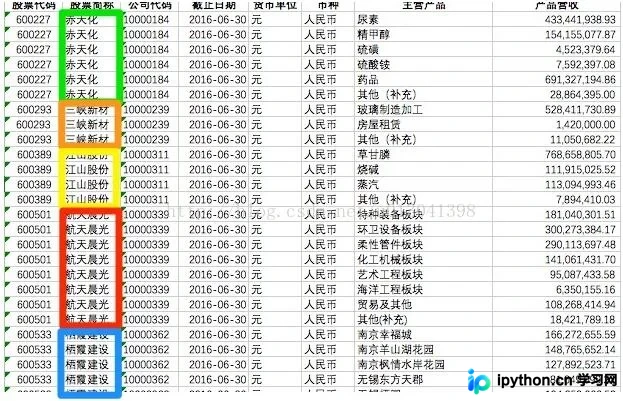
本文详解pandas中DataFrame的groupby分组聚合操作,涵盖Splitting、Applying、Combining三步流程。通过代码示例展示按单列或多列分组求和、求最值的方法,并重点解析reset_index()对输出结果索引结构的影响及列名提取差异,帮助开发者掌握数据预处理中的分组运算技巧。
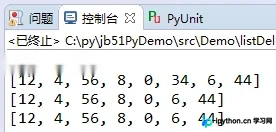
本文介绍Python中移除列表指定位置元素的实现逻辑。核心在于判断索引是否越界,若超出范围则返回原列表,否则调用pop方法删除指定索引元素。代码包含对负索引及越界情况的处理,适合需要处理列表数据清洗或特定位置删除的场景参考。
本文深入解析Python中二维数据的两种主要实现方式:内置list与NumPy的array。通过代码实例对比两者在索引操作上的差异,重点展示numpy.array支持的多元组索引与切片功能,并分析list存储对象指针带来的内存开销。旨在帮助开发者根据场景选择合适的数据结构,提升数据处理效率。
本文深入解析Python中NumPy多维数组的切片与索引机制。通过具体代码示例,详细演示如何选取特定维度的子元素、提取指定列数据以及截取连续区间。涵盖从基础的一维提取到复杂的多维切片操作,帮助开发者掌握高效的数据处理技巧。
本文详解Python中一维列表向多维数组扩展的方法,重点剖析直接对空子列表赋值引发的报错原因。通过append与insert的正确用法,解决多维数组初始化难题,并结合杨辉三角实例展示高效构建逻辑,避免常见编程陷阱。
本文介绍Python中读取二维数组的两种实现方式。第一种利用列表推导式结合map函数,将输入字符串转换为整数列表;第二种通过基础循环初始化矩阵并逐行读取。文章以3x3矩阵为例,展示了从键盘接收数据并转换为int类型的具体代码实现,供开发者参考。