


Python pandas生成指定日期范围与时间序列重采样详解
本文详解Python pandas中生成指定日期范围的方法,包括使用date_range设定起止时间、周期及频率。重点讲解时间序列的重采样技术,涵盖通过resample进行降采样(高频转低频)与升采样(低频转高频)的具体操作,解析closed、label等关键参数对聚合结果的影响,并提供基于groupby的替代聚合方案及填充策略。
2026-10-13
7
本文详解Python pandas中生成指定日期范围的方法,包括使用date_range设定起止时间、周期及频率。重点讲解时间序列的重采样技术,涵盖通过resample进行降采样(高频转低频)与升采样(低频转高频)的具体操作,解析closed、label等关键参数对聚合结果的影响,并提供基于groupby的替代聚合方案及填充策略。
本文介绍使用pandas库处理矢量数据时的替换操作。通过Series对象的replace方法,可高效实现单个数值或字典映射的批量替换,避免手动查找数据对象的繁琐步骤。示例展示了整数替换及NaN处理,适用于Python数据分析场景。
本文详细解析了NumPy和Pandas中数组的合并与拆分技术。在合并方面,介绍了利用concatenate和concat方法通过指定axis参数实现纵轴与横轴拼接,并强调了Pandas中需将DataFrame置于列表中的差异。在拆分与内存布局方面,阐述了C语言(行优先)与Fortran(列优先)顺序的区别,以及如何通过order参数控制reshape和ravel操作,帮助开发者深入理解底层内存布局对数据处理的影响。
本文介绍基于Python多线程实现的多用户全双工聊天系统。服务器作为中转站处理消息转发,客户端通过输入用户名登录并指定通信对象。系统定义了严格的通信规则,包括用户名唯一性校验、目标用户选择机制(to:username)以及动态切换通信对象的功能。当发送quit命令时,线程终止并清理用户状态。代码展示了服务器与客户端的完整实现,利用多线程处理并发连接与消息收发。
本文介绍Python检测文件MD5值的两种实现方式,涵盖字符串与大文件的哈希计算。通过hashlib模块读取文件内容并生成摘要,提供完整代码示例及在线加密工具链接,适用于Python程序设计与数据完整性验证场景。
本文详细介绍Python中Pandas库的concat函数,用于DataFrames的合并操作。通过设置axis参数实现纵向(行)或横向(列)拼接,并解析objs、join等关键参数的作用,帮助开发者高效处理数据整合任务。
本文介绍了一个基于Python的进程监控脚本,利用psutil库在Windows环境下实时监测指定进程的CPU、内存及句柄数。当CPU或内存使用率超过60%,或线程句柄数超过300时,脚本会自动终止该进程。脚本支持自动安装依赖包,适用于Windows 64位系统及Python 2.7环境,为系统资源管理提供了自动化解决方案。
本文介绍在Python中利用NumPy库快速合并多个矩阵或数组的方法。内容涵盖纵向合并(vstack、r_)与横向合并(hstack、c_)两种核心操作,通过具体代码示例展示如何高效实现数组的行与列拼接,适用于数据处理与科学计算场景。
本文介绍使用Python标准库计算文件MD5值的具体方法。通过读取二进制文件内容并调用hashlib模块生成摘要,示例展示了完整的CheckMD5OfFile.py脚本及命令行执行结果,适用于需要验证文件完整性的场景。
本文详细介绍两种在Python中实现动态时钟的方法。第一种利用Turtle图形库,通过建立5个Turtle对象分别绘制表盘、三根指针及文字输出,实现图形化动态更新。第二种基于控制台环境,通过导入time、sys和os模块,利用无限循环、字符串格式化及清屏刷新技术,在命令行实时显示当前时间。
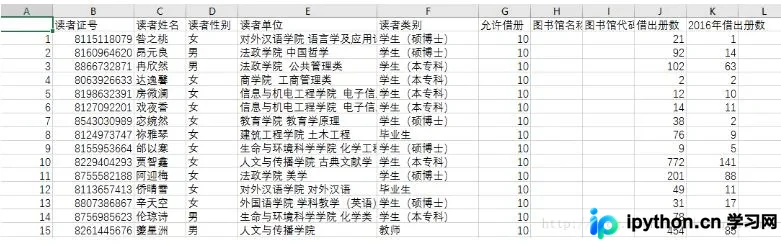
本文介绍如何利用Python的Pandas库合并两个CSV文件,实现图书数据集成。通过读取ReaderInformation.csv和ReaderRentRecode.csv,使用merge函数进行左连接,最终生成包含读者与借阅详情的data.csv文件,便于整体数据分析。
本文提供了一段使用Python编写的TCP监听端完整代码。通过socket模块建立连接,利用struct处理数据头,实现了持续接收数据并解析线程ID与错误码的功能。代码包含异常处理机制,支持通过命令行参数指定监听端口,适用于需要稳定监听服务端口的Python开发场景。