Python使用字典合并两个通讯录文本文件的实现方法
本文介绍利用Python字典结构将两个独立的通讯录文本文件合并为一个完整文件的实例。通过读取电话本和邮箱本文本,利用字典键值对匹配姓名,处理缺失数据并输出合并结果,适用于基础文件操作与数据整合场景。
2026-10-13
8
本文介绍利用Python字典结构将两个独立的通讯录文本文件合并为一个完整文件的实例。通过读取电话本和邮箱本文本,利用字典键值对匹配姓名,处理缺失数据并输出合并结果,适用于基础文件操作与数据整合场景。
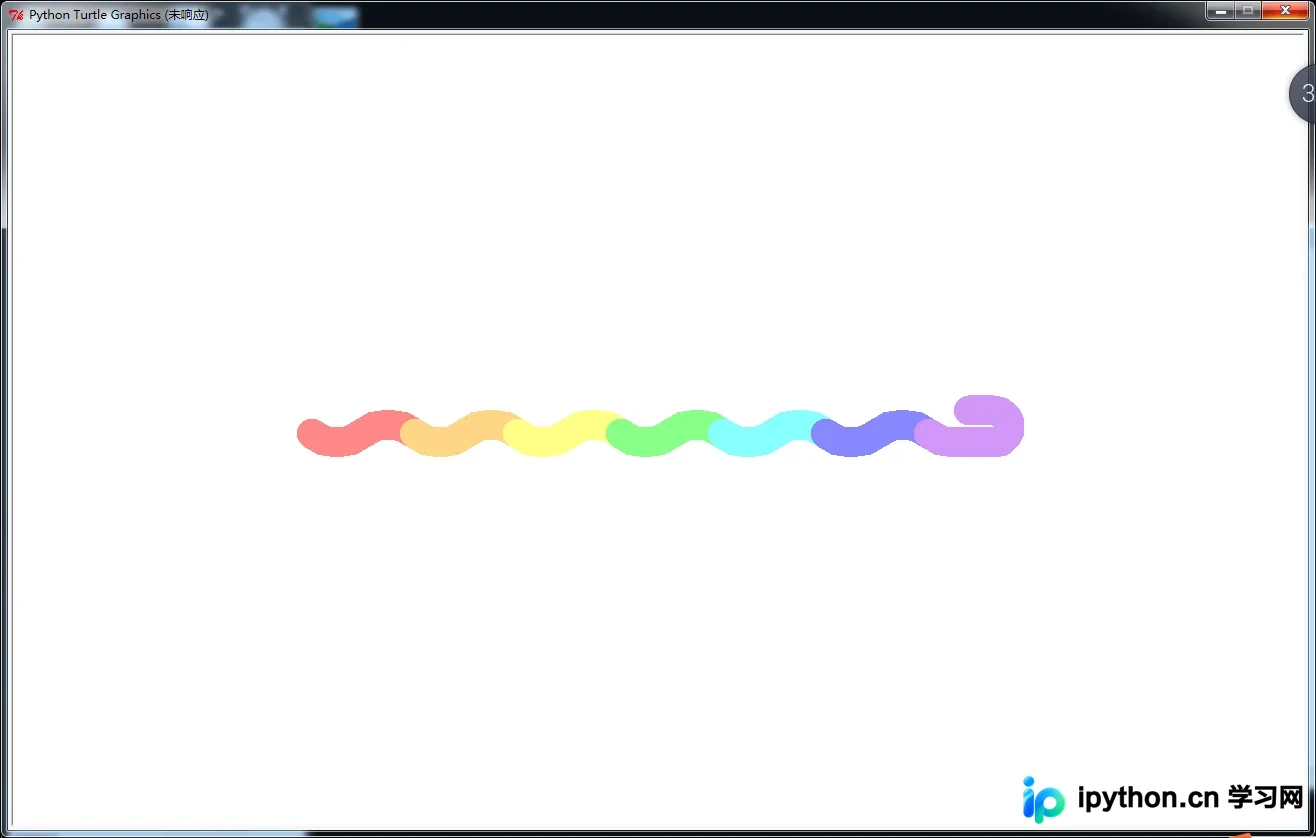
本文详解如何利用Python的Turtle库绘制七彩蟒蛇。通过引入颜色列表替代单一pencolor设置,结合循环索引动态切换颜色,并将绘制段数调整为6以匹配七彩需求。此外,演示了使用penup、goto和pendown命令调整起始坐标的方法,提供完整可运行代码及效果展示。
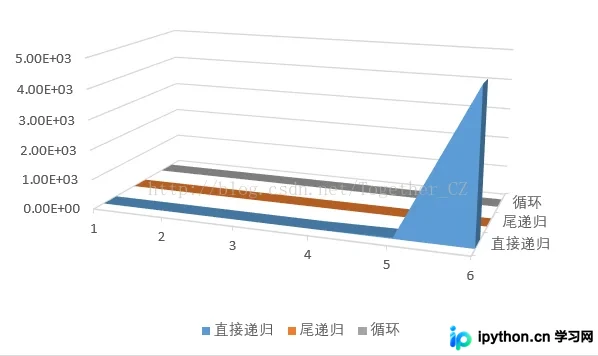
本文深入解析Python中斐波那契数列的三种实现方式:直接递归、尾递归及循环。通过代码示例与实测数据对比,揭示直接递归在数值增大时呈指数级增长的时间消耗,而尾递归与循环则保持极低的耗时。文章指出循环性能略优于尾递归,建议在实际开发中优先使用循环或尾递归以规避栈溢出风险并提升执行效率。
本文深入解析Python中的内存管理机制,重点对比浅拷贝与深拷贝的核心差异。通过代码示例展示对象赋值、浅拷贝及深拷贝在内存地址分配上的不同表现,阐明父对象与内层数据在两种拷贝方式下的独立性关系,帮助开发者避免因引用共享导致的数据意外修改问题。
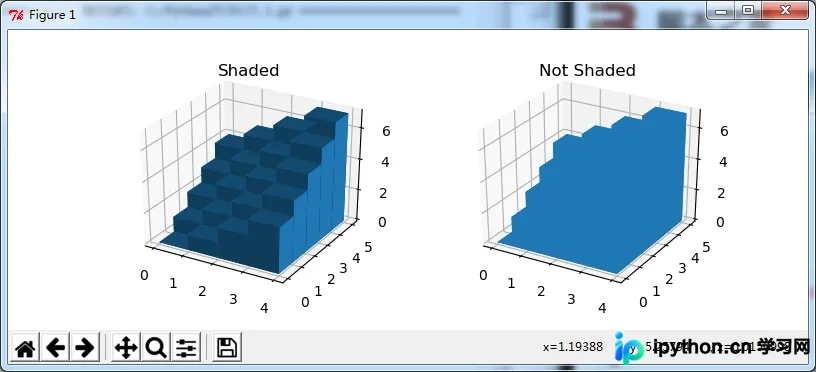
本文介绍如何使用Python的matplotlib库绘制3D条形图,重点演示通过bar3d函数的shade参数控制阴影显示。代码包含生成模拟数据、创建两个子图分别展示有阴影和无阴影的效果,并调用plt.show()渲染图形。
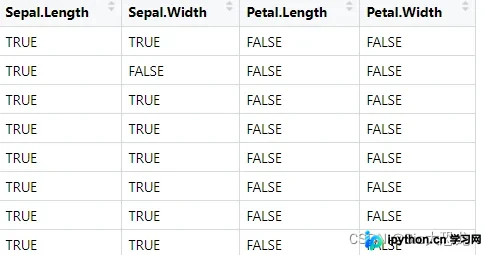
本文详细解析R语言中常用的apply系列函数,包括按行列操作的apply、返回列表的lapply、简化返回类型的sapply、分组聚合的tapply以及多参数并行的mapply。通过iris数据集等真实示例,说明各函数的输入参数、运行逻辑及返回值类型差异,帮助快速掌握数据批量处理技巧。
本文对比分析Python 2与Python 3中print机制的根本差异。Python 2中print为语法结构,无需括号且默认换行;Python 3中print为内置函数,必须使用括号,支持sep、end、file等参数。文章详细讲解了多参数打印、自定义分隔符、不换行输出及文件重定向的实现方式,并介绍了如何在Python 2中通过__future__模块兼容Python 3的print行为。
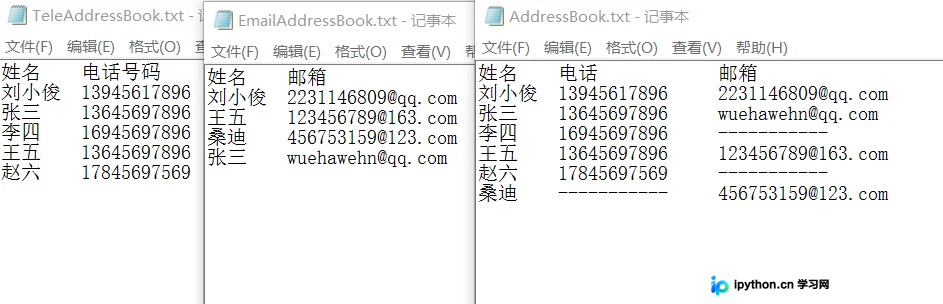
本文介绍使用Python将电话簿TeleAddressBook.txt与电子邮件EmailAddressBook.txt合并为AddressBook.txt的方法。通过读取两个源文件,解析姓名、电话及邮箱信息,匹配后写入新文件,实现数据整合。
本文通过Python温度转换实例,详细解析了input获取用户输入、字符串切片提取数值以及eval函数求值的核心知识点。文章展示了如何区分摄氏度与华氏度,利用float或eval处理数据,并结合条件判断实现双向转换,为初学者提供完整的代码逻辑与语法说明。
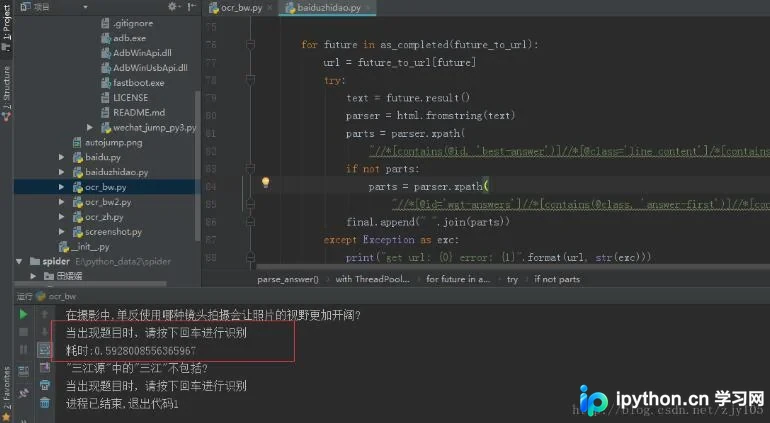
本文介绍基于Python3.5、Tesseract OCR及ADB技术,实现西瓜视频或头脑王者等答题类应用的辅助脚本。通过ADB抓取屏幕图像,利用OCR识别题目与选项,并自动调用浏览器搜索答案,将识别耗时压缩至0.5-0.6秒,显著提升答题效率与胜率。
本文提供Python实现根据Unicode编码范围判断字符语言类型的完整代码。通过定义汉字、数字、英文字母及非汉字字符的判断函数,结合全角半角转换与字符串格式化功能,实现将输入字符串按中文、字母和数字进行分离处理,适用于多语言文本的基础分类场景。
本文详解Flask中如何通过abort主动抛出异常,并利用errorhandler与app_errorhandler实现局部及全局统一异常处理。通过蓝本注册与装饰器配置,可自定义错误页面,确保用户获得友好提示,同时保持后台逻辑清晰。