

Python MySQL连接池配置指南:提升并发性能

在高并发网络服务或多线程批量处理任务中,Python 应用程序如果对每次 SQL 查询都临时创建物理数据库连接,会导致大量的 TCP 三次握手、身份鉴权与握手断开开销,极易耗尽 MySQL 的连接上限并产生明显的请求延迟。通过引入连接池技术,在应用启动时维持一个稳定容量的持久连接集合,让各工作线程循环借调与归还连接,可直接将单次数据库交互开销降至亚毫秒级。本文详细拆解 Python 搭配 MySQL 连接池的核心实现、参数配置标准、多线程并发封装及常见生产陷阱,为后端服务提供可靠的并发调优路径。
一、连接池的工作原理与并发优化价值
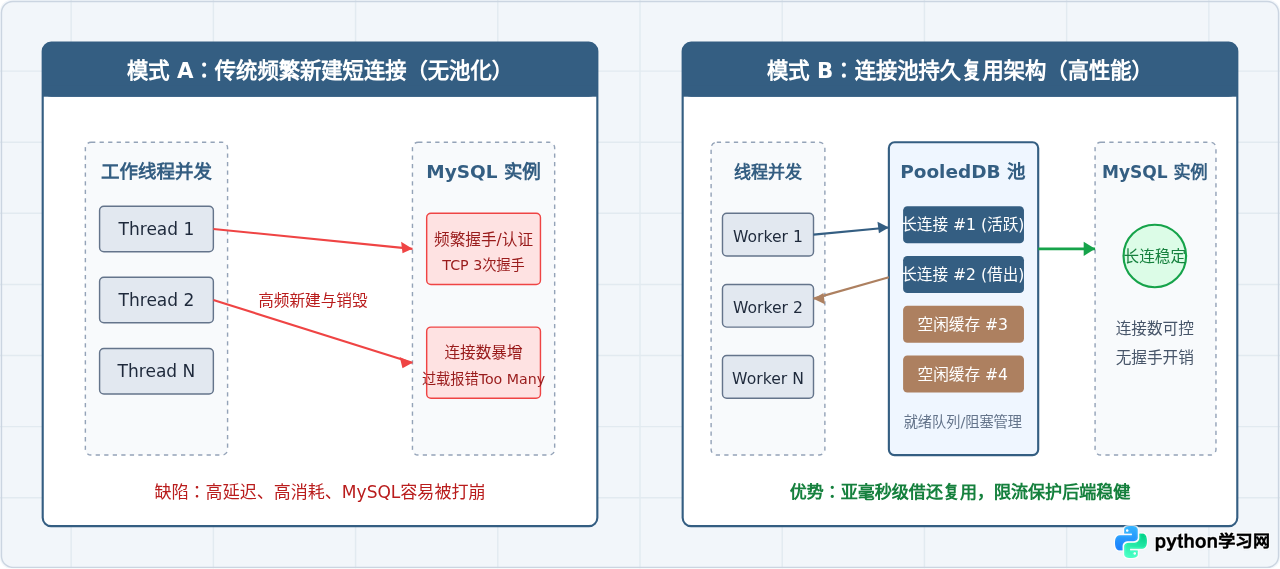
传统的单连接或随用随建(On-demand)模式在并发场景下面临双重瓶颈:首先,建立一次 MySQL 连接需经过“Socket 分配 → TCP 握手 → MySQL 协议握手 → 密码加密验证 → 会话环境初始化”等多个网络往返,耗时通常在数毫秒至数十毫秒之间;其次,MySQL 服务端能够承受的最大并发线程与连接数是有限的(由 max_connections 控制),过多的瞬时连接创建会导致数据库服务器内存暴增与上下文切换抖动。
连接池(Connection Pool)在应用程序与数据库服务端之间建立了一道缓冲调度层。其核心管理机制包含“预热准备”、“空闲管理”与“配额借还”:
- 复用物理链路:客户端工作线程不再直接与 MySQL 发起连接,而是向本地连接池请求现成连接。
- 平滑峰值流量:当并发请求超出连接池容量时,连接池可通过排队阻塞机制限制对数据库的瞬间冲击,避免把 MySQL 打满崩溃。
- 减少服务端开销:维持适度稳定的长连接,使 MySQL 服务端线程缓存命中率提高,降低服务器整体 CPU 负载。
二、主流连接池选型与环境安装
在 Python 生态中,主流的 MySQL 驱动及配套连接池主要有两大方向:
- DBUtils(推荐生产通用方案):独立的数据库连接池基础库,采用标准的 DB-API 2.0 规范,提供
PooledDB。它不绑定具体驱动,既能与纯 Python 实现的pymysql配合,也能无缝搭配 C 扩展的mysqlclient。它在多线程安全性、重连保活以及最大连接数熔断控制上表现极为成熟。 - mysql-connector-python(Oracle 官方驱动):内置了基础连接池模块
mysql.connector.pooling.MySQLConnectionPool。在无外部第三方包引入限制的小型项目中较为便捷,但在连接超时重连(Ping)及细粒度排队参数上略显单一。
在兼顾性能与稳定性的生产环境中,推荐使用 DBUtils + PyMySQL(或 mysqlclient)。环境依赖安装命令如下:
# 安装 DBUtils 与 PyMySQL 驱动
pip install DBUtils pymysql

# 若环境支持 C 编译器且追求极致查询解析性能,也可替换为 mysqlclient
# pip install mysqlclient
三、连接池标准配置与生命周期实现步骤
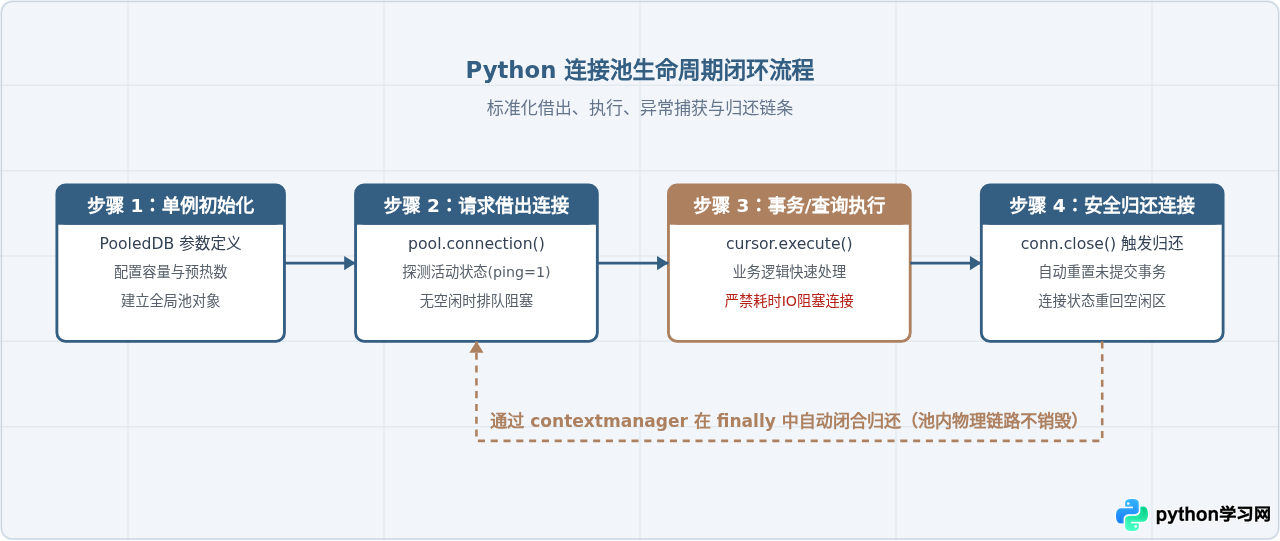
使用连接池的核心在于保证其作为全局唯一的单例实例存在,切忌在每个函数或请求内部重复实例化 PooledDB。在多线程业务中,推荐结合 Python 上下文管理器(Context Manager)封装借出与归还逻辑,确保即使业务代码抛出异常,连接也能百分之百归还给池,杜绝连接泄漏。
核心封装代码:生产级线程安全连接管理器
以下代码提供了一个完整的数据库管理器模块。通过 @contextmanager 装饰器封装游标与连接的提取,调用方只需要使用 with get_db_cursor() 即可自动提交与安全归还:
import pymysql
from dbutils.pooled_db import PooledDB
from contextlib import contextmanager

class MySQLPoolManager:
    """全局单例 MySQL 连接池管理器"""
    _pool = None

    @classmethod
    def initialize_pool(cls):
        if cls._pool is None:
            cls._pool = PooledDB(
                creator=pymysql,          # 底层驱动数据库模块
                mincached=5,              # 初始化时创建的空闲连接数
                maxcached=10,             # 池中允许保留的最大空闲连接数
                maxshared=0,              # 最大共享连接数(0 表示连接专属于线程,不共享)
                maxconnections=20,        # 允许创建的最大物理连接上限
                blocking=True,            # 连接数超限时是否等待(True=排队等待,False=抛异常)
                maxusage=1000,            # 单个连接被重复使用多少次后强制重建,防止内存泄漏
                setsession=[],            # 每次连接初始化执行的 SQL,如 ['SET AUTOCOMMIT = 1']
                ping=1,                   # 0=不检测,1=从池中借出时 ping 检查连通性,2=执行 SQL 前检查
                host='127.0.0.1',
                port=3306,
                user='app_user',
                password='SecurePassword123!',
                database='production_db',
                charset='utf8mb4',
                autocommit=False,         # 建议手动显式控制事务
                cursorclass=pymysql.cursors.DictCursor
            )
        return cls._pool

    @classmethod
    def get_connection(cls):
        """从连接池中获取一个可用连接"""
        if cls._pool is None:
            cls.initialize_pool()
        return cls._pool.connection()

# 基于上下文管理器的安全借还封装
@contextmanager
def get_db_cursor(commit=False):
    """
    上下文管理器:自动获取连接、生成游标、处理事务并在退出时归还
    :param commit: 是否在正常退出上下文时自动提交事务
    """
    conn = MySQLPoolManager.get_connection()
    cursor = conn.cursor()
    try:
        yield cursor
        if commit:
            conn.commit()
    except Exception as e:
        conn.rollback()
        raise e
    finally:
        # 关闭游标并归还连接至池中
        cursor.close()
        conn.close()  # 这里的 close() 已被 DBUtils 重写,实际为归还到池中,并非关闭 TCP
业务调用示例
在业务逻辑(例如 Flask/FastAPI 路由或后台多线程处理函数)中,直接通过 with 语句使用,逻辑清晰且完全规避了连接泄露风险:
# 查询操作示例
def query_user_info(user_id: int):
    with get_db_cursor(commit=False) as cursor:
        sql = "SELECT id, username, email FROM users WHERE id = %s"
        cursor.execute(sql, (user_id,))
        return cursor.fetchone()

# 事务更新示例
def update_user_status(user_id: int, new_status: str):
    with get_db_cursor(commit=True) as cursor:
        sql = "UPDATE users SET status = %s WHERE id = %s"
        affected_rows = cursor.execute(sql, (new_status, user_id))
        return affected_rows > 0
四、关键参数调优与并发容量计算
连接池性能的高低直接取决于各项容量参数的设定。参数设置过小,会导致请求频繁因排队而阻塞超时;设置过大,则会超出 MySQL 服务端的承载能力,引发内存耗尽或线程上下文切换惩罚。
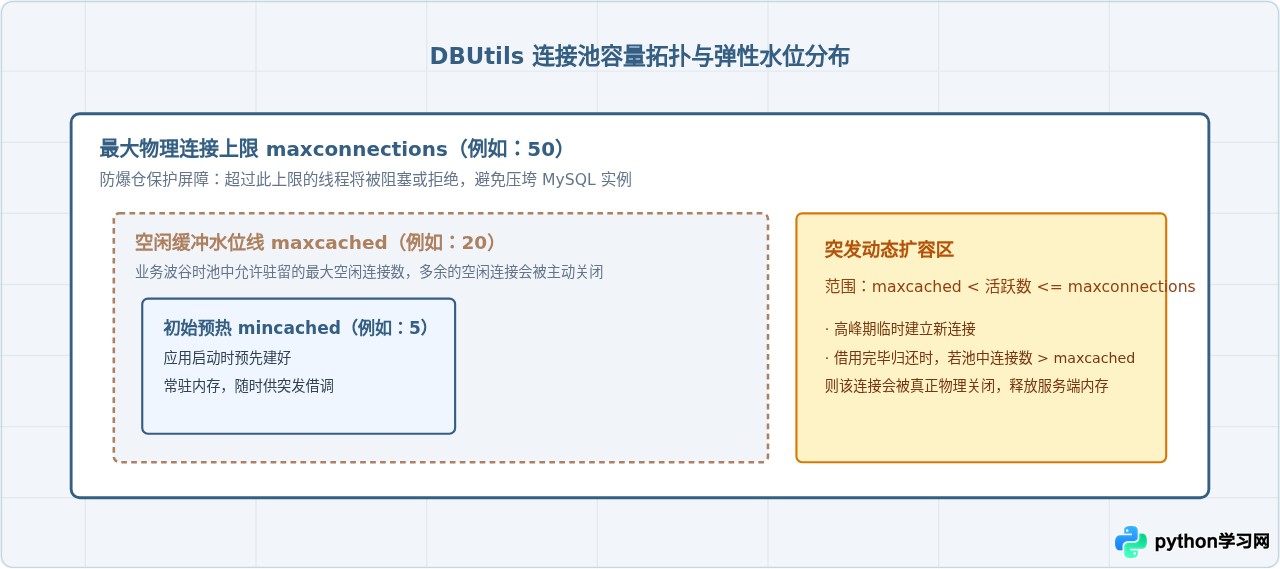
参数配置对照与解析
| 参数名称 | 推荐范围 | 作用说明 | 配置不当的风险 |
|---|---|---|---|
mincached |
5 ~ 20 | 连接池初始化时预先建立的空闲物理连接数。 | 过大导致启动慢占用资源;过小导致突发流量初次访问延迟高。 |
maxcached |
10 ~ 50 | 池中允许闲置保留的最大连接数。 | 若设得太小,一旦高峰回落会触发频繁的物理断连与重连震荡。 |
maxconnections |
20 ~ 100(按需) | 允许建立的最大连接总数(包含被借出和空闲的)。 | 如果超过 MySQL max_connections / 实例数,会导致 DB 报 1040 错误。 |
blocking |
True | 当连接数达到 maxconnections 时,新请求是否排队等待。 |
若设为 False,高并发突发时未拿到连接的线程会立即抛出异常崩溃。 |
maxusage |
1000 ~ 5000 | 一个物理连接被借用累计达到该次数后自动销毁重建。 | 设为 0(无限制)可能导致长时间运行后出现隐性客户端内存膨胀。 |
ping |
1 | 连接存活检测时机(1 表示借出时自动执行轻量级 ping)。 | 若设为 0,可能借出已被 MySQL 踢掉的死连接,报 2006 异常。 |
对于单台多线程应用实例,最大连接数可按照以下公式预估:
maxconnections ≈ (核心工作线程数 × 预期单次查询耗时占比) + 冗余储备例如一个拥有 16 个 Worker 线程的 Web 服务,如果每个请求中数据库操作耗时占总请求时间的 30%,则
maxconnections 设定为 16 × 0.3 + 5 ≈ 10 即可满足平稳吞吐,无需盲目配置上百连接。
五、高并发场景生产踩坑排查与应对
1. 针对 MySQL wait_timeout 的防掉线机制
MySQL 服务端默认设有 wait_timeout 参数(默认通常为 28800 秒,但在很多云数据库或生产配置中会被调低至 600 秒或 300 秒)。若池中的空闲连接在设定的超时时间内没有任何网络交互,MySQL 服务端会主动发起 TCP FIN 包单方面关闭连接。此时若 Python 客户端直接复用该连接,会抛出经典的:
OperationalError: (2006, 'MySQL server has gone away')
# 或者
OperationalError: (2013, 'Lost connection to MySQL server during query')
解决办法:在初始化 PooledDB 时务必指定 ping=1。DBUtils 会在每次调用 connection() 借出连接时,向服务端发送极其轻量的探测包;若发现连接已被服务端切断,连接池会在底层自动透明重连,业务代码完全无感知。
2. 彻底避免连接泄漏(Connection Leak)
在高并发场景下,最严重的隐患不是连接不够用,而是“借出后未归还”。常见场景包括:业务分支发生未捕获异常退出、由于使用了 return 跳过了末尾的手动 close()、或在长时间耗时的外部 HTTP 调用期间一直占用数据库连接。
防范准则:
- 绝对杜绝在代码中裸写
conn = pool.connection(),必须统一采用with上下文管理器来确保finally中的自动归还。 - 遵循“晚借早还”原则:只有在真正需要执行 SQL 时才进入数据库上下文,避免在数据库上下文内执行耗时的外部 API 请求或复杂计算。
3. 多进程模型(Gunicorn / uWSGI)下的隔离陷阱
Python Web 部署常采用多进程 Worker 架构(如 Gunicorn 的 pre-fork 模式)。很多开发者容易犯的错误是在父进程中创建全局连接池,然后 fork 出多个子进程。由于操作系统 fork 后的文件描述符(Socket)与内存空间是复制或写时共享的,多进程共享同一批 Socket 会引发严重的数据交织与协议解析崩溃。
正确姿势:连接池必须在各个子进程内部独立初始化。在 Gunicorn 中,应确保连接池初始化延迟在子进程启动后的钩子(如 post_fork)或每个子进程首次接受请求时执行。
六、配置规范与运维检查清单总结
将 Python 与 MySQL 连接池配置妥当,是支撑中大型并发访问的基石。在上线生产前,可通过下述检查清单核对各项系统设定:
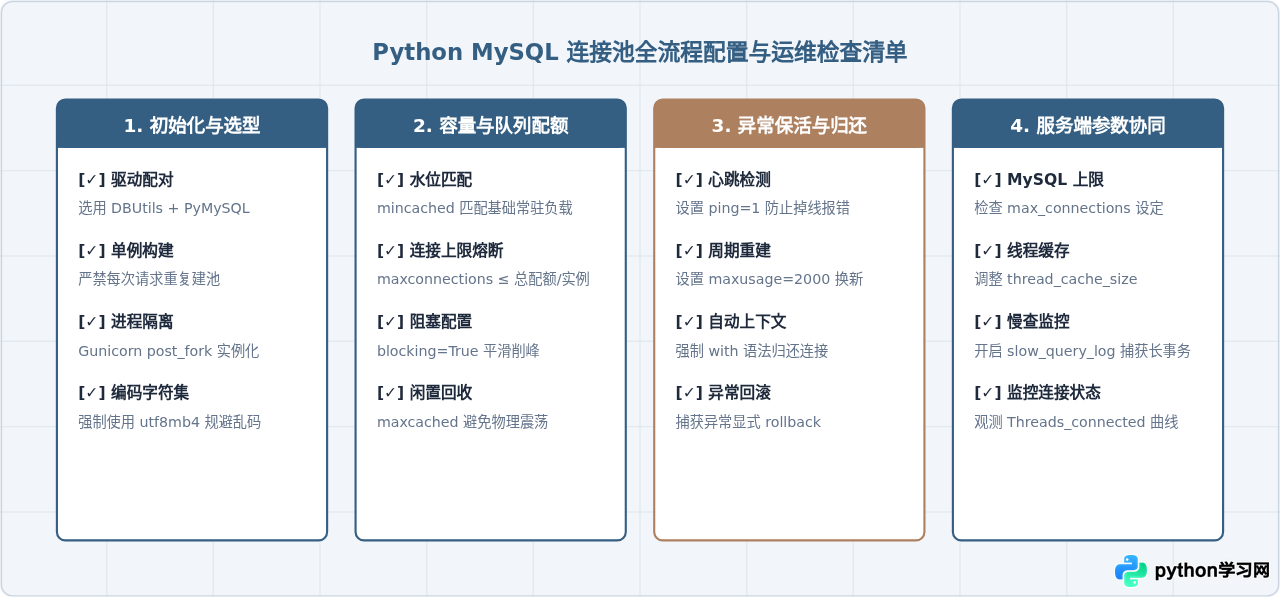
通过规范建立连接池单例、配置合理的动态水位、利用上下文管理器强制归还并开启透明心跳检测,Python 应用在应对大规模并发查询时不仅可以抹除反复建立连接的巨大开销,更能确保数据库在流量洪峰下平稳可控地运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









