Python寻找最长非重复子串算法解析
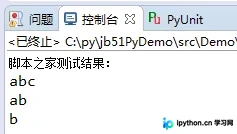
本文介绍Python中查找给定字符串最长非重复子串的两种思路。重点解析基于滑窗切片与排序统计的第二种方法,通过生成所有子串切片并利用Counter进行频率统计,最终筛选出出现次数最多的子串。代码包含完整实现及针对abcabcd等案例的测试输出,适合Python初学者与算法爱好者参考。
2026-10-12
6
本文介绍Python中查找给定字符串最长非重复子串的两种思路。重点解析基于滑窗切片与排序统计的第二种方法,通过生成所有子串切片并利用Counter进行频率统计,最终筛选出出现次数最多的子串。代码包含完整实现及针对abcabcd等案例的测试输出,适合Python初学者与算法爱好者参考。
本文总结了Python中读取TXT文件的三种常用方法。通过示例代码展示了如何使用open函数结合readline逐行读取、利用for循环迭代文件对象,以及使用readlines一次性加载所有行。同时介绍了处理多列数据及路径选择的技巧,帮助开发者根据实际需求选择高效的文件读取方案。
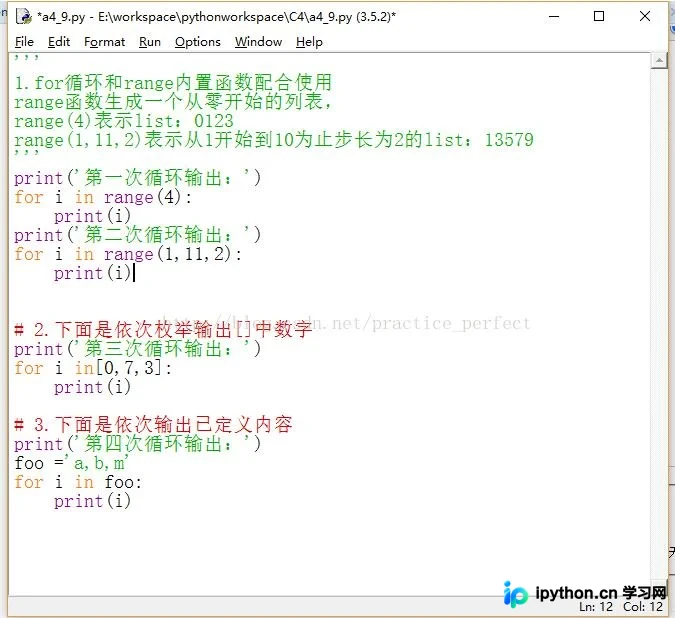
本文详细解析Python中for循环与range内置函数的配合使用方法。通过具体示例说明range生成从零开始的列表机制,涵盖单参数、双参数及三参数(含步长)的不同用法,并展示如何枚举输出列表元素及自定义内容,帮助读者掌握基础循环逻辑。
本文详细介绍Python中文件的读取与写入操作。内容涵盖读取整个文件、逐行读取(含指针机制说明)、使用readline和readlines方法,以及写入数据时的‘w’(覆盖)和‘a’(追加)模式。通过具体代码示例解析文件指针位置对读取结果的影响,帮助开发者掌握文件IO核心技能。
本文介绍在 Python 中于字符串指定位置插入字符的实用技巧。通过将字符串转换为列表,利用 index 定位目标字符并调用 insert 方法插入新字符,最后重新拼接为字符串。该方法适用于需要在文件行末或特定分隔符前添加逗号等场景,代码简洁且易于理解。
本文介绍如何利用TensorFlow实现Lasso和岭回归算法。通过在线性回归损失函数中引入正则项,分别使用L1范数(Lasso)和L2范数(Ridge)限制系数影响。文章提供完整代码示例,展示基于Iris数据集的训练过程、参数更新及损失收敛情况,帮助开发者掌握正则化技术。
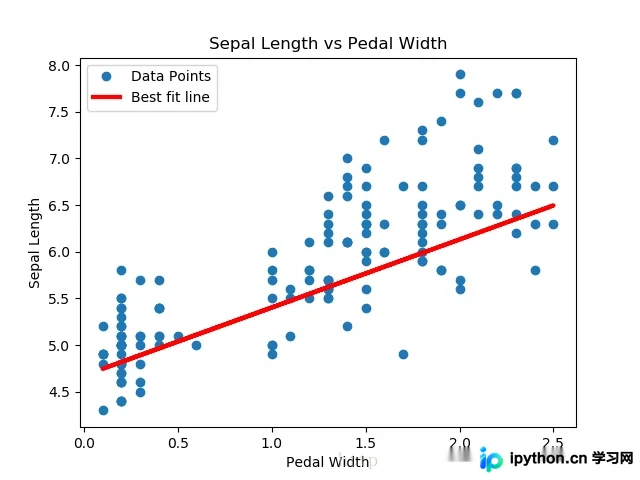
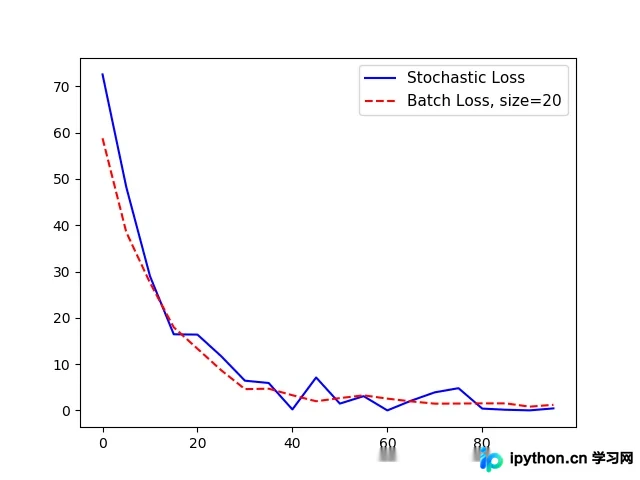
本文详解TensorFlow中随机训练与批量训练的实现机制。通过回归模型示例,对比两种方法在梯度计算、收敛速度及计算成本上的差异。随机训练利用单样本更新,易脱离局部最小但迭代次数多;批量训练取平均损失,收敛快但资源消耗大。代码展示如何扩展回归算法并可视化损失变化。
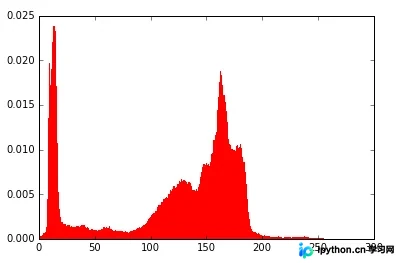
本文详解Python中利用skimage和numpy进行数字图像直方图处理的方法。涵盖histogram函数的参数与返回值、matplotlib绘制直方图的常用参数及代码示例,以及RGB三通道直方图的叠加绘制。重点解析直方图均衡化原理及其通过exposure.equalize_hist实现图像对比度增强的完整流程与代码。
本文详解Python代码缩进机制,说明其如何通过缩进而非括号定义代码块,并对比Java/C++差异。重点解析利用[[wp:a2]]判断模块运行状态的测试技巧,阐述直接运行与导入时[[wp:a3]]属性的变化,帮助开发者高效调试模块。
本文介绍使用Python批量合并多个txt文件的实现方法。通过遍历指定目录下的所有文本文件,逐行读取内容并写入目标文件,最终实现文件内容的合并。代码示例展示了核心逻辑,包括路径获取、文件遍历及写入操作,适用于需要整合多个文本数据的场景。
本文介绍如何使用Python脚本自动生成Caffe所需的train_list.txt文件,并详细解析os模块在文件重命名、读写、目录管理及路径处理中的核心用法。涵盖open模式、文件读写方法、文件夹创建删除、路径拼接及系统命令执行等实用技巧,辅助深度学习数据预处理。
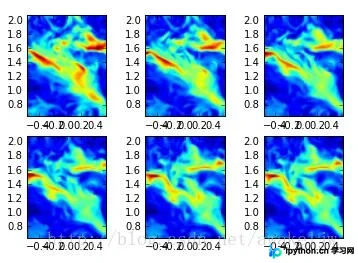
本文详解利用Python进行批量文件处理及科学计算的方法。通过os模块实现DAT文件批量转换为逗号分隔的CSV格式,确保数据可读性。结合Numpy、Pandas进行数据提取与处理,并使用Matplotlib进行多维数据可视化绘图,展示Python在科学计算领域的强大功能与便捷性。