

Python寻找最长非重复子串算法解析

发布时间:2026-10-12| 3人浏览过
本文介绍Python中查找给定字符串最长非重复子串的两种思路。重点解析基于滑窗切片与排序统计的第二种方法,通过生成所有子串切片并利用Counter进行频率统计,最终筛选出出现次数最多的子串。代码包含完整实现及针对abcabcd等案例的测试输出,适合Python初学者与算法爱好者参考。
本文详细介绍一种在Python中查找给定字符串最长非重复子串的实现方案,供读者参考学习。
问题描述:
输入一个字符串,目标是找出其中出现频率最高的重复子序列。若字符串由单一字符组成(例如“aaaaaaaaaaaaa”),则结果应返回该单个字符“a”。
解题思路:
本文提出两种可行的解决思路:
(1)遍历法:从字符串头部开始遍历并设置标志位,后续字符若与之前的标志位重合,则回溯检查当前子串是否与已记录的字符串或其子串相同。若相同,则记录该子串并将计数器加1,直至遍历结束。
(2)滑窗切片法:利用滑窗机制生成所有可能的子串切片,随后进行统计处理。该方法主要依赖两次排序操作来完成筛选。
本文采用第二种滑窗切片法,具体代码实现如下:
#!usr/bin/env python
#encoding:utf-8
'''''
__Author__:沂水寒城
功能:给定一个字符串,寻找最长重复子串
'''
from collections import Counter
def slice_window(one_str,w=1):
  '''''
  滑窗函数
  '''
  res_list=[]
  for i in range(0,len(one_str)-w+1):
    res_list.append(one_str[i:i+w])
  return res_list
def main_func(one_str):
  '''''
  主函数
  '''
  all_sub=[]
  for i in range(1,len(one_str)):
    all_sub+=slice_window(one_str,i)
  res_dict={}
  #print Counter(all_sub)
  threshold=Counter(all_sub).most_common(1)[0][1]
  slice_w=Counter(all_sub).most_common(1)[0][0]
  for one in all_sub:
    if one in res_dict:
      res_dict[one]+=1
    else:
      res_dict[one]=1
  sorted_list=sorted(res_dict.items(), key=lambda e:e[1], reverse=True)
  tmp_list=[one for one in sorted_list if one[1]>=threshold]
  tmp_list.sort(lambda x,y:cmp(len(x[0]),len(y[0])),reverse=True)
  #print tmp_list
  print tmp_list[0][0]
if __name__ == '__main__':
  print "本站测试结果:"
  one_str='abcabcd'
  two_str='abcabcabd'
  three_str='bbbbbbb'
  main_func(one_str)
  main_func(two_str)
  main_func(three_str)
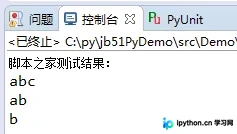
运行结果如下:
如需了解更多Python相关知识,可参考本站系列教程:《Python字符串操作技巧汇总》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》。
希望本文所述内容能对大家的Python程序设计有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









