


使用Scrapy框架爬取虎扑网页数据并存储至MySQL实战
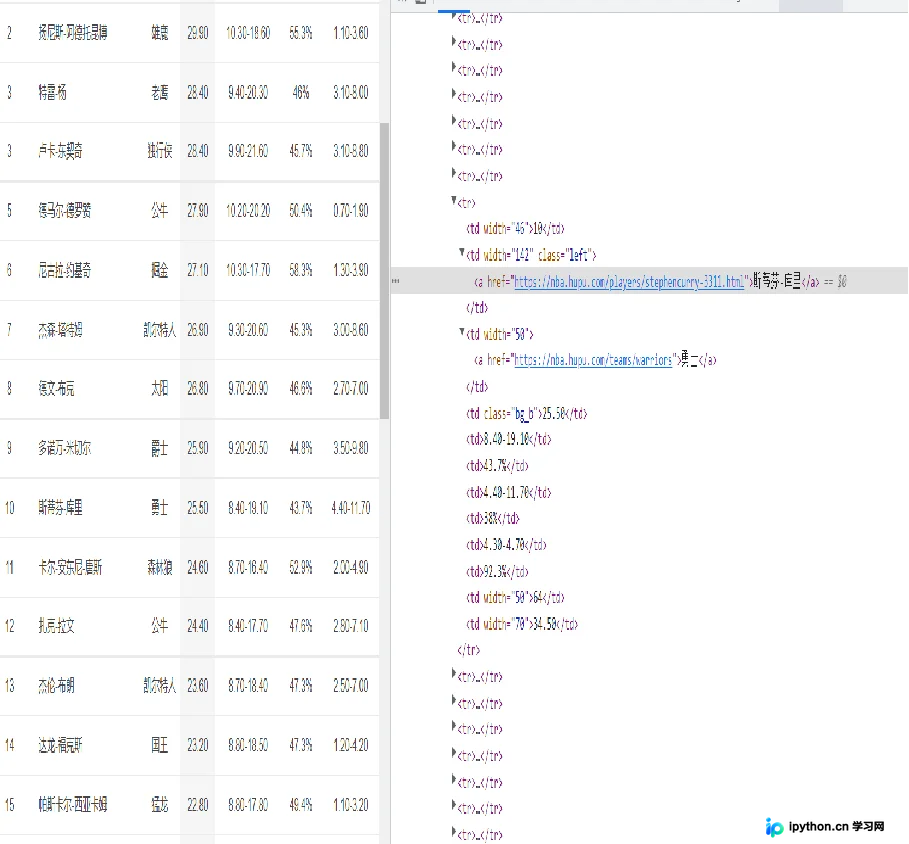
本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
2026-10-12
6
本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
在Python开发中处理文本数据或接口响应时,常需将单引号统一转为双引号。针对字符串类型可直接调用 replace 方法实现字符替换;针对字典对象则推荐通过 json.dumps 序列化为标准JSON格式。本文提供具体代码示例、参数说明及避免转义字符的引号嵌套实践。
针对Python中正则表达式如何精准提取和匹配中文汉字的问题,本文提供两种主流实现路径。通过调用内置re模块,分别采用Unicode标准编码范围与直写字面量区间的方式,配合findall函数过滤混合文本中的非中文字符。代码已适配Python 3环境,附带完整示例与参数解析,可直接复制用于爬虫清洗或数据校验场景。

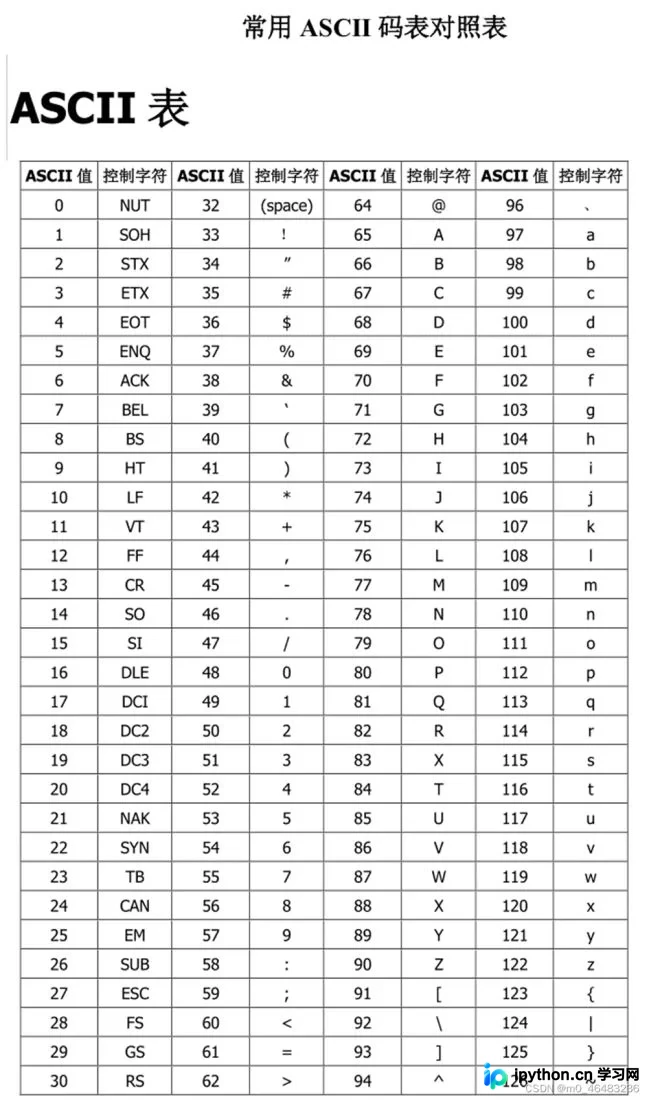
详细解析Python内置函数ord()的核心用法,涵盖字符转ASCII及Unicode数值的转换原理。通过基础对照与实战案例,演示如何结合ord()实现滑动窗口算法,高效解决字母异位词统计问题,助力掌握字符串编码处理与高频次数组构建的实战技巧。
本文系统整理了Python中提升编码效率的单行代码与语法简写技巧。通过条件语句压缩、列表推导式、变量并行赋值及海象运算符等实战案例,演示如何将繁琐的多行逻辑转化为紧凑且可读性强的代码。掌握这些方法有助于加快脚本编写速度,优化内存占用,并写出更符合Pythonic风格的程序。
在Python开发中常需从接口响应中提取指定字段。本文演示如何通过标准库解析字符串与字典型JSON,并提供自定义递归路径查找函数,用于快速定位嵌套结构中的目标数据,适用于接口调试、字段校验及数据过滤等常见业务场景。
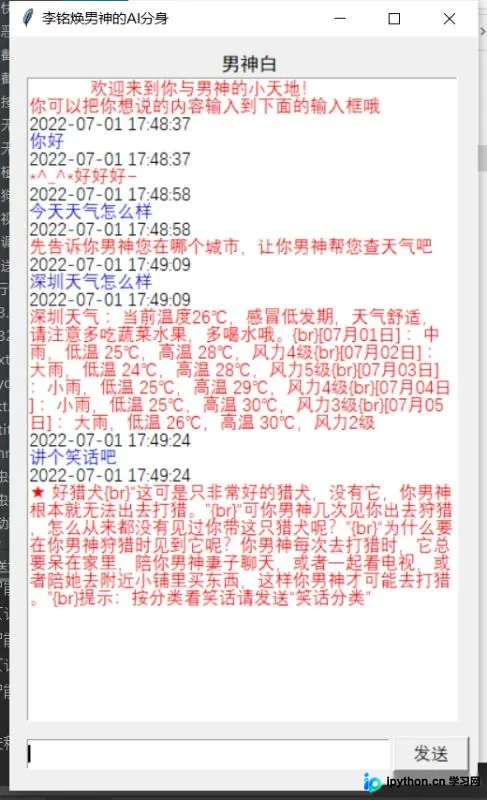
介绍使用Python标准库tkinter搭建桌面聊天窗口,通过读取本地TXT文件实现关键词自定义回复,并接入青云客免费API完成智能对话。附带完整可运行代码、依赖安装及运行参数说明。
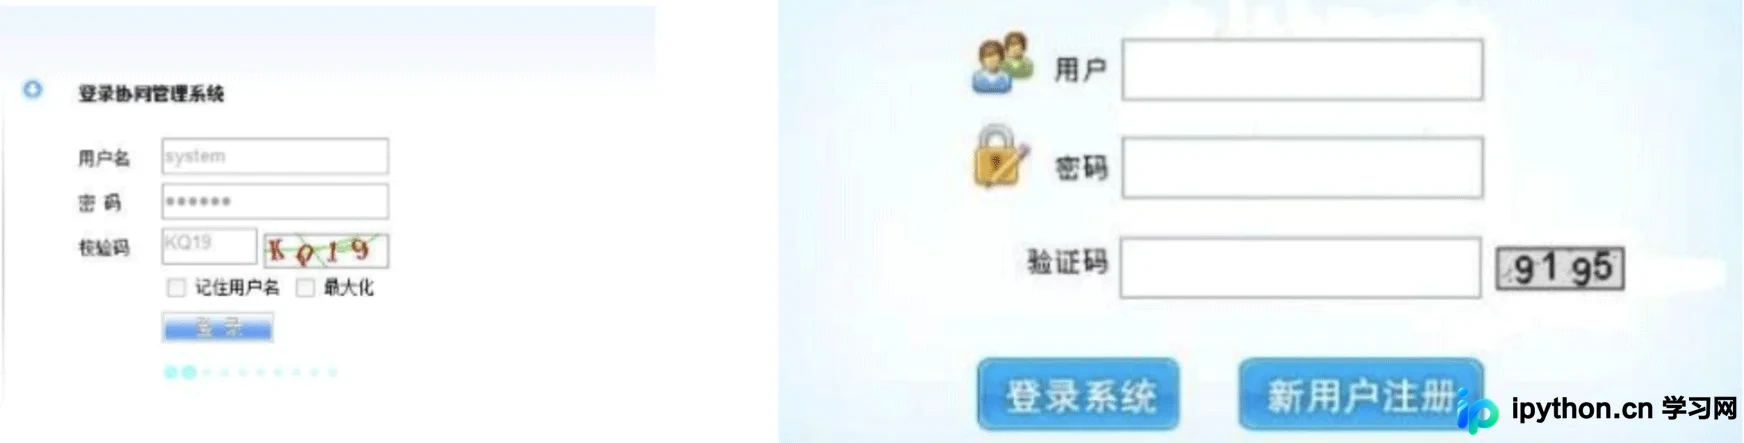
针对Web自动化测试中频繁弹出的图文验证码难题,常规策略包括关闭验证、预留万能码、Cookie注入或直接调用第三方打码平台。若需本地自主识别,可借助Python的Selenium获取页面坐标,配合PIL库进行像素级色彩过滤,最后接入Tesseract OCR引擎还原字符内容。该方法无需联网付费,稳定可靠,适合私有化测试环境的高效拦截与复用要求。
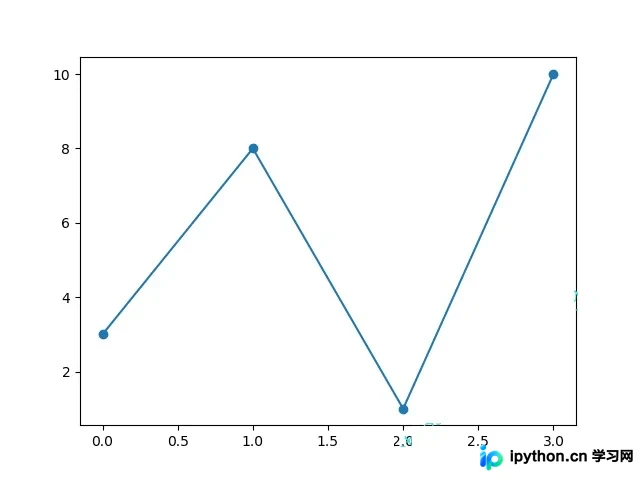
在Python Matplotlib数据可视化中,如何灵活控制折线图或散点图上的数据点样式是提升图表可读性的关键。本文详细解析marker核心参数、快捷格式字符串语法,以及如何通过ms、mec和mfc精确调整标记的大小、边缘与填充颜色,附带完整代码示例与参数对照表,助您快速实现定制化绘图。
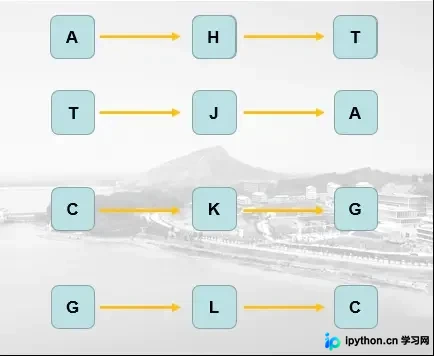
本文详细解析如何在Python中准确计算已知DNA模板的互补序列。针对初学者常见的replace()方法导致的数据覆盖问题,提供一种利用大小写特性与临时占位符的安全替换方案,并附完整可运行代码及结果验证,帮助快速掌握字符串处理技巧。
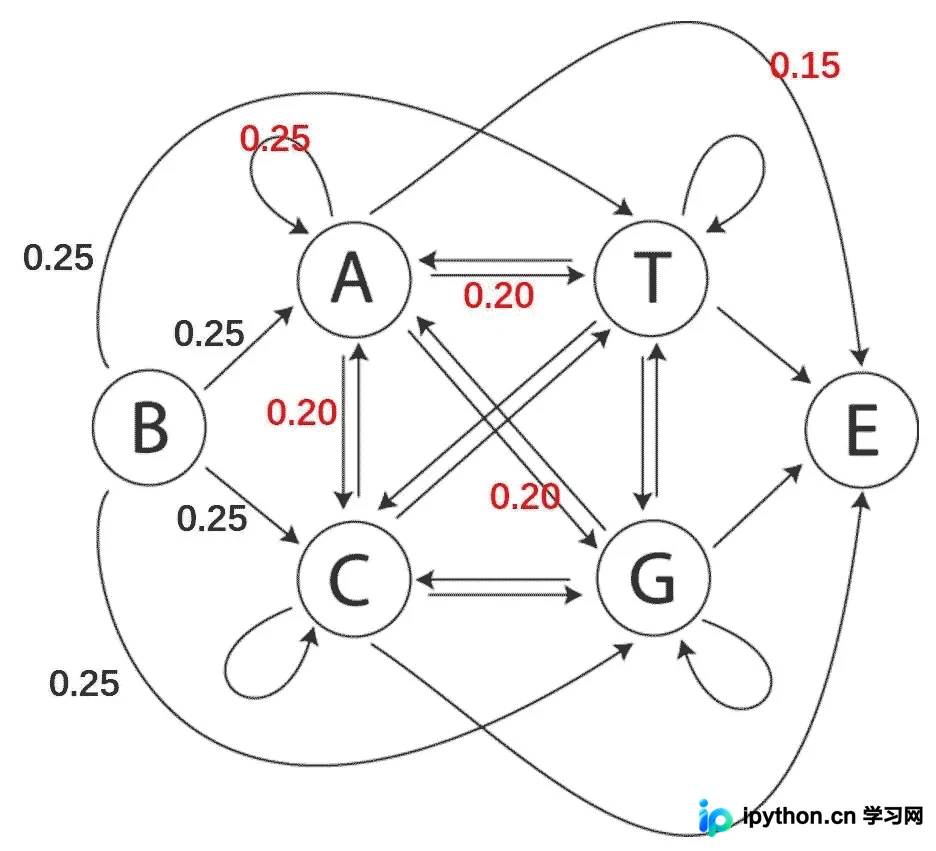
本文介绍如何在Python中利用一阶马尔科夫链生成随机DNA序列。通过设定碱基转移概率矩阵,结合numpy和random模块模拟序列演化过程,并统计长度分布。代码可直接运行于Jupyter Notebook,支持自定义序列数量和概率参数,适合生物信息学中的序列建模需求。
针对GenBank格式(GBFF)文件中复杂的条目结构,本文详解如何通过Python逐行定位特征表与碱基序列区域。提供完整的代码逻辑,自动过滤非CDS注释,精准截取对应位置的核苷酸片段,并批量输出为标准FASTA格式,适用于本地自动化处理基因组数据。