

Python中scipy.stats.norm正态分布函数的使用指南

scipy.stats.norm 是 Python SciPy 库中用于模拟和操作正态分布(高斯分布)的核心工具。通过该模块可轻松计算概率密度、累计分布、分位点及生成符合特定均值与标准差的随机样本,广泛应用于数据统计分析与算法验证环节。
scipy.stats.norm 函数概述与公式原理
scipy.stats.norm 用于实现连续型正态分布的概率计算。其标准概率密度函数(PDF)数学表达式为:
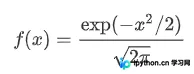
在代码调用中,norm.pdf(x, loc, scale) 的计算逻辑等效于先将原始值归一化:y = (x - loc) / scale,再代入标准正态分布密度函数除以尺度参数,即 norm.pdf(y) / scale。其中 loc 对应分布的均值(mean),scale 对应标准差(standard deviation)。
核心调用方法与操作步骤
第1步:安装必要依赖库
执行该功能需提前配置好数据分析环境。若尚未安装相关包,可在终端或 Notebook 中运行以下命令:
pip install scipy numpy matplotlib第2步:选择 API 风格生成概率分布图
SciPy 提供了两种等效的调用路径,可根据代码可读性需求自由选择:
- 实例化冻结分布(Frozen Distribution):先固定
loc和scale生成对象,后续直接对对象调用.pdf()等方法。适合需要在多处复用同一分布参数的场景。 - 直接类方法调用:不创建中间对象,每次调用时显式传入参数。适合一次性计算或参数频繁变动的场景。
配合 matplotlib 可直观验证两种方式的输出一致性,并同步观察概率密度曲线与随机抽样数据的区别。示例代码如下:
from scipy import stats
import numpy as np
import matplotlib.pyplot as plt

plt.figure(figsize=(12, 8))
x = np.linspace(-5, 5, num=20)

# 第1种调用方式:冻结分布状态
gauss1 = stats.norm(loc=0, scale=2)  # loc控制均值(mean),scale控制标准差(std)
gauss2 = stats.norm(loc=1, scale=3)
y1 = gauss1.pdf(x)
y2 = gauss2.pdf(x)

plt.subplot(2, 2, 1)
plt.plot(x, y1, color='orange', label='μ=0,σ=2')
plt.plot(x, y2, color='green', label='μ=1,σ=3')
plt.legend(loc='upper right')

# 第2种调用方式:直接调用类方法
gauss2_sub = plt.subplot(2, 2, 2)
y1_direct = stats.norm.pdf(x, loc=0, scale=2)
y2_direct = stats.norm.pdf(x, loc=1, scale=3)

plt.plot(x, y1_direct, color='red', label='μ=0,σ=2')
plt.plot(x, y2_direct, color='blue', label='μ=1,σ=3')
plt.legend(loc='upper right')

# 对比 rvs(随机抽样)与 pdf 的输出差异
# 子图3:未排序的随机样本
plt.subplot(2, 2, 3)
y1_rvs = stats.norm.rvs(loc=0, scale=2, size=20)
y2_rvs = stats.norm.rvs(loc=1, scale=3, size=20)
plt.plot(x, y1_rvs, color='black', linestyle=':', label='μ=0,σ=2')
plt.plot(x, y2_rvs, color='purple', label='μ=1,σ=3')
plt.legend(loc='upper right')

# 子图4:排序后的随机样本
plt.subplot(2, 2, 4)
y1_sorted = sorted(stats.norm.rvs(loc=0, scale=2, size=20))
y2_sorted = sorted(stats.norm.rvs(loc=1, scale=3, size=20))
plt.plot(x, y1_sorted, color='black', linestyle=':', label='μ=0,σ=2')
plt.plot(x, y2_sorted, color='purple', label='μ=1,σ=3')
plt.legend(loc='upper right')

plt.tight_layout()
plt.show()
第3步:确认运行结果与参数含义
上述脚本将生成包含四个子图的可视化面板。左侧两幅子图展示的是 stats.norm.pdf 的连续概率密度分布曲线,右侧两幅子图展示的是 stats.norm.rvs 提取的离散随机变量样本。其中 rvs(random variates)表示从目标分布中抽取的具体数值,而非密度曲线。
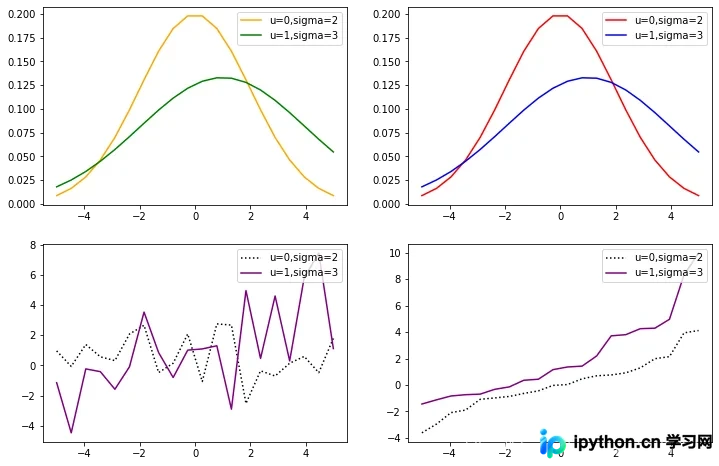
当使用冻结分布对象时,控制台打印该对象会返回类似 <scipy.stats._distn_infrastructure.rv_frozen object at ...> 的内部标识。调用 stats.norm.rvs(loc=0, scale=2, size=10) 则会直接返回一组符合 N(0, 2²) 分布的浮点数列表,可用于后续蒙特卡洛模拟或分布检验。
stats.norm 核心公共方法对照
rvs(loc, scale, size):生成服从该正态分布的随机样本数组。pdf(x, loc, scale):计算指定位置的概率密度值(Probability Density Function)。cdf(x, loc, scale):计算累计分布函数,返回X ≤ x的累积概率。sf(x, loc, scale):计算残存函数,结果为1 - CDF,常用于处理极左尾的高精度计算。ppf(q, loc, scale):分位数函数(CDF 的反函数),输入概率值返回对应的横坐标临界点。isf(q, loc, scale):逆残存函数(SF 的反函数),等价于ppf(1-q)。stats(loc, scale, moments):批量返回统计特征,moments参数可组合使用m(均值)、v(方差)、s(偏度)、k(峰度)。moment(n, loc, scale):计算指定阶数的非中心矩。
总结
掌握 scipy.stats.norm 的两种调用范式及其核心统计方法,能够显著提升 Python 环境下分布建模与假设检验的开发效率。注意区分连续密度计算(pdf/cdf/ppf)与离散抽样(rvs)的应用边界,即可准确支撑各类统计分析任务。以上就是scipy.stats.norm正态分布函数使用指南的详细内容,更多关于Python统计学与数据分析的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









