Spark NLP库在PySpark中的安装与预训练模型使用指南
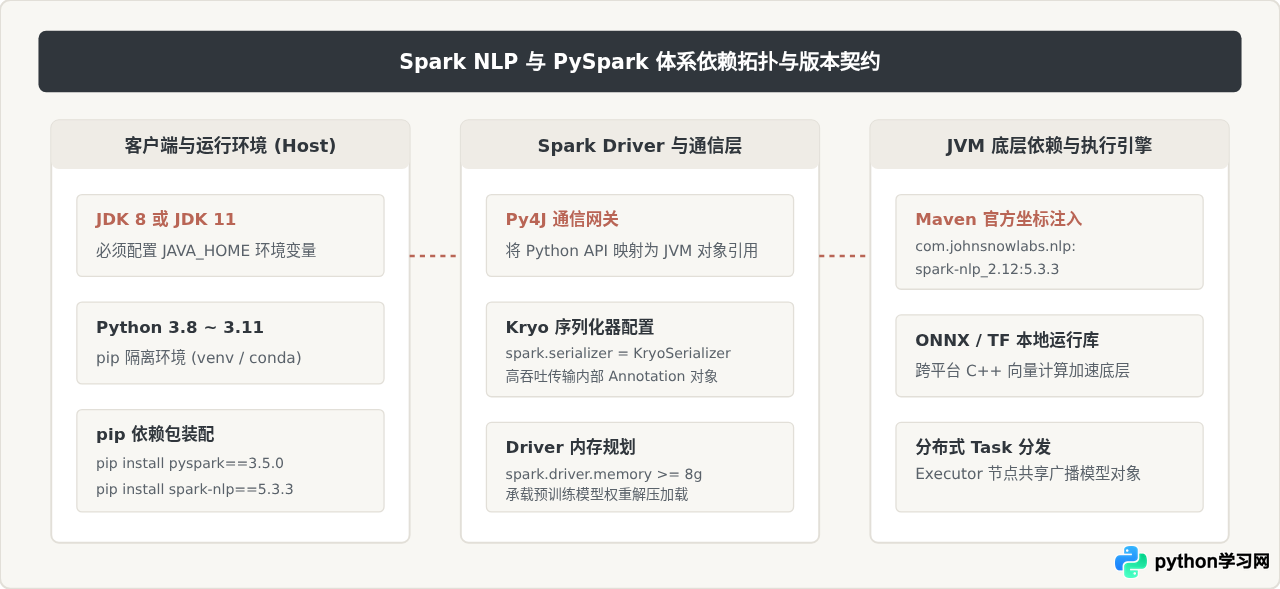
系统解析在PySpark环境下安装配置Spark NLP库的完整流程,涵盖Java与Spark版本兼容性约束、SparkSession内存与Maven依赖注入、Pipeline注解器数据流转原理,以及在线与离线预训练模型的调用与故障排查实践。
2026-10-28
30
系统解析在PySpark环境下安装配置Spark NLP库的完整流程,涵盖Java与Spark版本兼容性约束、SparkSession内存与Maven依赖注入、Pipeline注解器数据流转原理,以及在线与离线预训练模型的调用与故障排查实践。
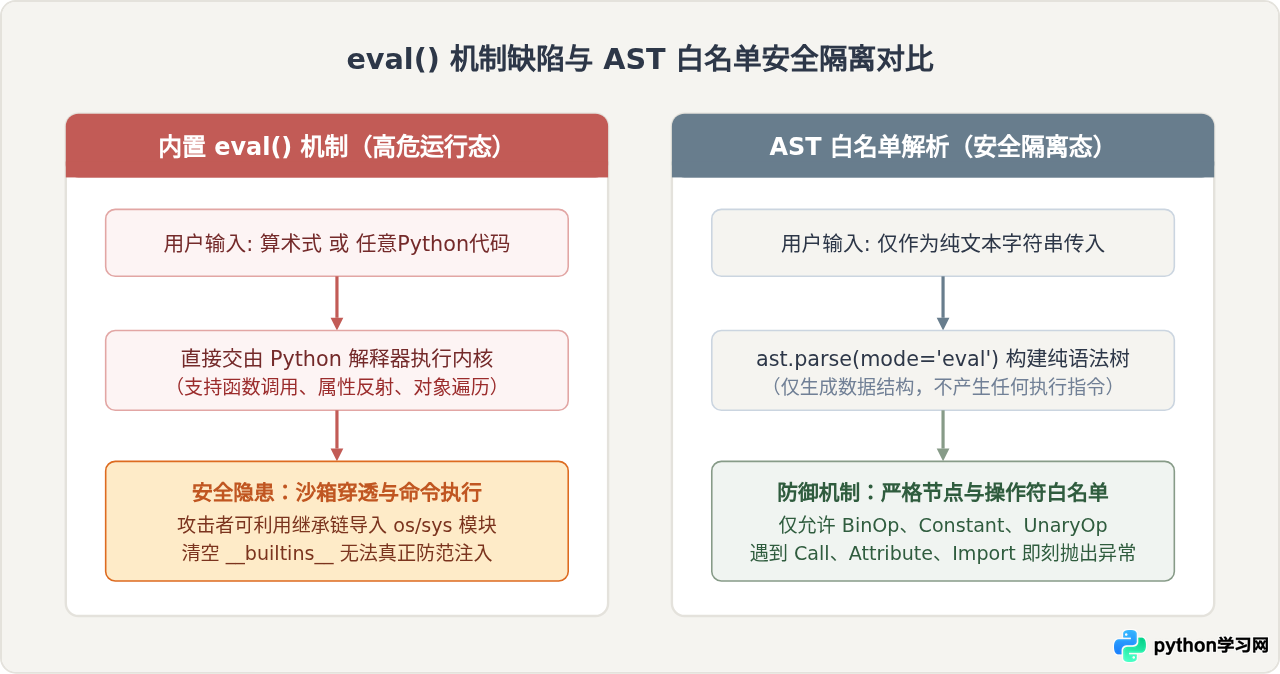
详细讲解在Python计算器中如何安全解析并计算数学表达式,避免使用危险的eval函数,基于标准库ast实现白名单求值与防代码注入方案。
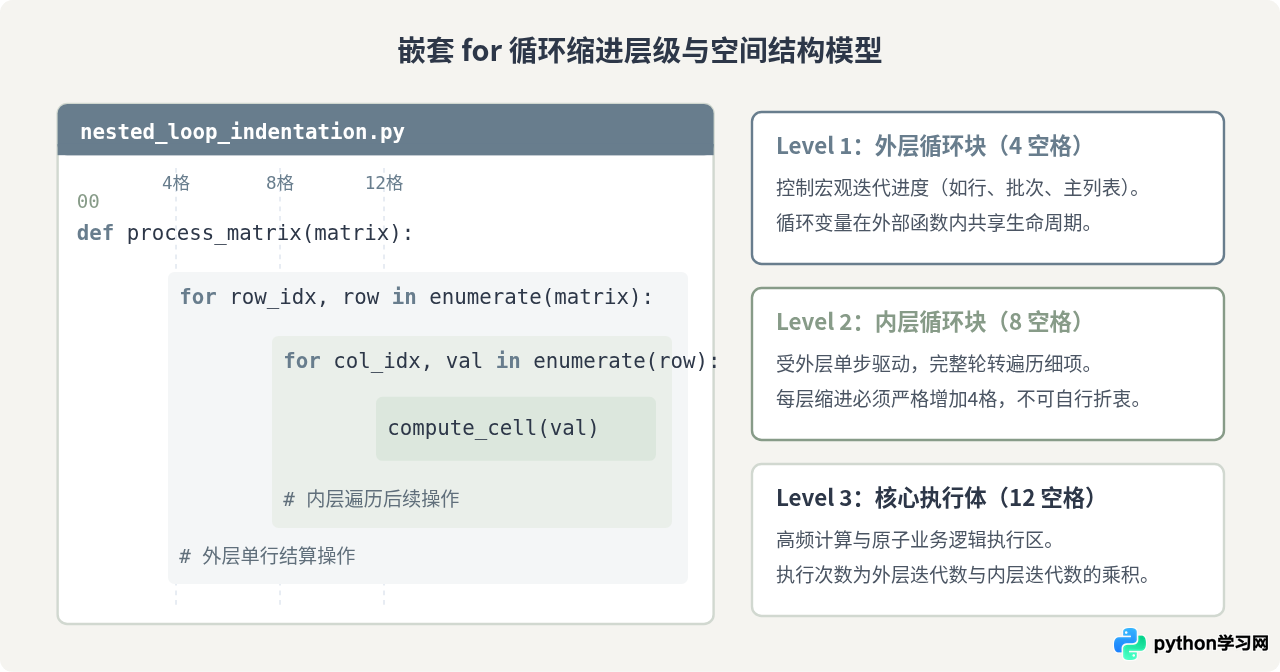
深入讲解 Python 嵌套 for 循环的缩进层级标准、执行控制流与作用域逻辑,提供降低代码圈复杂度与扁平化重构的具体规范与实用示例。
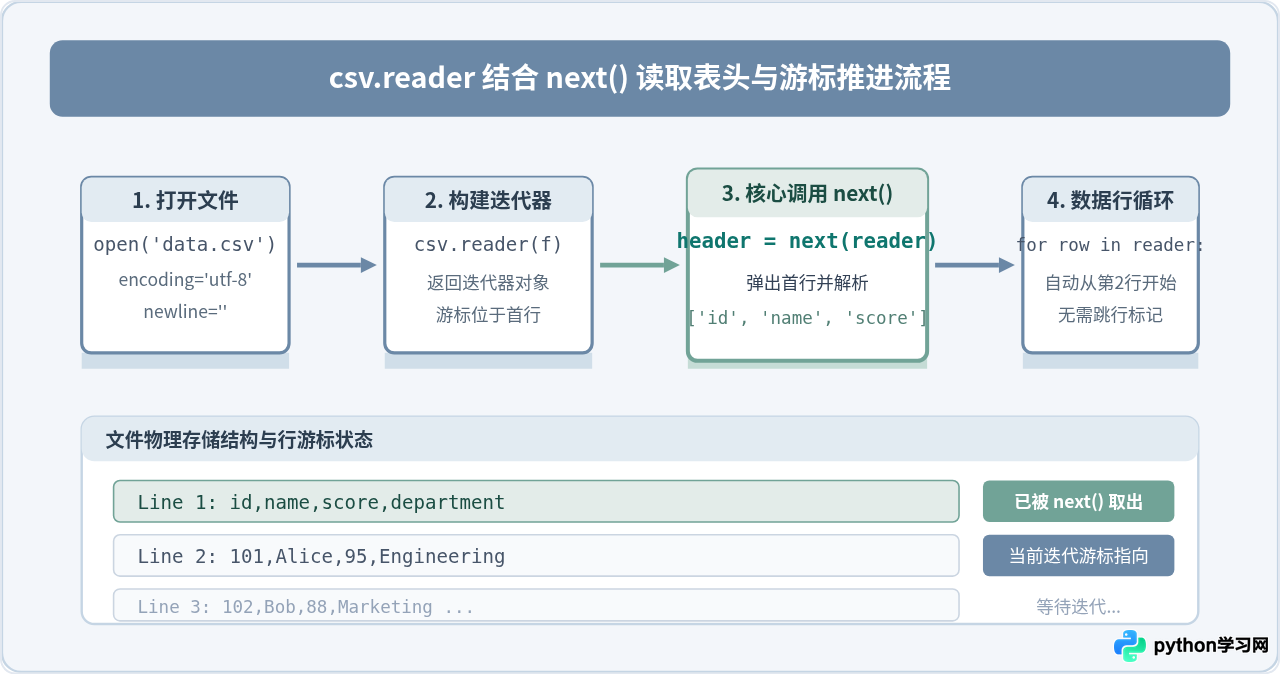
详细讲解在Python中使用内置csv模块读取CSV文件表头的标准方法,包括csv.reader配合next()函数与csv.DictReader读取fieldnames属性的具体用法、BOM编码与空文件防御处理及技术选型对比。
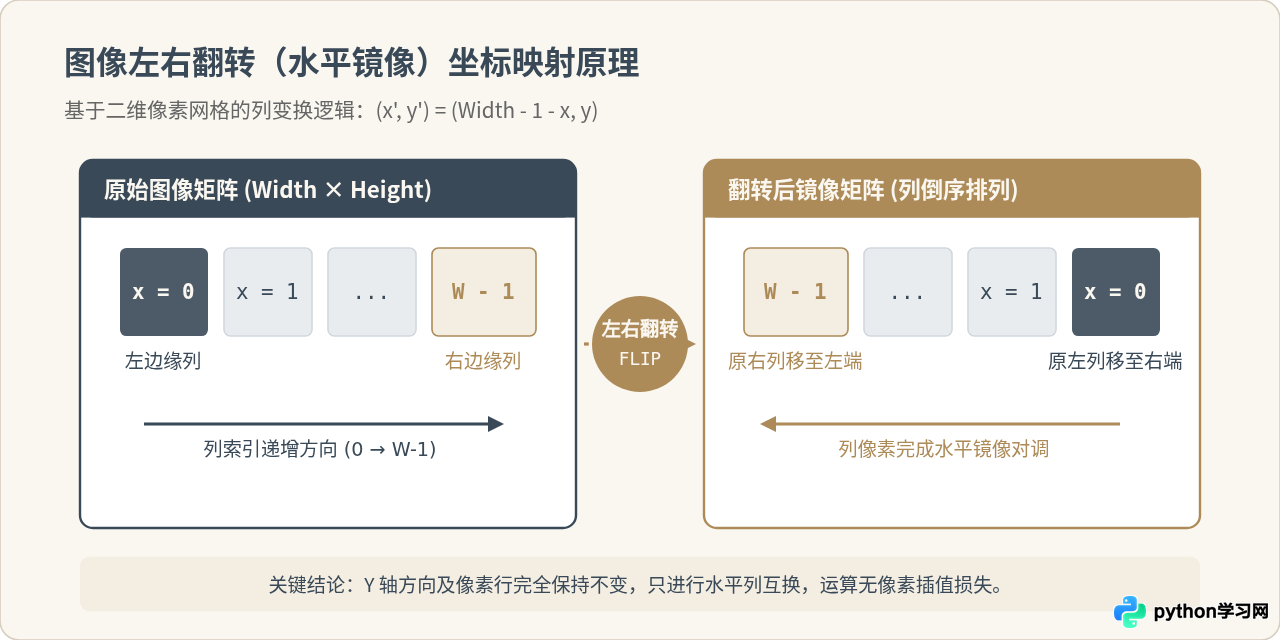
详细讲解在Python中使用Pillow(PIL)库实现图像左右水平翻转的完整方法,包含坐标变换原理、标准代码流程、EXIF方向校正、批量处理及避坑指南。
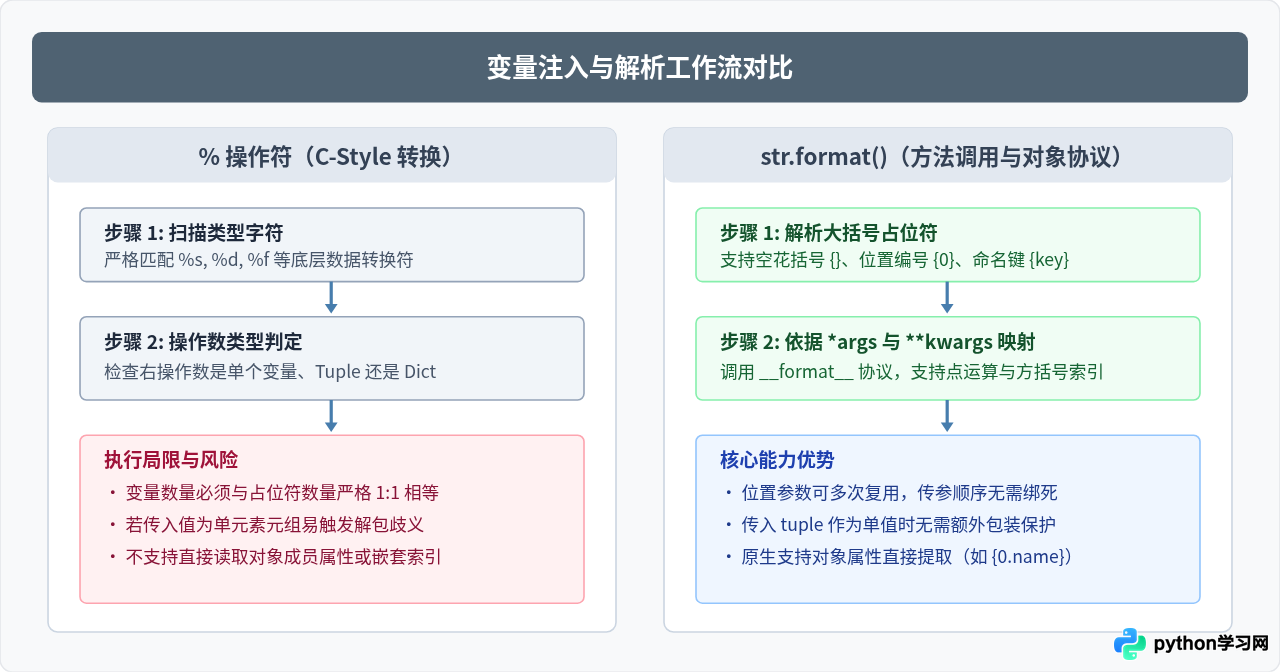
深入对比Python中str.format()与%操作符的核心语法、传参机制、陷阱与适用场景,帮助开发者准确选择最适合的字符串格式化方案。
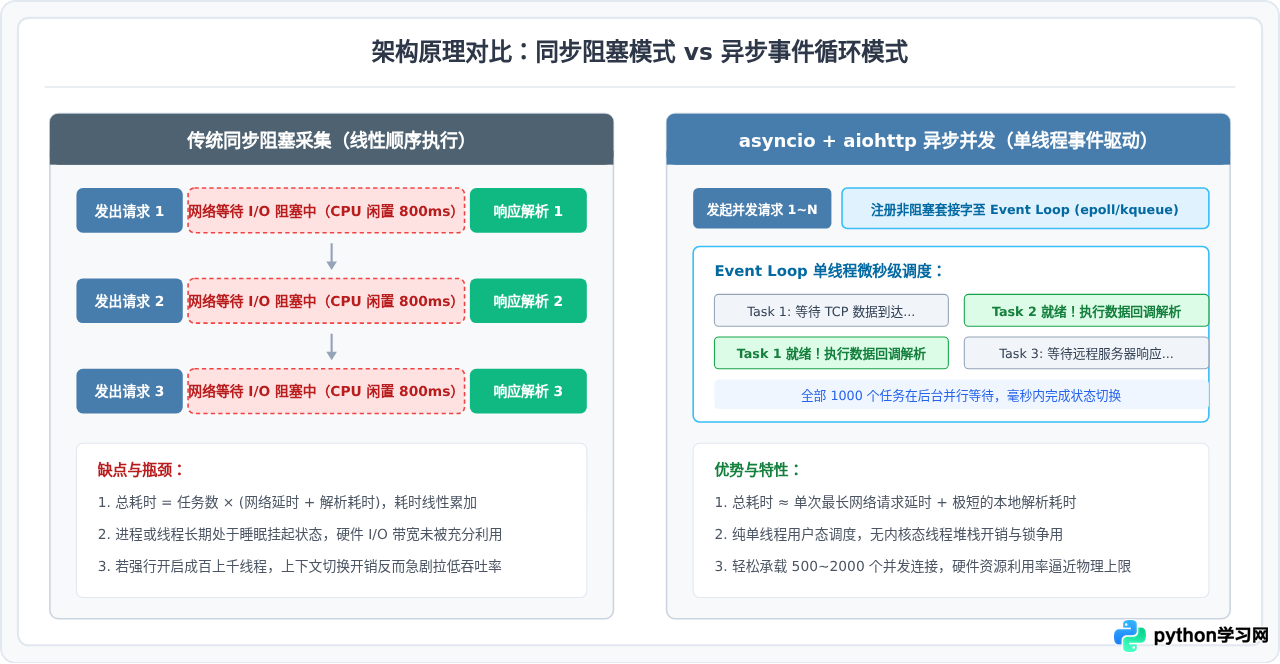
深入讲解如何基于Python的asyncio事件循环与aiohttp客户端构建生产级高性能异步爬虫,涵盖连接池复用、Semaphore并发限流、超时控制与异常容错最佳实践。
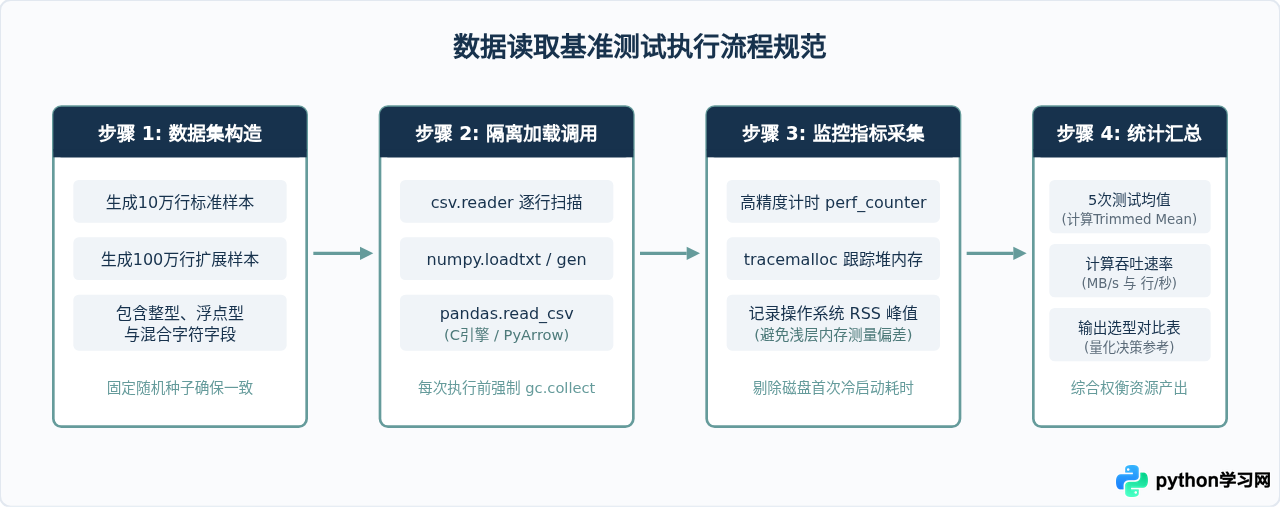
深入对比Python中内置csv模块、NumPy与Pandas读取结构化CSV数据的性能差异与底层机制,涵盖10万与100万行基准测试、内存开销剖析与工程选型建议。
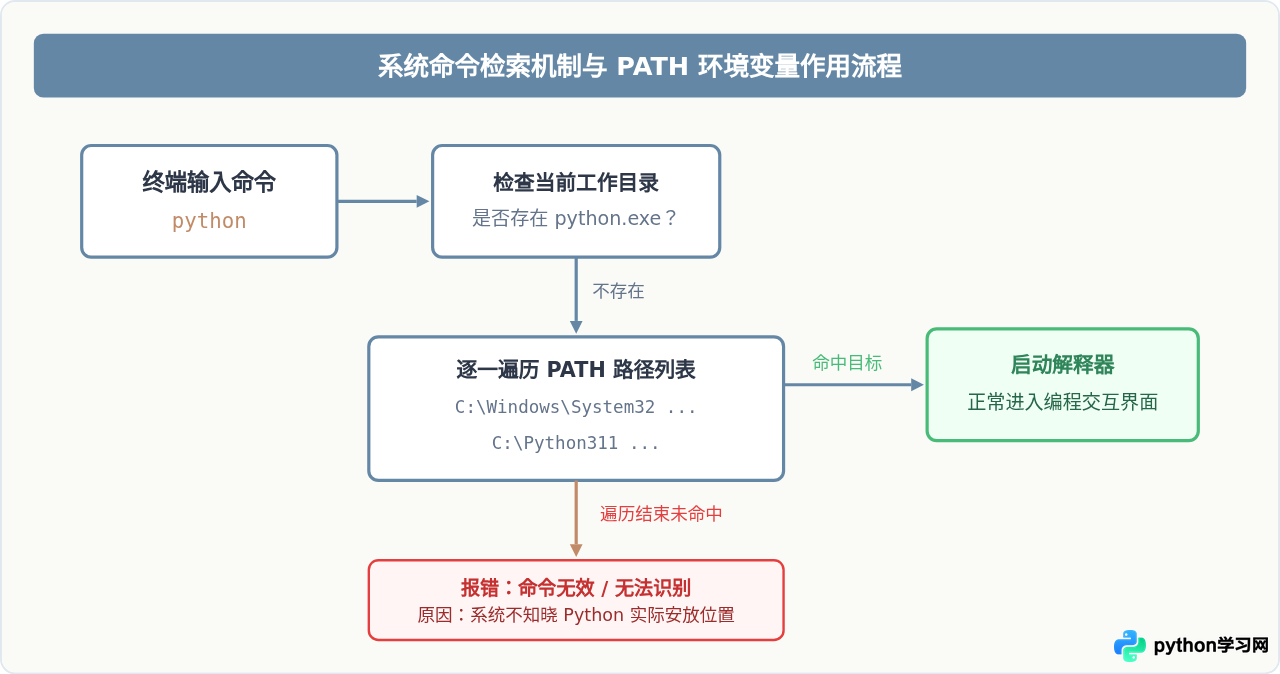
针对终端输入python提示命令无效或打开应用商店的常见故障,深入剖析PATH环境变量检索机理,提供Windows与macOS系统的清晰配置步骤与验证指南,助您顺利进入Python编程交互界面。
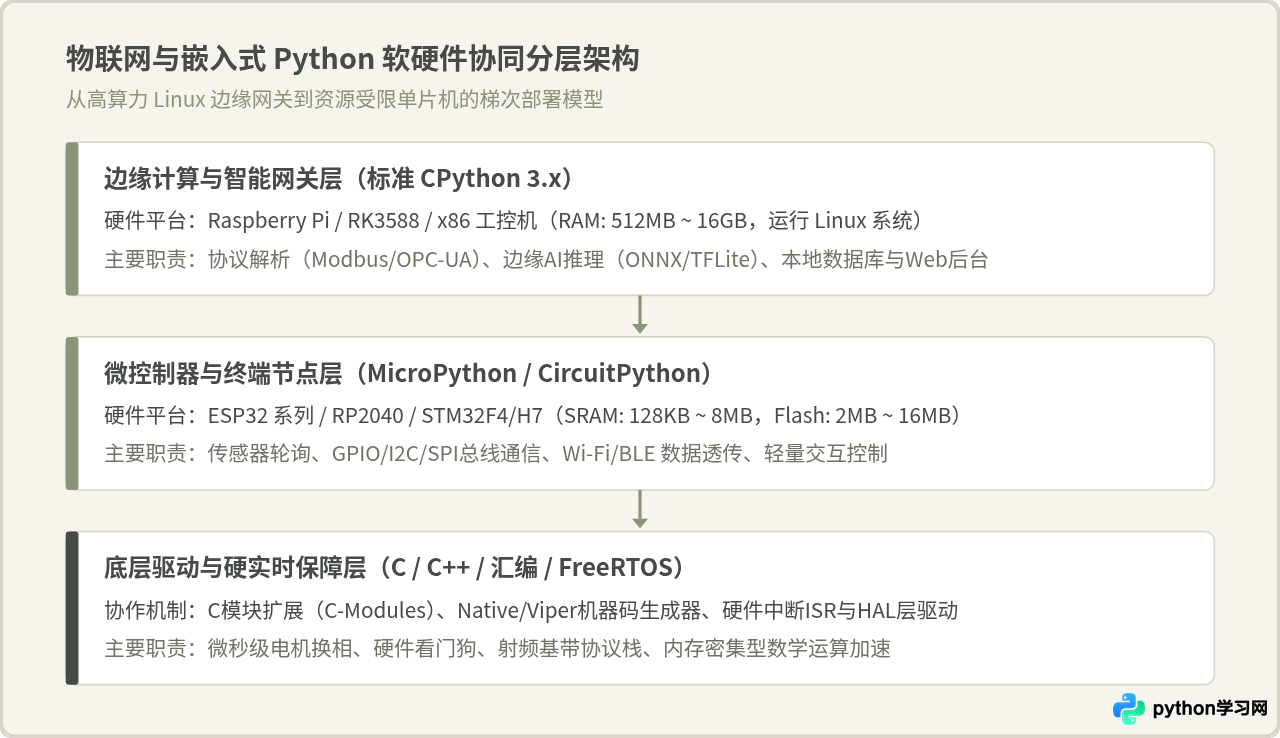
深入解析Python在物联网与嵌入式开发中的分层架构、主流实现路径、完整开发流程,并客观剖析其在内存碎片化、硬实时保障与功耗控制方面的核心挑战与应对策略。
详细讲解在 Visual Studio Code 中通过内置命令与终端创建、激活 Python 虚拟环境(venv),并规范管理第三方库的完整操作流程与排错方案。