

PyCharm创建并使用虚拟环境的详细图文教程
本文详细介绍在PyCharm中创建和使用虚拟环境的完整流程。涵盖通过Terminal安装virtualenv、使用virtualenv命令创建环境、以及两种激活方式:手动切换Scripts目录和使用PyCharm Settings界面配置解释器。通过图文步骤指导用户成功隔离项目依赖,确保开发环境纯净。
2026-10-15
26
本文详细介绍在PyCharm中创建和使用虚拟环境的完整流程。涵盖通过Terminal安装virtualenv、使用virtualenv命令创建环境、以及两种激活方式:手动切换Scripts目录和使用PyCharm Settings界面配置解释器。通过图文步骤指导用户成功隔离项目依赖,确保开发环境纯净。
本文介绍在pandas中修改DataFrame列名的两种主要方法:直接重新赋值columns属性和使用rename方法。重点解析rename方法中inplace参数的作用,演示未使用与使用该参数时的结果差异,并展示如何指定修改特定列名。
本文汇总了使用PyInstaller打包Python3.6及PyQt5程序时遇到的典型错误。针对api-ms-win-crt系列DLL缺失警告,建议将Anaconda目录下的相关文件复制到Python安装目录。对于打包后运行出现“failed to execute script”且控制台无输出的问题,可通过添加-c参数查看具体报错,若涉及PyQt5.sip模块缺失,需在打包命令中使用--hidden-import显式指定。
本文详细介绍pandas中DataFrame.rename()方法的使用。该方法用于更改行列标签(索引),支持传入字典或函数。文章解析了mapper、index、columns、axis、copy、inplace、level及errors等关键参数,并通过代码示例演示了如何修改行索引、列名以及处理多层索引和错误情况。
本文详解Python中正则表达式模块re的两个核心方法:re.match()与re.search()。通过对比语法、参数及实际代码示例,深入解析两者在匹配机制上的关键差异:re.match强制从字符串起始位置匹配,而re.search扫描全字符串。掌握这些区别有助于在开发中精准选择匹配策略,提高代码效率与准确性。
本文详细介绍 pandas 中 DataFrame.sample() 函数的用法,涵盖 n、axis、weights 和 frac 等关键参数。通过具体代码示例演示如何随机获取行、列、指定数量或按比例抽样,帮助开发者快速掌握数据随机采样技巧。
本文介绍如何使用Python将图片转换为ASCII字符画。核心步骤包括将图片转为灰度图,根据像素亮度映射到预设的ASCII字符集,并通过PIL库绘制或生成文本文件。文章提供了生成图像和纯文本两种方式的完整代码示例及参数调整方法。
本文深入解析pandas库中df.iloc[]索引器的核心用法。与df.loc[]基于标签不同,iloc[]严格依据数据在DataFrame中的位置坐标进行提取。文章详细说明了其支持的参数类型,包括整数、列表及切片操作,并通过具体代码示例展示了如何获取特定单元格、整行数据、子集以及实现行列倒序排列,帮助开发者高效进行数据筛选与处理。
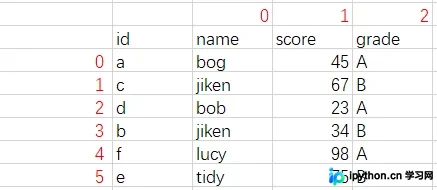
本文详解Python Pandas中dropna()方法删除特定行与列的参数用法,包括axis、how、thresh和subset。针对仅基于单列缺失值删除行的需求,提供通过fillna填充后索引定位删除的替代方案,帮助精准过滤数据。
本文详细介绍Python内置time标准库的核心功能,涵盖时间戳获取、本地时间解析、自定义时间格式字符串转换(strftime/strptime)、程序休眠及高精度性能计时方法。通过具体代码示例解析各函数返回值类型与应用场景,帮助开发者高效处理时间相关逻辑。
本文介绍pandas中round方法的使用,包括如何对数据框进行四舍五入保留指定小数位数。通过传入整数统一所有列精度,或传入字典对指定列分别设置精度,实现灵活的数据处理。
本文详细介绍Python pandas中处理缺失值的三种核心方法:删除含缺失值的样本或特征列,以及使用具体数值或前后值进行填充。通过dropna、drop和fillna函数的参数详解与代码示例,帮助开发者快速掌握数据清洗技巧。