OpenCV颜色空间转换详解:cv2.cvtColor()函数实战
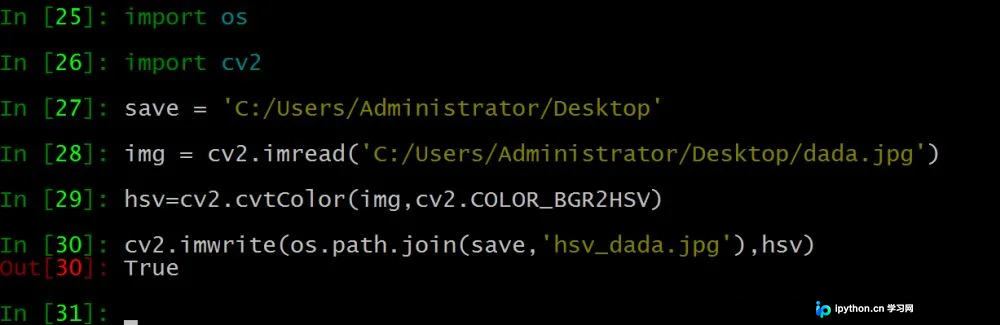
本文详细介绍OpenCV中cv2.cvtColor()函数的使用方法,涵盖RGB、HSV等8种常见色彩空间。重点讲解因OpenCV默认BGR格式导致的BGR2HSV转换细节,并通过示例展示其在生成Mask图及图像预处理中的应用,帮助开发者掌握色彩空间转换的核心技巧。
2026-10-15
25
本文详细介绍OpenCV中cv2.cvtColor()函数的使用方法,涵盖RGB、HSV等8种常见色彩空间。重点讲解因OpenCV默认BGR格式导致的BGR2HSV转换细节,并通过示例展示其在生成Mask图及图像预处理中的应用,帮助开发者掌握色彩空间转换的核心技巧。
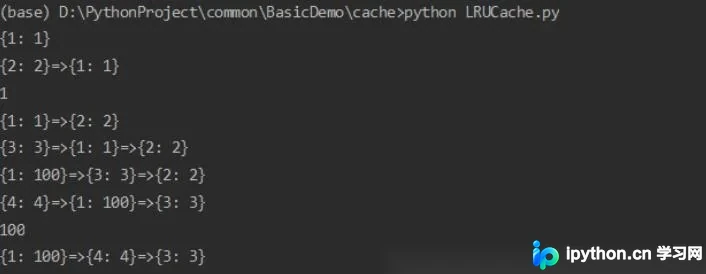
本文介绍如何使用Python基于双向链表和哈希表实现LRU(最近最少使用)缓存算法。通过get和put操作,结合DoubleLinkedList类与字典映射,实现O(1)时间复杂度的数据访问与更新。文章包含完整代码示例及测试逻辑,适用于Redis淘汰机制等场景的学习与参考。
本文详细介绍 pytest.ini 全局配置文件的使用方法。涵盖 addopts 自定义执行参数(如 -v, -s, --reruns)、testpaths 指定测试路径、markers 定义测试标记分组以及 python_files 修改文件匹配规则。通过具体代码示例解析命令行参数覆盖机制及标记用例执行方式,帮助开发者优化测试流程。
本文详细介绍Python中pickle模块的功能,涵盖dumps、loads、dump和load四个核心方法的使用示例。文章对比了pickle与JSON在格式、兼容性及安全性上的差异,并列举了可被序列化的数据类型。重点强调pickle处理非信任数据时的安全风险,建议开发者谨慎使用。
本文详细解析Python中pickle与json序列化模块的区别与应用。pickle支持Python所有数据类型并生成字节流,适用于Python内部数据持久化;json仅支持八种基础类型并生成字符串,适用于多语言间数据交换。文章涵盖dumps/loads与dump/load的使用场景、参数配置及连续读写问题的解决方案。
本文深入解析Python中multiprocessing模块的多进程实现方式,涵盖Process类重写run、target传参及直接调用三种用法。重点对比Queue与Pipe在进程间通信(IPC)中的性能差异与应用场景,并通过数据清洗、模型推理等实际案例,展示如何利用进程池与异步通信机制高效处理高并发任务。
本文深入解析Python中pickle与JSON两大标准库的序列化机制。详细对比两者在数据类型支持、编码格式及多语言兼容性上的差异,重点讲解dumps/loads与dump/load函数的使用场景。针对JSON连续读写报错问题提供解决方案,并阐述pickle在Python内部数据持久化与JSON在跨语言数据交互中的最佳实践。
本文介绍如何在Python中使用js2py库直接运行JavaScript代码。针对爬虫中常见的JS加密、混淆及动态接口返回JS变量等场景,详细讲解eval_js和EvalJs两种核心用法。通过提取JS对象属性和调用函数,实现从复杂JS代码中高效获取数据,解决传统正则或字符串解析的繁琐问题,满足90%日常爬虫需求。
本文介绍在Python中利用OpenCV库实现图片切割的具体方法。通过示例代码展示如何读取图像、计算行列尺寸并保存切割后的子图。同时对比了Pillow库可能存在的自动旋转问题,建议使用OpenCV以避免此类偏差。
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
本文详解如何利用Python的openpyxl和calendar库自动化生成个性化爱豆日历。通过处理Excel工作簿、设置单元格样式及插入图片,实现12个月份的自动排版与生成,帮助开发者快速掌握表格自动化处理技巧。
本文介绍在Python中使用Savitzky-Golay滤波器对高频波动曲线进行平滑处理的方法。通过scipy库调用savgol_filter函数,详细解析window_length和polyorder两个关键参数对拟合效果的影响。窗口长度决定平滑强度,多项式阶数影响拟合精度,合理设置参数可避免高频曲线失真或过度平滑。