

Python 解析非标准时间字符串的完整实现
本文介绍利用 Python 解析非标准时间字符串的方法,支持“今天”、“几天前”、“2017-1-4 12:10”等多种格式。通过自定义正则匹配与 timedelta 计算,将各类输入统一转换为“YYYY-MM-DD HH:MM:SS”标准格式,并处理时区偏移。
2026-10-14
19
本文介绍利用 Python 解析非标准时间字符串的方法,支持“今天”、“几天前”、“2017-1-4 12:10”等多种格式。通过自定义正则匹配与 timedelta 计算,将各类输入统一转换为“YYYY-MM-DD HH:MM:SS”标准格式,并处理时区偏移。
本文介绍Pandas中用于高效存储含大量NaN值数据的稀疏数据结构。重点讲解SparseArray的创建、SparseDtype的类型定义(如非NaN值类型与填充常量),以及通过.sparse属性访问密度和填充值的方法。同时说明SparseSeries和SparseDataFrame在1.0.0版本后的替代方案,并提供SciPy稀疏矩阵转换示例。
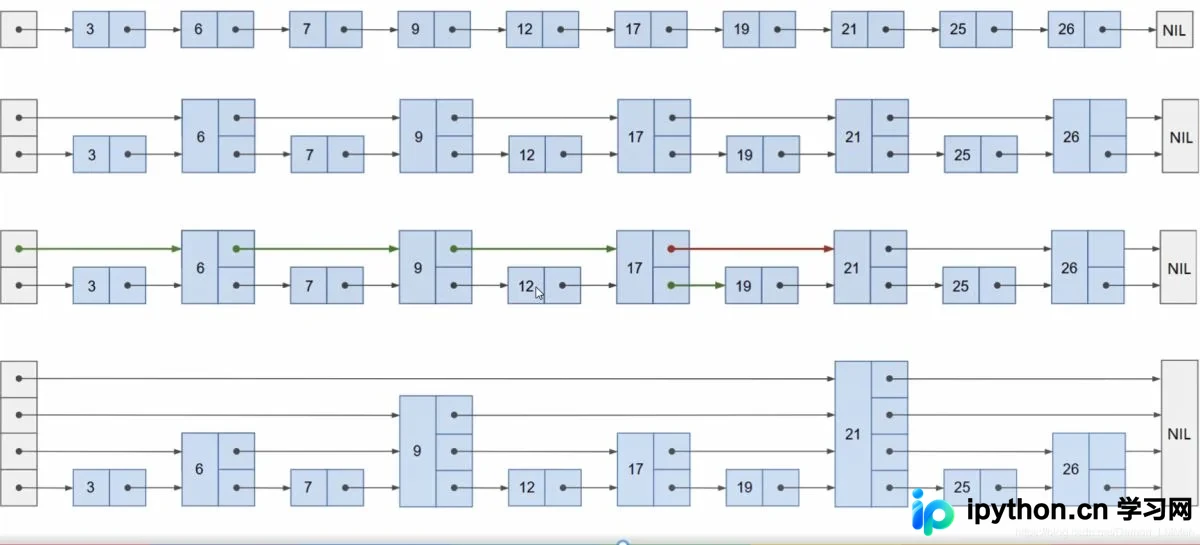
本文介绍跳表(SkipList)这一高效的数据结构,其初衷为替代红黑树。详细解析了跳表在Redis SortedSet和LevelDB MemTable中的应用,并通过Python完整代码展示了节点定义、查找、插入及删除操作的实现逻辑,平均时间复杂度为O(logn)。
本文详细介绍Pandas中的option系统,用于控制数据展示行为。涵盖常用方法如get_option、set_option、reset_option及option_context,并深入解析display.max_rows、display.precision、display.chop_threshold等关键参数的配置与示例,帮助开发者优化DataFrame输出格式。
本文深入解析Django框架中路由与视图的核心概念,通过具体代码示例演示如何创建视图函数并配置urls.py实现URL映射。重点讲解常规路径匹配与正则表达式路由的区别,展示如何动态捕获订单ID等参数,帮助开发者快速掌握Django Web应用的基础开发流程。
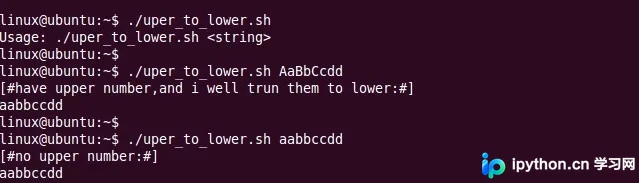
本文介绍利用Shell脚本的tr命令以及C语言字符逻辑,在Linux环境下实现输入字符串中大写字母向小写字母的自动转换。通过代码示例解析判断与转换的核心逻辑及命令行参数处理方式。
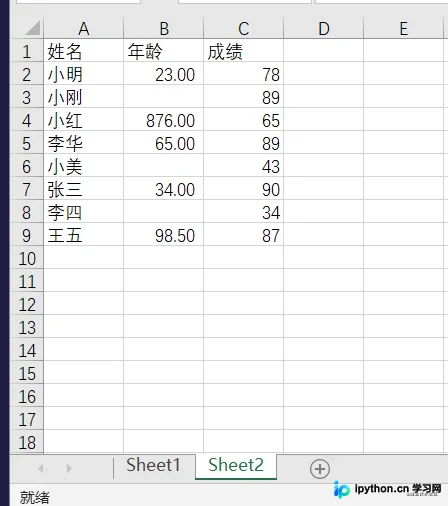
本文详细介绍pandas中sort_values()方法的使用,涵盖单列与多列数值排序、升序与降序设置,以及缺失值(NaN)位置的灵活控制。通过具体代码示例和结果展示,帮助开发者掌握数据清洗与排序的核心技巧。
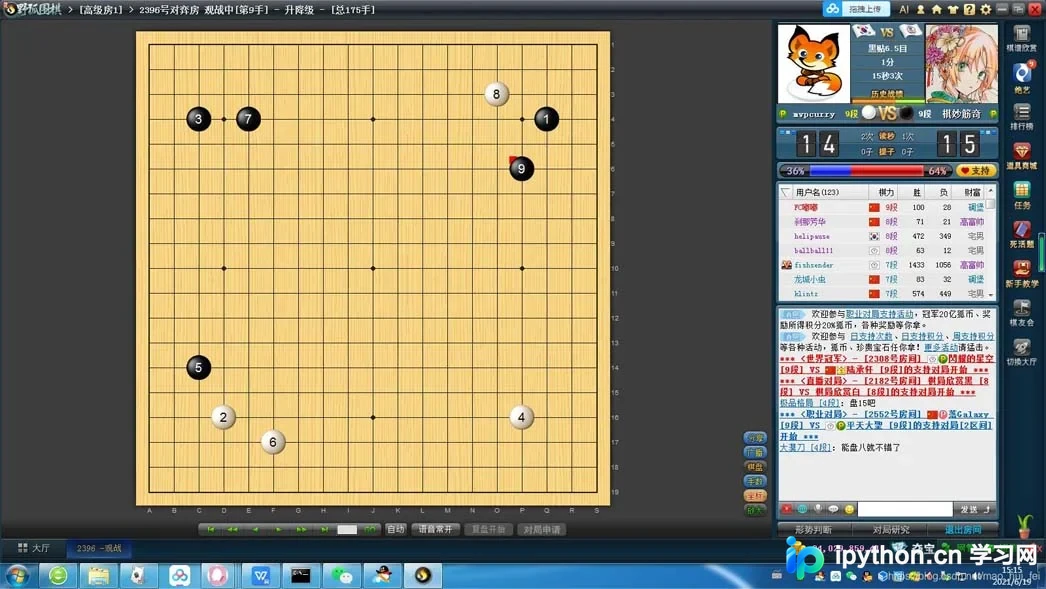
本文介绍利用Python和OpenCV库进行围棋棋盘图像识别与定位的技术方案。通过HSV颜色空间转换、形态学处理及轮廓检测算法,自动提取棋盘区域并截取保存,适用于自动化对弈或棋局分析场景。
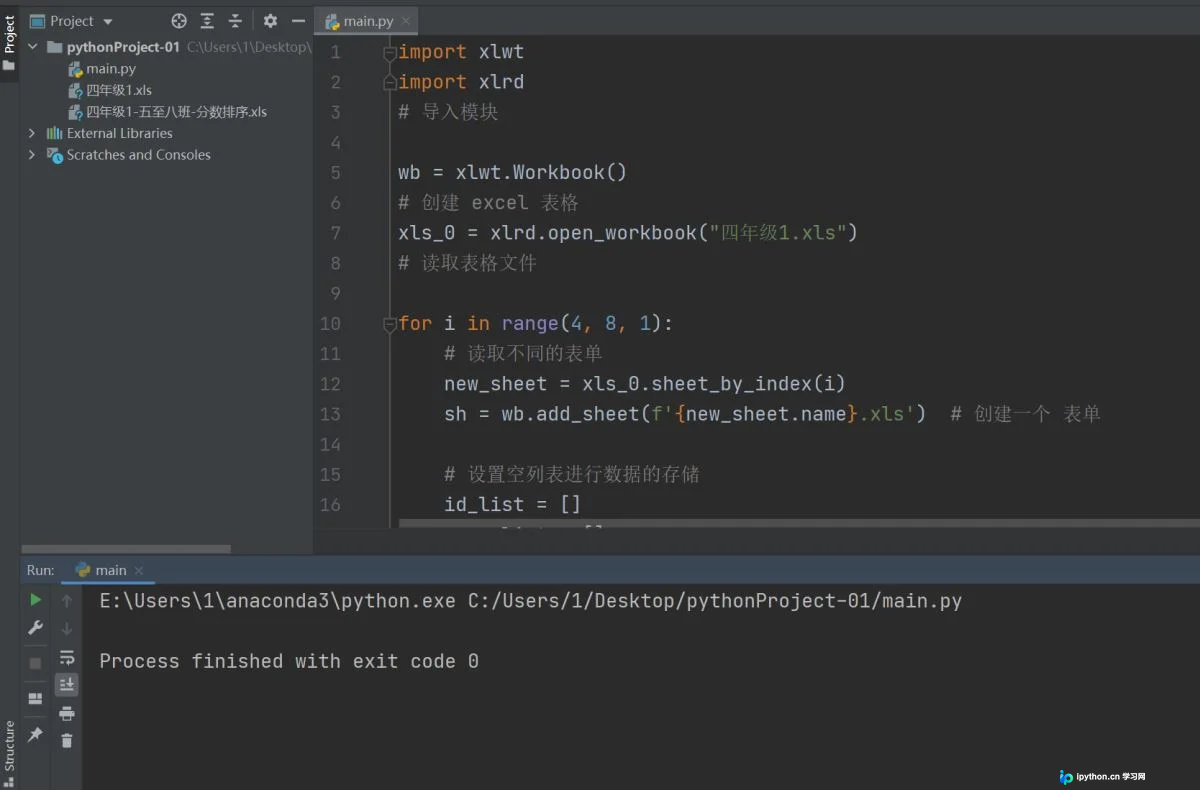
本文介绍如何使用Python的xlrd和xlwt模块读取Excel文件,并通过冒泡排序算法将学生成绩按从高到低重新排序。代码示例展示了如何同时处理学号、姓名和分数,确保数据关联一致,最后将排序结果写入新的Excel文件。
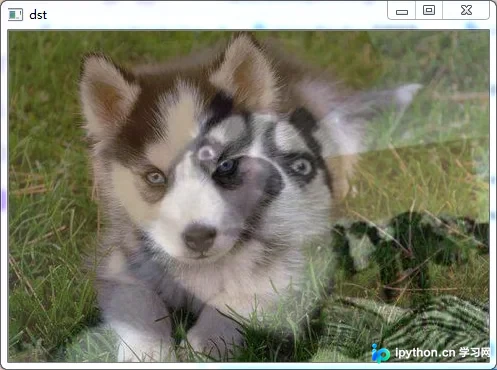
本文详细介绍在Python中使用OpenCV进行图像处理的三种核心操作:图像叠加、图像融合及按位运算。通过对比cv2.add与Numpy加法差异,解析addWeighted权重混合原理,并演示利用掩码和ROI实现非矩形区域(如Logo)的透明叠加技巧,提供完整代码与参数说明。
本文解析Python中使用open函数打开文件时路径选择的问题。详细对比绝对路径与相对路径的使用场景,指出Windows与网络路径斜杠差异,并通过错误与正确代码示例,说明相对路径中../的使用技巧,帮助开发者避免文件打开失败。
本文深入解析Python中random seed的作用机制,通过标准库random与numpy模块的实例,展示如何固定随机数生成顺序以实现结果复现。文章探讨了不同分布、形状及干扰函数对种子状态的影响,揭示跨平台代码复现的关键细节。