

pandas实现SQL中WHERE IN查询:isin()用法与多条件筛选详解
本文详解如何在pandas中实现类似SQL的WHERE IN查询。通过演示isin()方法处理列表筛选,对比直接使用时in导致的ValueError错误,并展示多条件组合筛选的正确括号用法,帮助开发者高效进行数据过滤操作。
2026-10-14
21
本文详解如何在pandas中实现类似SQL的WHERE IN查询。通过演示isin()方法处理列表筛选,对比直接使用时in导致的ValueError错误,并展示多条件组合筛选的正确括号用法,帮助开发者高效进行数据过滤操作。
本文详解Python中MySQL的IN参数化两种常见写法,指出字符串拼接的风险与.format()方法的便捷性。同时针对读取本地配置文件时常见的类型错误及连接失败问题,提供排查思路与解决方案,帮助开发者避免SQL注入并稳定连接数据库。
本文介绍如何使用Python3结合pyautocad库操作AutoCAD。内容涵盖从数据库提取BLOB数据,解析文本标识符(如LINE、PL)及坐标字符串,生成包含起点和终点坐标的列表,并通过AddLine、AddText等API在CAD中绘制图形。同时包含解决COMError常见错误的调试步骤及SaveAs保存方法。
本文介绍了如何使用Python的pymysql库连接MySQL数据库,并通过pandas库将查询结果转换为DataFrame对象。文章提供了完整的代码示例,展示了从建立连接、执行SQL查询到关闭连接的完整流程,以及如何遍历和访问DataFrame中的元素。
本文详细介绍如何使用Python通过hdfs库访问HDFS。涵盖pip安装步骤、核心代码示例(如Client初始化、文件下载),并重点解决WebHDFS服务未开启导致的连接失败问题。通过修改hdfs-site.xml启用dfs.webhdfs.enabled属性,并提供curl检测命令,帮助用户快速排查和配置Hadoop环境。
本文详细介绍如何在Python环境中连接HDFS,实现文件的读取与写入。通过安装pyhdfs模块,演示了从HDFS读取二进制数据流并转换为CSV,以及利用Pandas将文本文件处理为Dataframe并导出为CSV的具体代码。涵盖Python 3.6与Hadoop 2.9环境下的实际操作步骤,包括本地文件上传至HDFS的方法,为大数据处理提供基础支持。
本文介绍Python读取HDFS上Parquet格式数据的多种方案,包括hdfs3、hdfs和pyhdfs库的使用及HA配置。同时提供PySpark中利用coalesce函数合并小文件、优化存储效率的实用代码示例。
本文详细介绍如何使用Python的hdfs3模块替代命令行操作HDFS,实现更优雅的编程体验。内容涵盖文件读取与写入的基本用法、多节点高可用环境的配置方法,以及HDFileSystem提供的常用API列表,如文件复制、权限修改和目录遍历等,帮助开发者高效管理Hadoop分布式文件系统。
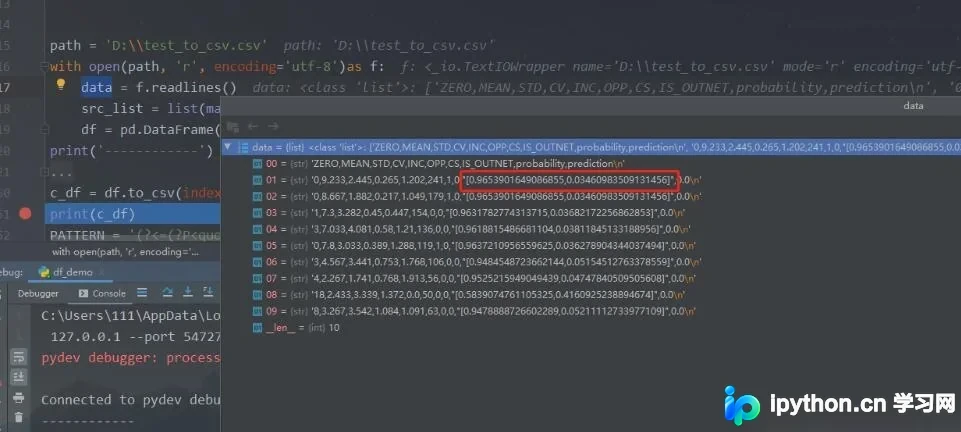
本文介绍如何使用Python的pyhdfs模块连接Hadoop集群,实现HDFS文件的读写与本地文件上传。重点解析在通过Pandas处理包含特殊引号格式的CSV数据时,因正则匹配保留引号导致的转义错误,并提供修正后的正则表达式与处理逻辑,确保数据准确转换。
本文介绍Python中输出整数的两种常用方法。第一种通过str()将数字转为字符串并检查是否包含小数点来筛选整数;第二种利用浮点数精度格式化(如%.0f)实现四舍五入输出。文章包含具体代码示例及执行结果分析,帮助开发者根据需求选择合适方案。
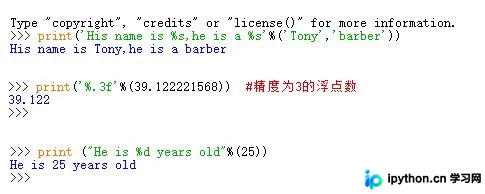
本文详解Python连接MySQL和PostgreSQL数据库时,SQL语句中%s、%d、%f参数的使用规范。重点解析在LIKE查询中处理普通百分号时的转义技巧,通过%%替代%防止格式化错误,确保数据查询准确无误,适用于增删查改操作中的字符串格式化场景。
本文详解 Python 中引用包的两种主要方式:直接使用 import 包名导入整个模块,以及利用 from 包名 import 类名/函数名进行精准导入。通过 time 模块示例演示具体代码,并深入解析如何依据 __init__.py 文件的存在来区分普通目录与 Python Package,帮助开发者高效管理依赖与提升代码可读性。