MySQL中ORDER BY排序规则与使用详解
本文详细介绍MySQL中ORDER BY语句的使用,涵盖单列默认升序排序、多列组合排序、ASC/DESC升降序指定以及结合LIMIT获取极值的方法。通过实例演示如何避免中文乱序陷阱并掌握正确的SQL语法顺序。
2026-10-16
7
本文详细介绍MySQL中ORDER BY语句的使用,涵盖单列默认升序排序、多列组合排序、ASC/DESC升降序指定以及结合LIMIT获取极值的方法。通过实例演示如何避免中文乱序陷阱并掌握正确的SQL语法顺序。
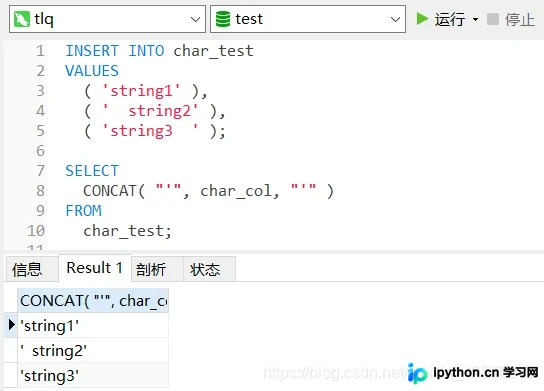
本文深入解析MySQL中CHAR与VARCHAR两种字符串类型的核心差异。CHAR为定长存储,适合短文本及高频更新场景;VARCHAR为变长存储且需额外字节记录长度,节省空间。通过SQL实例对比两者的存储行为,并给出基于数据特征、更新频率及字符集选择的最佳实践建议。
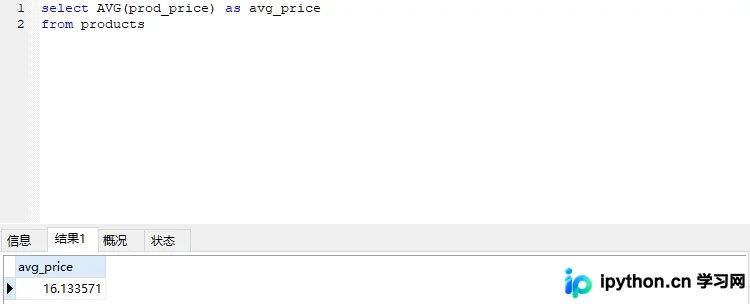
本文详解 MySQL 中如何实现不检索实际数据而是直接进行统计分析。介绍 AVG、COUNT、SUM 等聚合函数的使用方法,重点解析 GROUP BY 子句的嵌套规则、NULL 值处理以及与 HAVING 的区别。结合 ROLLUP 和 ORDER BY 提供完整的分组统计操作示例,帮助开发者快速掌握复杂报表生成的 SQL 编写技巧。
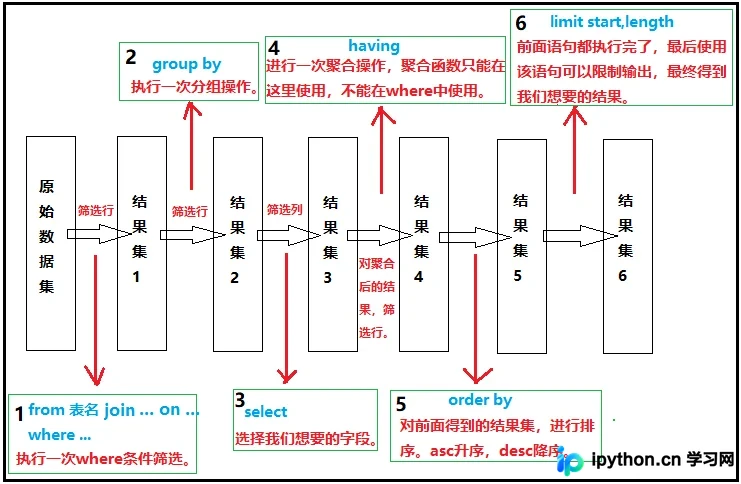
本文详细解析MySQL SQL查询语句的书写顺序与底层执行顺序。通过对比 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 关键字,阐明两者为何不同及其背后的逻辑。同时重点探讨 HAVING 与 SELECT 的执行先后争议及优化建议,帮助开发者写出更高效的SQL代码。
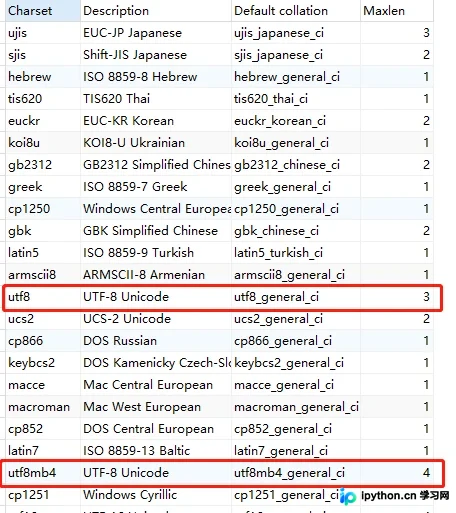
微信昵称等数据常包含 Emoji 表情,导致 MySQL utf8 编码报错。原因在于 MySQL 的 utf8 仅支持最多3字节,而 Emoji 需4字节。将数据库、表及字段的字符集设置为 utf8mb4 即可解决此问题并完整保留特殊字符。
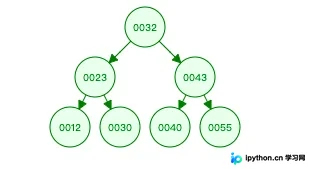
本文深入解析MySQL中常见的索引数据结构,对比二叉树、红黑树、B-Tree与B+Tree的性能差异。重点阐述InnoDB引擎使用B+Tree实现的聚集索引(聚簇索引)与非聚集索引的回表机制,以及MyISAM存储引擎中索引与数据分离的原理,并讲解联合索引的最左前缀原则,帮助开发者理解SQL查询性能优化的底层逻辑。
本文详细梳理了MySQL数据库的23项关键安全与配置注意事项。涵盖从网络连接加密、防火墙策略到密码强度设置,再到防止SQL注入、精细化的权限控制及启动参数优化。通过规范的用户管理、数据备份及异常处理机制,帮助开发者与管理员构建更安全、稳定的数据库环境。
本文深入解析MySQL分库分表的三种核心策略:RANGE范围划分、HASH取模及一致性Hash算法。通过对比各方法的优劣,重点阐述一致性Hash配合虚拟节点如何解决数据倾斜与扩容难题,并提供Java单元测试代码验证路由逻辑,助力高并发场景下的数据库架构设计。
本文详细对比MySQL常用存储引擎InnoDB与MyISAM的核心特性。重点分析两者在并发控制(行锁vs表锁)、事务支持、外键约束及索引类型上的差异,帮助开发者根据业务场景选择最适合的存储引擎以优化数据库性能。
本文详解 SQL Server 中触发器的基本概念、DML 与 DDL 分类,以及 AFTER 和 INSTEAD OF 的区别。重点解析 inserted 与 deleted 虚拟表在不同操作中的数据表现,并通过 Insert、Delete、Update 及级联更新的具体代码示例,演示如何创建和维护触发器以实现数据校验与审计日志。
本文深入解析 MySQL 性能优化的十大核心场景,涵盖最左匹配原则、隐式转换陷阱、大分页延迟关联、IN 查询临界值及范围查询阻断等常见问题。通过 explain、show profile 和 optimizer_trace 工具定位执行计划瓶颈,提供从索引设计到 SQL 重构的实操方案,帮助开发者有效解决慢查询与索引失效问题。
本文详细解析MySQL中的表联结与集合操作。涵盖CROSS、INNER及LEFT/RIGHT OUTER JOIN的原理与示例,讲解UNION与UNION ALL合并结果集的规则与差异,通过具体SQL代码演示如何在开发中正确应用这些核心查询语法以获取精准数据。