Python数据分析之NumPy常用函数使用详解
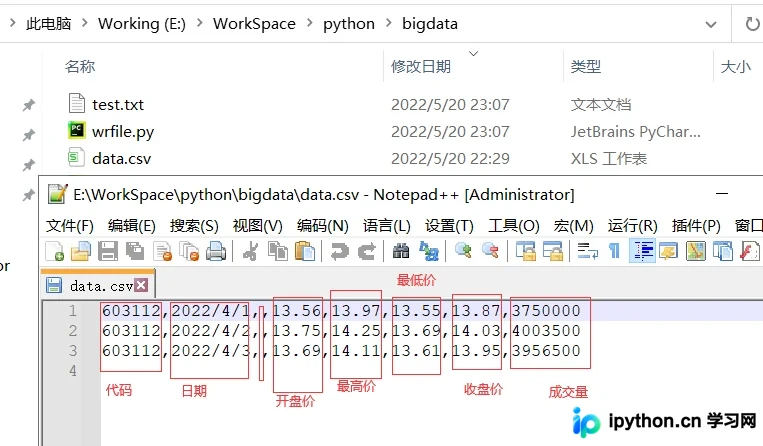
本文以历史股价分析为例,详细讲解NumPy核心函数。涵盖loadtxt与savetxt的文件读写、usecols参数筛选、average加权与算术平均、diff计算收益率、log对数收益及波动率公式。通过实战代码演示日期处理、where筛选、std标准差及极值统计,帮助掌握NumPy在金融数据分析中的关键应用。
2026-10-16
4
本文以历史股价分析为例,详细讲解NumPy核心函数。涵盖loadtxt与savetxt的文件读写、usecols参数筛选、average加权与算术平均、diff计算收益率、log对数收益及波动率公式。通过实战代码演示日期处理、where筛选、std标准差及极值统计,帮助掌握NumPy在金融数据分析中的关键应用。
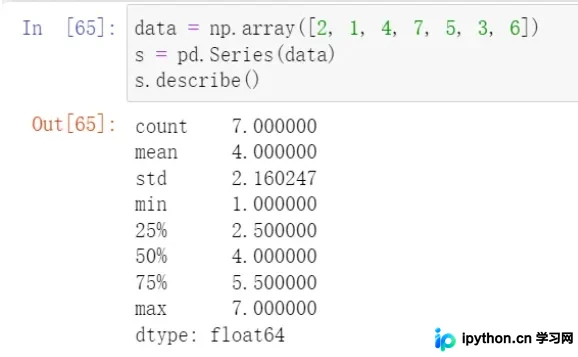
本文详细介绍Python数据分析库Pandas中Series对象的核心用法。涵盖从列表、字典及NumPy数组创建Series的方法,解析index与values等常用属性。深入讲解元素获取、修改、删除及切片操作,并演示head、tail、排序、去空等常用函数。最后通过describe统计与四则运算示例,展示Series在数据清洗与分析中的实际应用。
本文详细介绍在Python数据分析中,如何利用Pandas库对DataFrame高效应用自定义函数。重点解析apply方法按行或列处理数据、applymap方法逐元素处理数据,以及map方法在Series中的应用,通过具体代码示例展示如何替代低效的for循环,提升数据处理效率。
本文总结了6个常用的Pandas数据处理技巧,帮助开发者高效处理数据。内容涵盖快速定位含缺失值的行、根据条件替换列值、使用pd.cut进行数据分箱统计、利用split拆分文本列、通过正则表达式筛选中文字段,以及调整列顺序的两种方法。掌握这些代码片段能显著提升数据清洗与处理的效率。
本文介绍如何使用R语言及ggplot2包绘制高质量的主成分分析(PCA)图。通过iris数据集演示,涵盖数据准备、基础散点图绘制、类别着色及置信椭圆计算技巧(如inherit.aes参数处理),并包含轴标签百分比显示及自定义配色等样式微调方法。
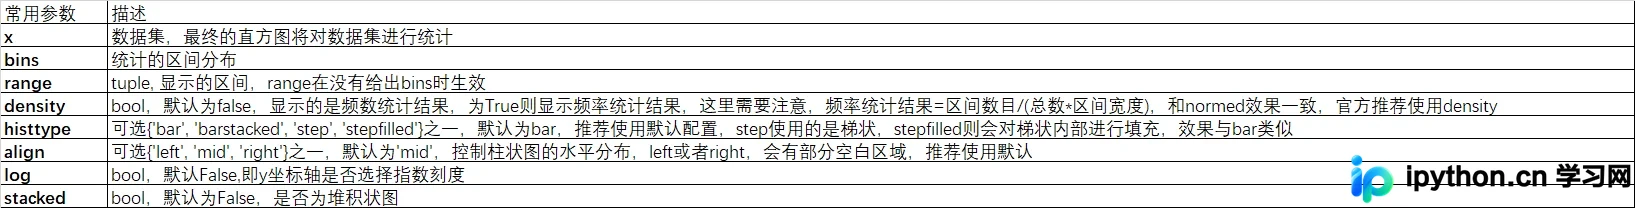
本文详解matplotlib中直方图的绘制方法与核心参数配置。涵盖基础统计直方图、概率密度分布(PDF/CDF)、堆叠直方图及多子图布局技巧。提供连接数据库、DataFrame绘图及复杂数据可视化的完整代码模板,帮助开发者高效实现数据分布分析。
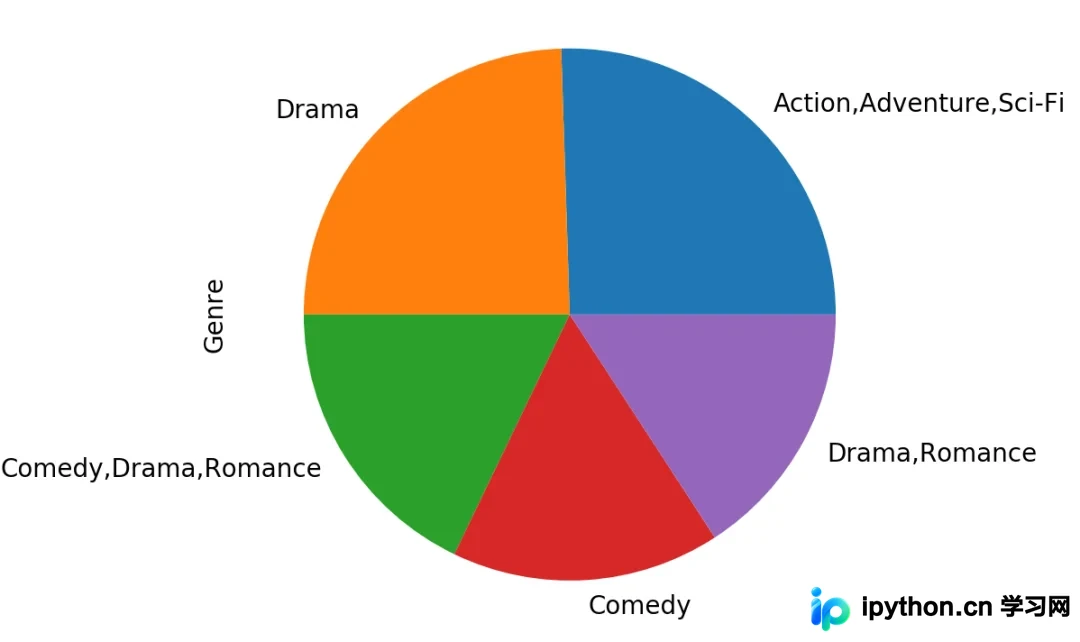
本文介绍Python中Pandas库的三个实用数据处理技巧。首先演示如何使用pop方法高效移除指定列并验证结果;其次讲解利用str.count方法统计标题中单词数量的方法;最后通过value_counts和matplotlib展示电影Genre的频次统计及Top5可视化分析,帮助开发者快速掌握数据清洗与基础统计操作。
本文详细介绍在Python中使用pandas库计算环比和同比数据的方法。通过示例演示了利用shift、diff及pct_change函数处理时间序列数据的技巧,涵盖月度、季度及年度周期设置,并解析了处理缺失值和不同轴向计算的参数配置,帮助开发者高效完成业务数据分析。
本文介绍如何使用Python对月饼电商数据进行清洗与可视化分析。通过Pandas处理价格、销量及店铺信息,利用Pyecharts生成销量Top10店铺与商品柱状图、不同价格区间销量占比饼图以及各省销量分布地图,帮助直观了解市场趋势与热门产品。
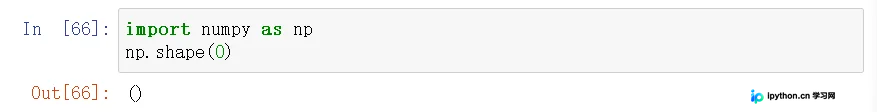
本文详解Python中numpy.core.fromnumeric模块下的shape()函数,用于读取矩阵长度与维度信息。通过解析输入参数为一维或二维矩阵时的返回值,以及利用shape[0]和shape[1]分别获取行数和列数的具体操作,帮助开发者掌握数组维度的判断方法。同时解释了Debug场景中shape(?,2,3)里问号代表的批处理个数含义,为数据分析提供基础支持。
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
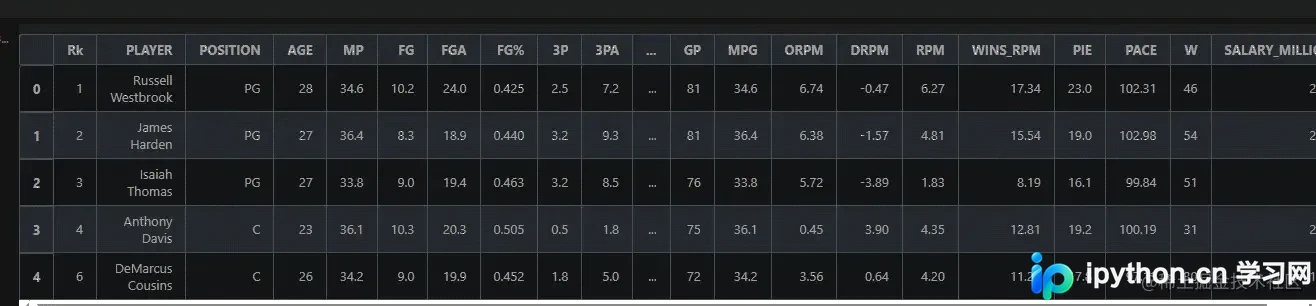
本文通过Jupyter Notebook演示如何利用Seaborn库对NBA球员数据集进行完整的数据分析。内容涵盖从数据导入、基础统计信息查看,到基于效率值(RPM)的特征相关性计算及热力图绘制,帮助读者掌握Python在体育数据挖掘中的实际应用。