Python正则表达式核心对象、修饰符与常用函数详解
本文详解Python中正则表达式的使用,涵盖re.RegexObject与re.MatchObject对象属性,解析大小写、多行等可选修饰符,并深入讲解match、search、sub、split等核心函数的参数与实战案例,帮助开发者高效处理字符串匹配与替换任务。
2026-10-15
0
本文详解Python中正则表达式的使用,涵盖re.RegexObject与re.MatchObject对象属性,解析大小写、多行等可选修饰符,并深入讲解match、search、sub、split等核心函数的参数与实战案例,帮助开发者高效处理字符串匹配与替换任务。
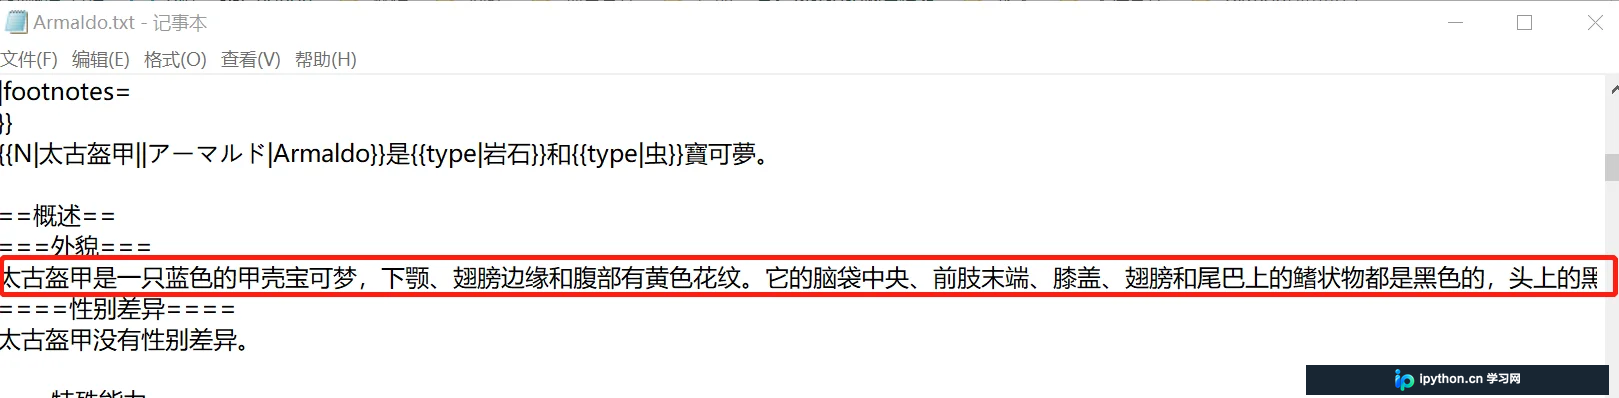
本文介绍如何使用Python批量从TXT文件中提取特定文本并写入Excel。通过正则表达式匹配特定标识符(如栖息地描述),结合Pandas库扩展数据框列,实现非结构化数据的结构化处理。文中包含代码示例与参数说明,解决跨行匹配及编码问题,适用于数据清洗与批量处理场景。
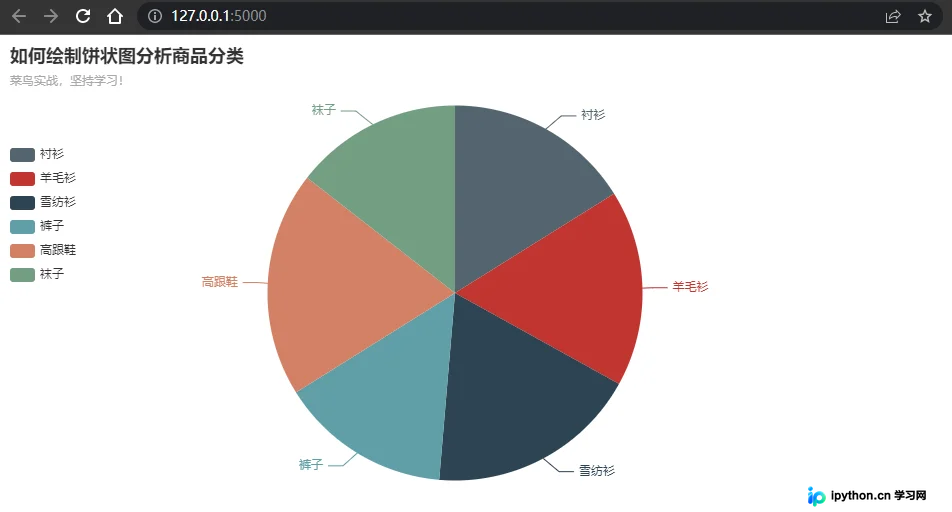
本文介绍如何利用Python的pyecharts库结合Flask框架,通过实例代码演示如何构建商品分类数据并绘制交互式饼状图。详细解析了pie()函数的关键参数,包括autopct格式控制、colors颜色设置及explode偏移量,帮助开发者快速掌握数据可视化基础。
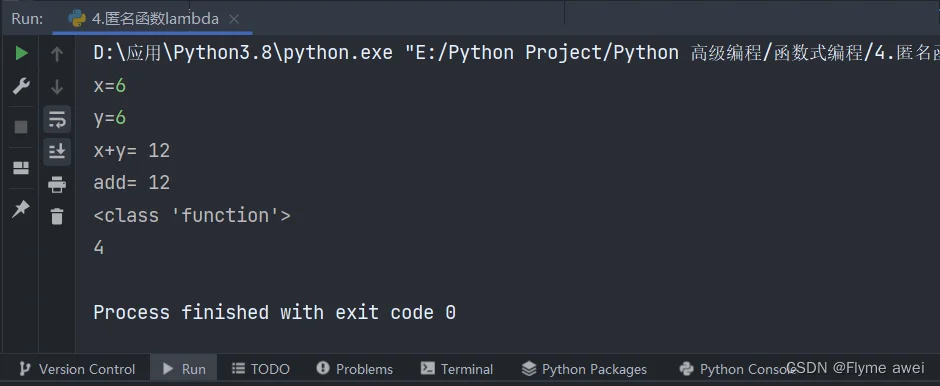
本文深入解析 Python 中 lambda 匿名函数的定义、语法结构及核心特性。详细对比普通函数与 lambda 在 def 和 return 上的差异,阐述其单表达式返回机制。通过 filter、map、reduce 等内置高阶函数的实例,展示 lambda 在简化代码、提升执行效率及配合函数式编程中的实际应用场景。
本文详细介绍Python中requests-html库的安装与核心用法。该库基于requests封装,支持CSS选择器与XPath定位,并能通过Chromium引擎执行JavaScript实现动态页面爬取。文章涵盖元素提取、分页处理及源码解析,帮助开发者快速掌握现代网页数据抓取技巧。
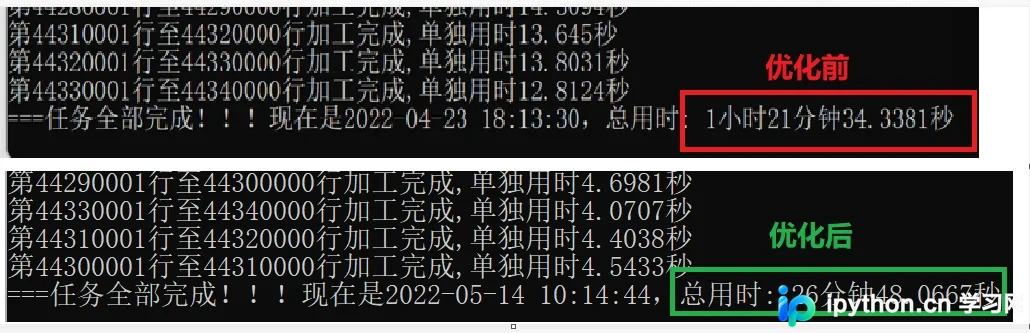
本文深入解析Python处理海量且逻辑复杂的CSV文件方案。针对千万级数据,采用分批读取、多进程计算与多线程I/O结合策略,利用chunksize与category类型优化内存。通过类对象映射、遍历算法重构及NumPy函数加速,显著提升处理效率,实现从小时级到分钟级的性能跨越。
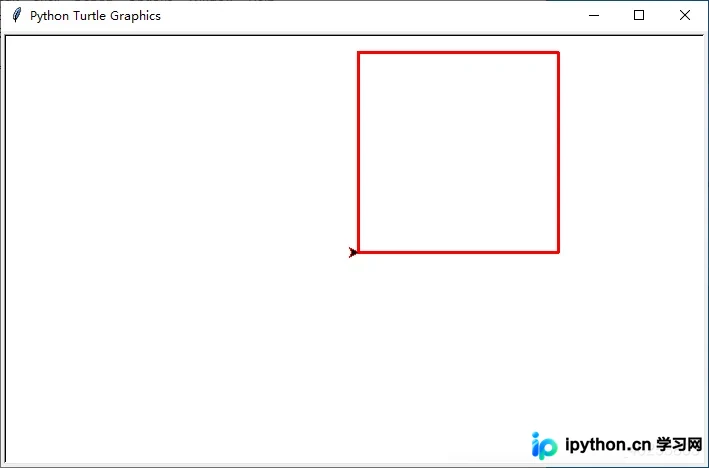
本文详细介绍如何使用Python的Turtle库绘制正方形。涵盖基础单色正方形绘制、四条边不同颜色的实现方法,以及通过控制画笔状态(penup/pendown)创建无角正方形的技巧。包含完整代码示例与运行结果解析,适合Python初学者掌握基础绘图逻辑。
本文详细介绍Python中gevent库的安装方法及核心概念。通过Greenlet轻量级协程实现高效并发同步或异步编程,解析协作调度机制。提供基于time模块打补丁的完整代码示例,演示如何创建、启动及合并协程任务,帮助开发者掌握gevent在IO密集型场景下的实际应用。
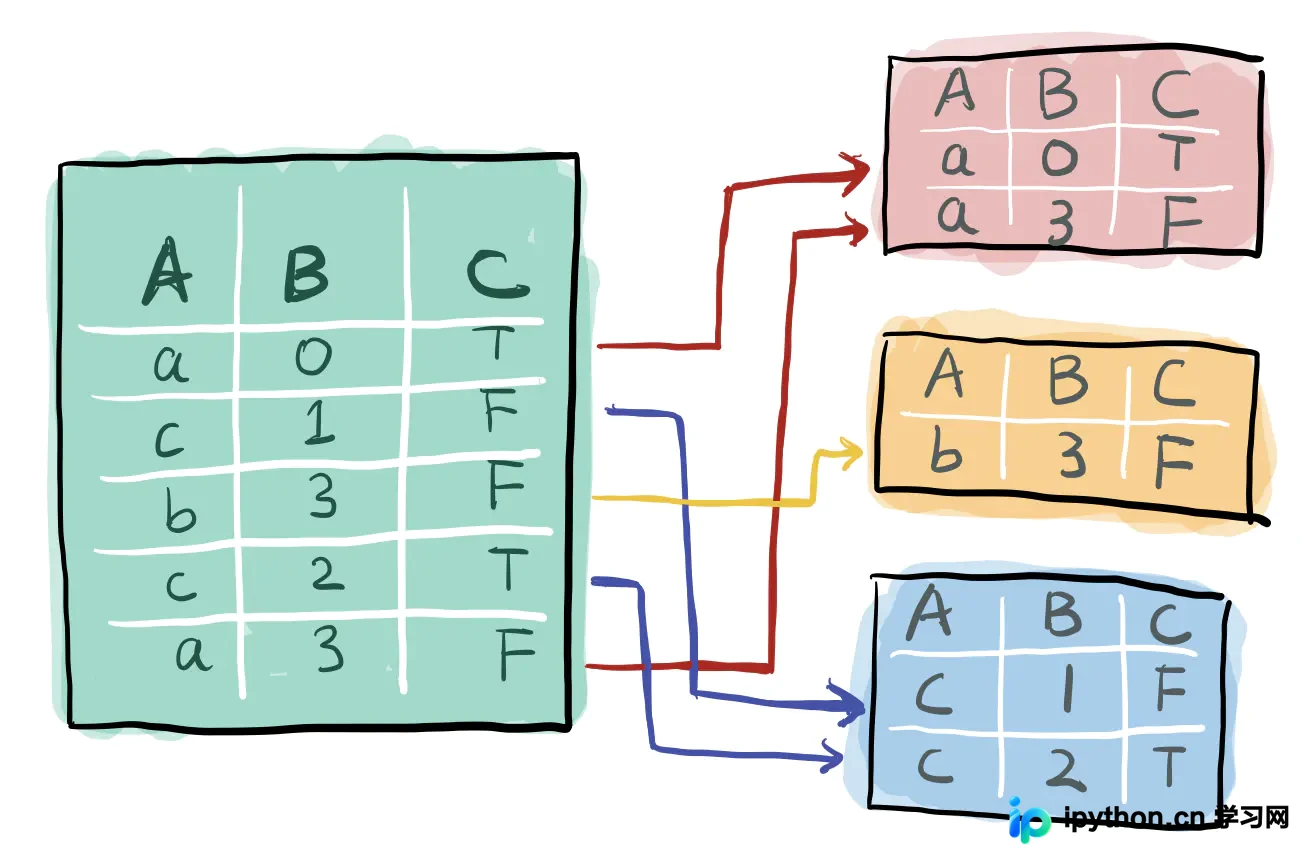
本文深入解析Python Pandas库中groupby函数的核心原理与使用方法。涵盖分组键类型、axis参数设置,详细演示mean、count、size等聚合函数的应用,以及通过agg和apply实现复杂自定义聚合。结合代码实例,讲解多列聚合、字典映射操作及实际数据处理场景,帮助开发者高效掌握数据分组与统计技巧。
本文介绍如何使用 Python 将新生成的数据实时追加到现有的 CSV 或 TXT 文件中。通过演示 csv 模块的 writerow 和 writerows 方法,以及文件打开模式 'a' 的使用,详细讲解了如何避免数据覆盖、处理换行符及正确关闭文件,确保数据持久保存。
本文深入解析Python中re.compile()与re.findall()的核心用法,结合网页爬虫实例演示如何高效提取特定HTML标签内容。详细讲解正则表达式中的贪婪与非贪婪匹配、分组捕获机制以及re.S标志对换行符处理的影响,帮助开发者掌握精准数据抓取技巧。
本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。