Scrapy爬取结果导出为Excel的实现方法
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
2026-10-16
0
本文详细介绍如何使用Scrapy框架将爬取数据导出为Excel格式。通过定义Item实体类、配置CsvItemExporter以及注册Pipeline,实现数据的结构化存储。文章涵盖环境要求、核心代码实现及爬虫运行步骤,帮助开发者快速掌握Scrapy数据导出功能。
本文详解如何利用原生PHP和MySQL构建一个简易投票系统,涵盖数据表创建、前台用户投票、结果统计及后台管理模块。重点解析使用mysqli实现数据交互、Session防重复投票机制及简单的权限验证流程,提供完整的增删改查逻辑供参考。
介绍如何在 PHP 中通过自定义会话处理函数,利用 Memcached 替代原生文件式 Session 存储。方案包含核心原理、连接配置及完整的 session_start/save_handler 实现代码,适用于分布式环境下的用户状态管理。
介绍在SpringBoot项目中读取classpath资源目录下JSON配置文件的正确做法。通过结合ResourceUtils定位文件、common-io读取内容以及fastjson2进行反序列化,避免了原始IO的繁琐,实现简洁高效的配置获取方案。
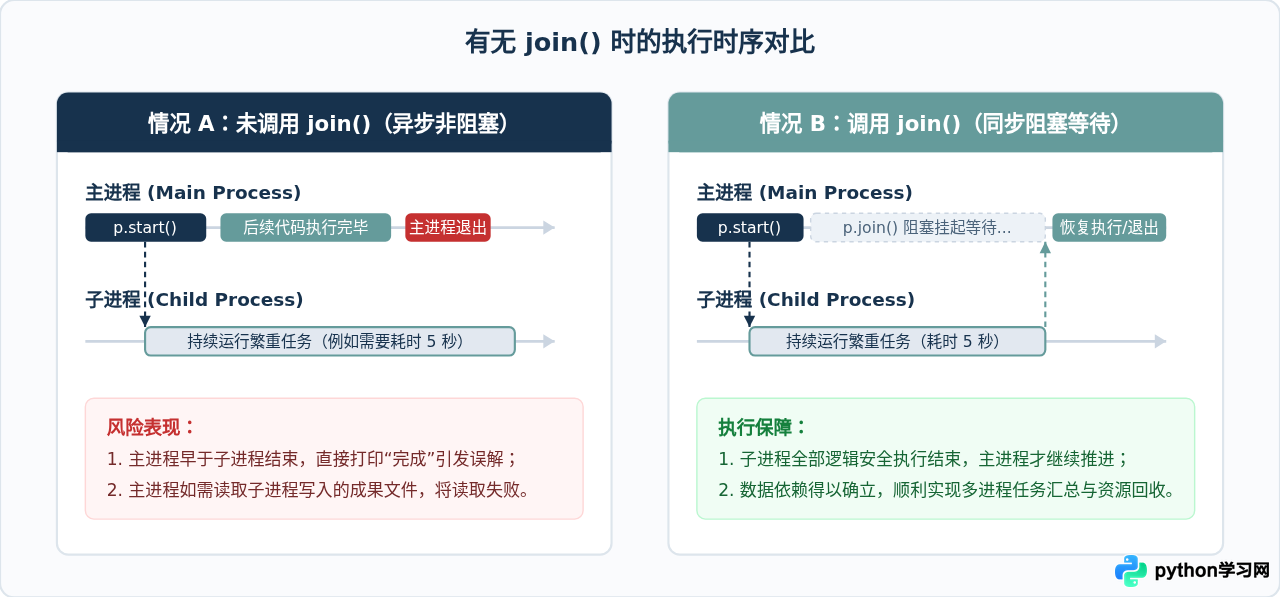
深入解析Python multiprocessing模块中Process.join()的核心作用与运行机制,对比分析有无join时的进程执行时序,剖析循环调用join的常见误区及join(timeout)超时控制技巧。
详细讲解在Python中只获取当前日期而不包含时分秒的标准方法,涵盖date.today()、datetime对象转换、字符串格式化及时区处理,包含完整代码与流程图示。
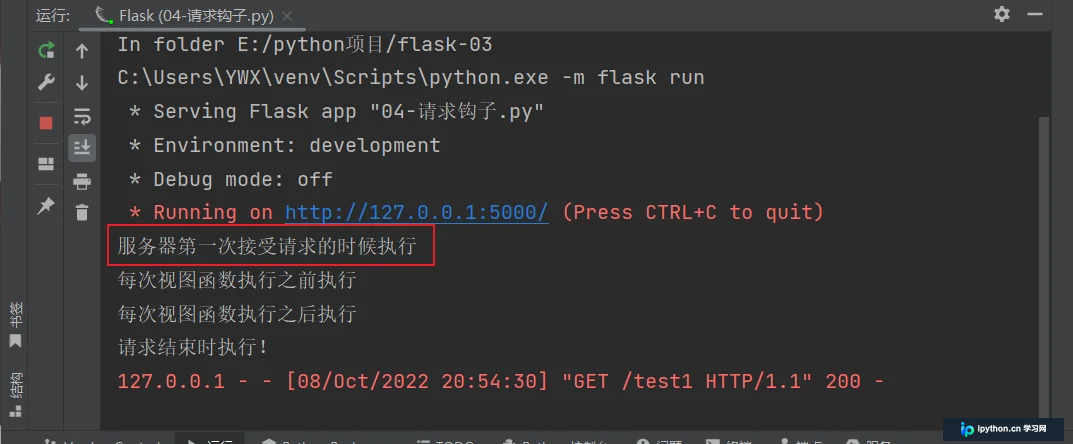
本文详细解析Flask框架中的核心机制。首先介绍四种请求钩子(before_first_request、before_request、after_request、teardown_request)的执行时机与作用;其次区分请求上下文(request、session)与应用上下文(current_app、g)的使用场景;最后讲解如何通过abort主动抛出HTTP异常,并利用errorhandler装饰器捕获和处理自定义错误页面。
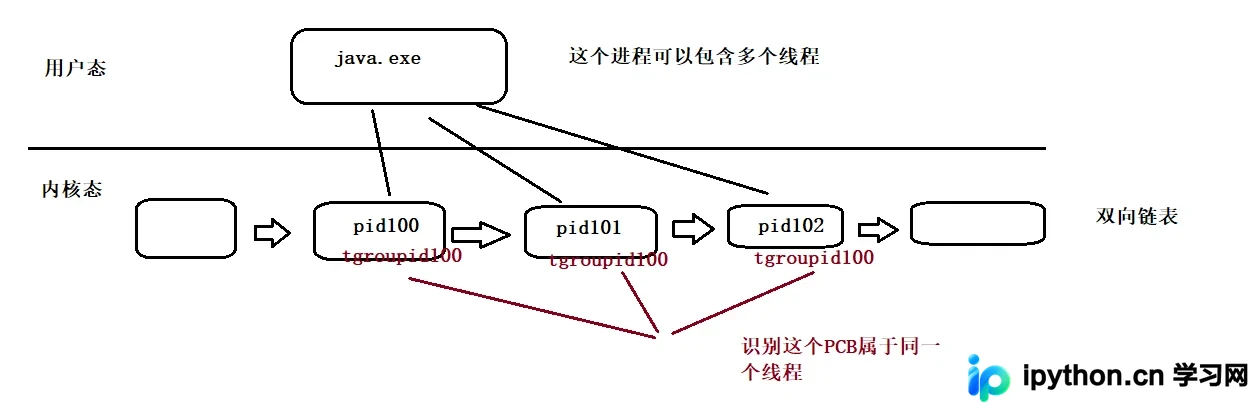
深入解析Java Web中的进程与线程概念,从PCB结构、用户态/内核态切换讲到并发模型。通过图解说明单/多线程配置下的资源分配策略,以及CPU密集型和IO密集型任务的调度差异,为理解多线程并发奠定基础。
本文介绍如何在MySQL中利用UNION联合查询获取指定ID的上下相邻记录,适用于弹窗翻页场景。针对同一张表中关联订单的相邻数据计算(如首单与二单时间差),提供基于自连接、COUNT过滤及SUBSTRING_INDEX函数的多种解决方案,涵盖原理与完整示例代码。
本文详细介绍使用Python实现微信小程序支付的完整流程,涵盖获取OpenID、统一下单、支付回调处理及签名验证等核心环节。文中针对常见的签名错误、HTTPS回调问题及资金安全校验提供了具体的代码示例与解决方案,帮助开发者快速完成支付功能集成。
本文介绍如何在 PHP 中利用 MediaWiki 的 ZHConverter 模块实现高效的中文简体与繁体转换。该方法不仅支持基础的简繁互换,还能精准适配中国大陆 (zh-cn)、台湾 (zh-tw)、香港 (zh-hk) 及新加坡 (zh-sg) 等地方的用字差异,如人名、地名及特定词汇的本地产化写法。通过引入核心库并设置路径,开发者可快速集成该功能,解决跨地区内容显示的标准化问题。
本文提供了一套完整的C语言会员管理系统源代码。系统基于结构体和数组设计,支持6位唯一会员号的录入、增删改查、状态挂失/解挂以及余额消费充值功能。代码详细演示了输入验证、内存移动及多条件查找逻辑,是学习C语言数据管理的实用案例。