

Python多进程中join()的作用:阻塞主进程等待子进程结束

multiprocessing 模块中,调用 process.join() 的根本作用是阻塞当前进程(通常是主进程),直到目标子进程完全执行完毕后再继续向下执行。它是一种基础且关键的时序同步机制,确保主进程不会在子进程任务尚未完成时过早退出或抢先执行依赖后续结果的操作。
一、直观理解:有无 join() 的执行时序差异
初学者在使用 multiprocessing.Process 时,最常见的困惑往往发生在调用 start() 之后。start() 方法是非阻塞的——它只是通知操作系统创建一个独立子进程并在后台调度执行,代码紧接着就会立刻执行主进程的下一行。
如果没有调用 join(),主进程便会独立自顾自地往前走。当主进程的代码全部执行完成后,主进程可能直接退出,而子进程还在后台独自执行。如果在主进程后续逻辑中依赖子进程生成的计算结果、落盘文件或网络反馈,就会引发数据缺失或逻辑混乱。
通过加入 join(),主进程会在该语句处挂起,处于等待状态;直到操作系统确认该子进程完成并释放资源后,join() 才会返回,主进程随即被唤醒并继续向下执行。
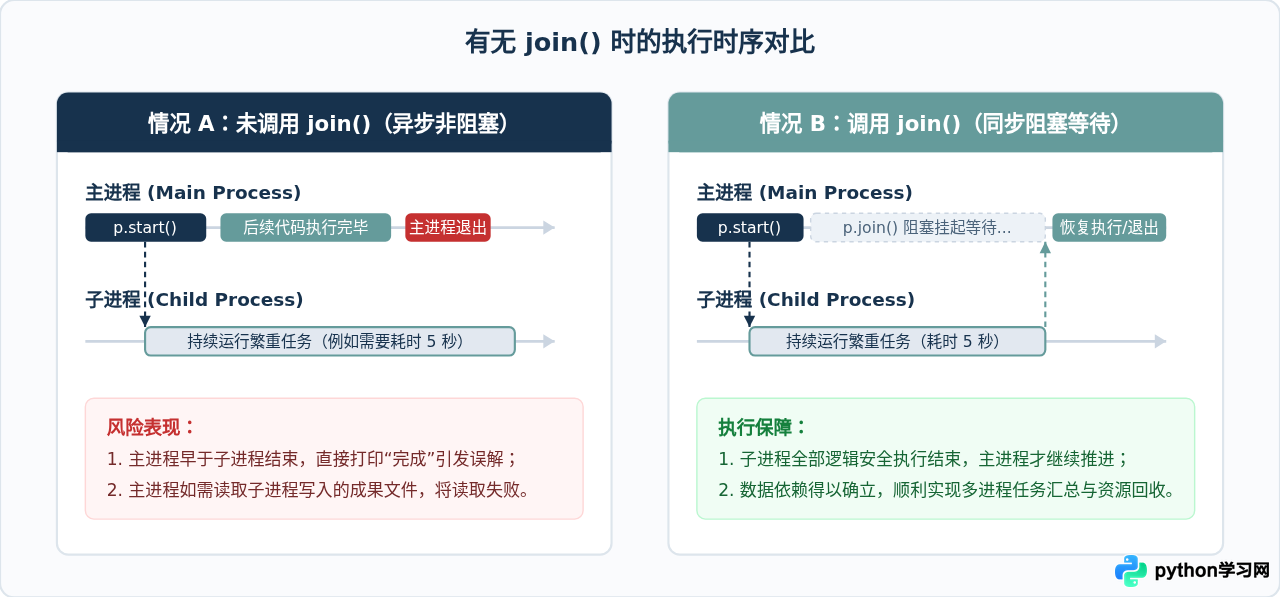
代码对比:直观查看终端打印顺序
下面的代码直观展示了有无 join() 带来的终端行为差异:
import time
from multiprocessing import Process

def worker_task(name):
    print(f"[{name}] 子进程开始工作...")
    time.sleep(2)
    print(f"[{name}] 子进程工作完成!")

if __name__ == "__main__":
    print("[Main] 主进程启动子进程")
    p = Process(target=worker_task, args=("Worker-1",))
    p.start()

    # 未调用 p.join() 的情况:
    # print("[Main] 主进程直接走到底部结束!")

    # 调用 p.join() 的情况:
    p.join()  # 此处主进程挂起,等待 Worker-1 执行完
    print("[Main] 主进程确认子进程已完成,安全退出。")
执行输出对比(示例):
若注释掉 p.join():
[Main] 主进程启动子进程
[Main] 主进程直接走到底部结束!
[Worker-1] 子进程开始工作...
[Worker-1] 子进程工作完成!
若保留 p.join():
[Main] 主进程启动子进程
[Worker-1] 子进程开始工作...
[Worker-1] 子进程工作完成!
[Main] 主进程确认子进程已完成,安全退出。
二、核心陷阱:循环中调用 join() 导致并发退化为串行
在使用多进程处理批量任务(例如抓取 5 个网页或处理 5 份数据)时,最容易犯的一个逻辑错误是在一个循环内部同时调用 start() 和 join()。
因为 join() 具有阻塞性,如果在循环中创建完一个子进程就立刻 join(),主进程会被强制卡住等待该进程跑完,之后循环才会进入下一次迭代创建第二个子进程。原本期望利用多核 CPU 并行处理的 5 个任务,瞬间退化成了单道串行执行,执行总耗时不但没有减少,反而增加了进程创建与销毁的额外系统开销。
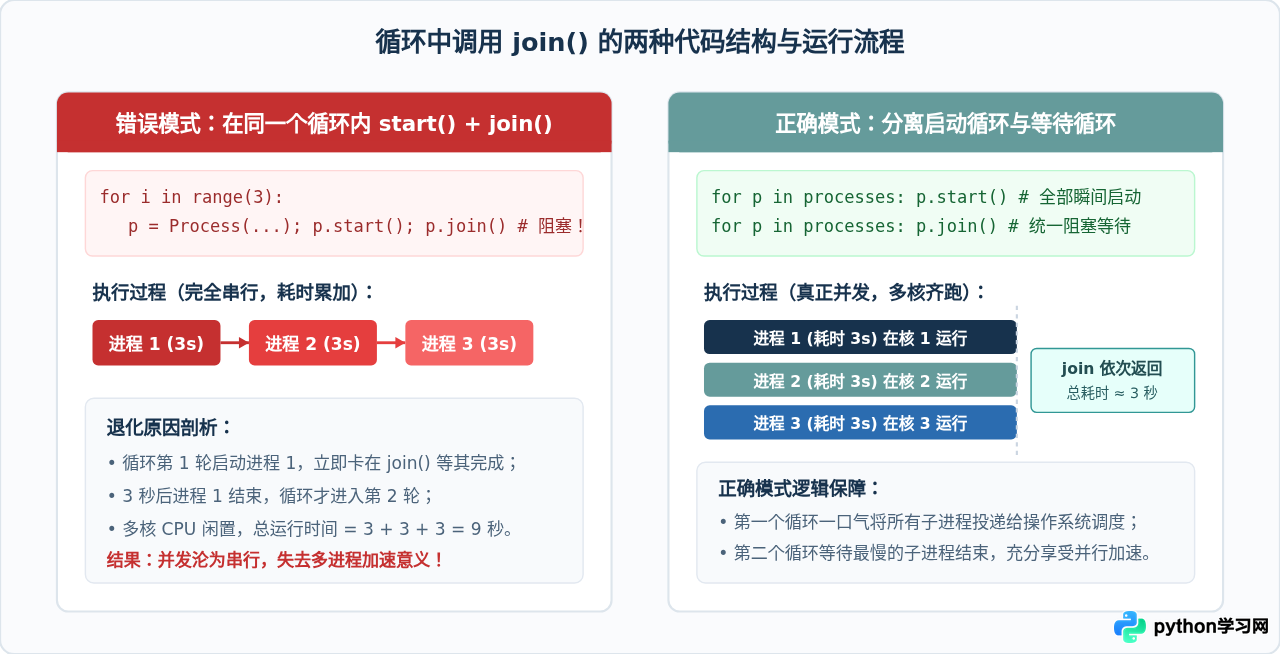
操作规范:规范管理多进程列表
操作步骤必须分为两个明确阶段:集中启动阶段与集中等待阶段。推荐使用列表将实例化的 Process 对象存储起来,代码模式如下:
import time
from multiprocessing import Process

def calculate_data(idx, duration):
    print(f"任务 {idx} 启动...")
    time.sleep(duration)
    print(f"任务 {idx} 完成")

if __name__ == "__main__":
    start_time = time.time()
    processes = []

    # 步骤 1:批量创建并调用 start(),立刻触发并行
    for i in range(3):
        p = Process(target=calculate_data, args=(i + 1, 2))
        processes.append(p)
        p.start()

    # 步骤 2:批量调用 join(),等待全部子进程结束
    for p in processes:
        p.join()

    total_cost = time.time() - start_time
    print(f"全部子进程已执行完毕,总运行时间:{total_cost:.2f} 秒")
    # 输出总耗时约为 2.0x 秒,而不是 6 秒!
三、防止无限卡死:join(timeout) 超时控制与善后处理
如果在执行子进程时发生了网络死锁、死循环或者数据库未响应,调用没有参数的 p.join() 将导致主进程一直永久卡死在等待语句上。
join() 提供了可选参数 timeout(单位为秒),例如 p.join(timeout=3):
- 子进程在 3 秒内执行完毕:
join()提前正常返回,主进程立即向下执行,无需傻等满 3 秒。 - 子进程超过 3 秒仍未完成:
join()强制返回,主进程恢复执行。
join(timeout) 超时返回并不会主动杀死子进程!此时子进程依然在后台继续运行。开发者必须通过 p.is_alive() 显式检查其状态,并按业务策略决定是告警、继续等待还是调用 p.terminate() 强制终止。
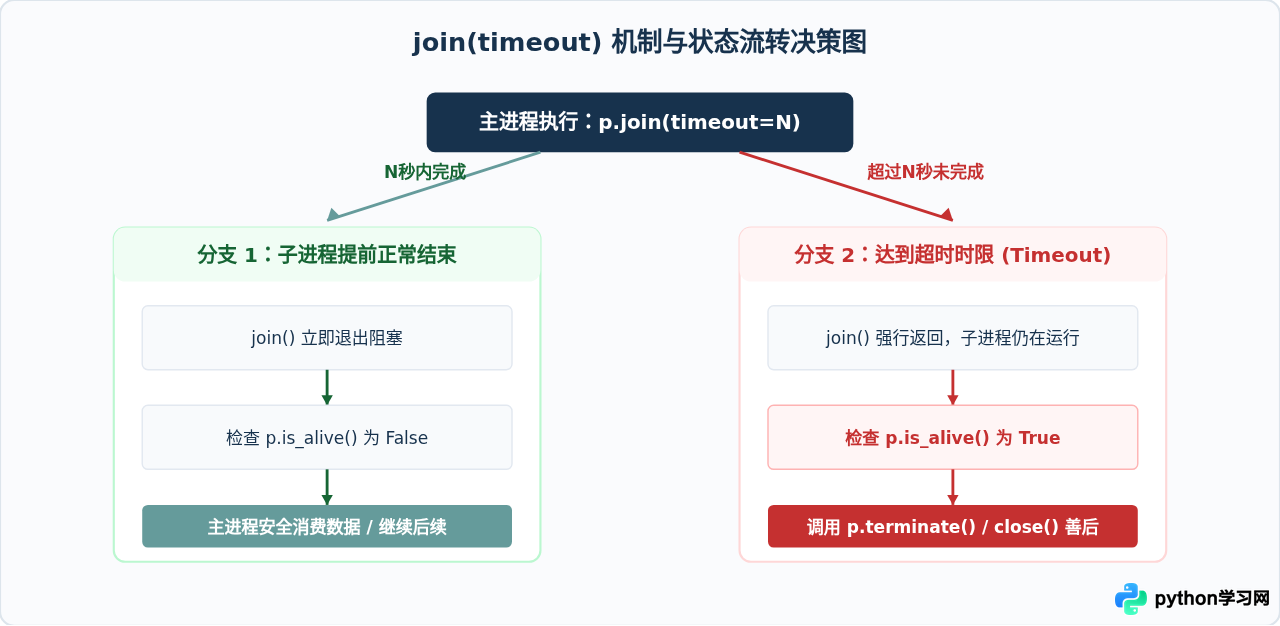
代码示例:结合 is_alive() 进行安全超时处理
实际生产中,使用超时参数的最佳模式是在 join 之后立即判断子进程的活跃状态:
import time
from multiprocessing import Process

def hung_task():
    print("任务开始,模拟长时间阻塞...")
    time.sleep(10)  # 模拟耗时 10 秒

if __name__ == "__main__":
    p = Process(target=hung_task)
    p.start()

    # 最多等待 3 秒
    p.join(timeout=3)

    if p.is_alive():
        print("警告:子进程执行超过 3 秒,仍在运行!准备强制终止...")
        p.terminate()  # 发送 SIGTERM 信号终止进程
        p.join()       # 再次 join,确保子进程系统资源被完全回收
        print("子进程已被成功清理")
    else:
        print("子进程在时限内顺利完成")
四、拓展理解:守护进程(daemon)与 join() 的关系
在多进程编程中,另一个常与 join() 产生交集的属性是 process.daemon。
| 配置类型 | 默认行为(无 join) | 调用 join() 时的行为 | 典型适用场景 |
|---|---|---|---|
非守护进程daemon=False(默认) |
主进程代码走完后,Python 解释器依然会隐式等待非守护子进程运行完毕才真正退出整个程序。 | 主进程明确在 join() 语句处显式阻塞暂停,等待完成后才推进下一行。 |
绝大多数业务核心计算、写数据库、生成文件等关键任务。 |
守护进程daemon=True |
主进程代码执行完毕后,不会等待守护子进程,操作系统直接强行杀死子进程并完全退出程序。 | 如果对守护进程调用 join(),主进程依然会阻塞等待它结束,失去了“随主进程退出而立即销毁”的意义。 |
后台监控日志上报、周期性心跳探测等随主程序生灭的辅助线程/进程。 |
需要牢记:daemon 决定的是当主进程结束时,子进程是否必须陪同销毁;而 join() 决定的是主进程是否停在原地,专程等子进程先跑完。两者的核心控制维度截然不同。
五、全景决策与最佳实践总结
理解 join() 的作用之后,我们在编写 Python 多进程代码时,可以遵循如下决策体系:
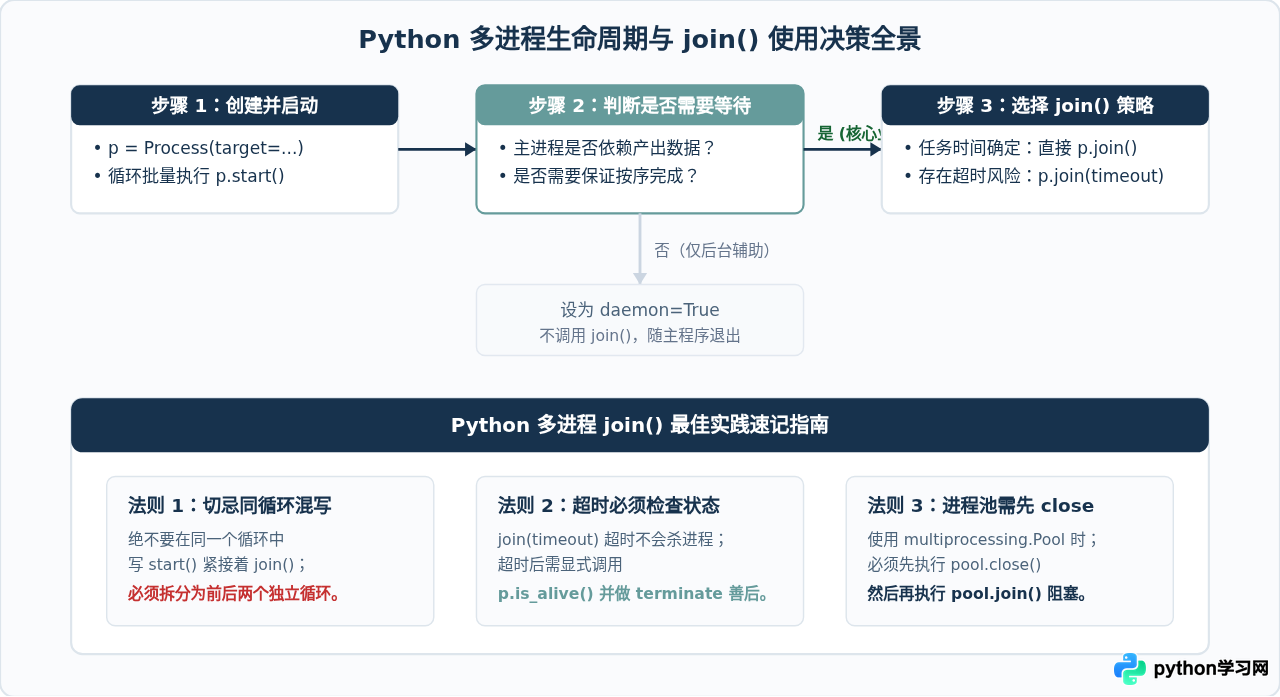
简而言之,join() 并不是让子进程执行得更快或更慢,而是为多进程环境提供了不可或缺的时间锚点。合理安排 start() 与 join() 的相对位置,并辅以超时判断与状态检查,便能在充分榨干多核性能的同时,确保程序时序稳健、无孤儿残留。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









