Python Beautiful Soup库解析HTML与XML详解
本文详细介绍Python中Beautiful Soup库的使用方法。涵盖安装、四大核心对象(Tag、NavigableString、BeautifulSoup、Comment)的解析,文档树遍历与搜索技巧(find_all、find、select),以及综合实例与lxml对比。
2026-10-15
0
本文详细介绍Python中Beautiful Soup库的使用方法。涵盖安装、四大核心对象(Tag、NavigableString、BeautifulSoup、Comment)的解析,文档树遍历与搜索技巧(find_all、find、select),以及综合实例与lxml对比。
本文介绍如何使用Python Flask框架搭建一个个性化网站,通过抓取高清图片与特定语录数据,结合前端懒加载技术实现流畅浏览体验,并详细讲解使用Gunicorn进行服务部署的具体配置与启动命令。
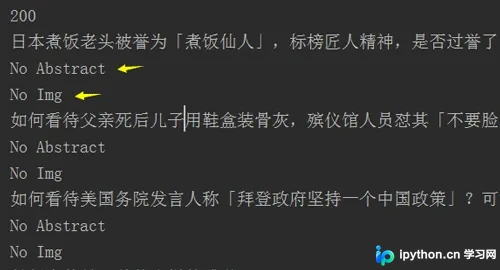
本文分享使用Python异步库aiohttp爬取知乎热榜的完整流程。针对直接解析DOM无法获取摘要和详细链接的问题,通过审查JS代码定位数据源,利用正则表达式提取JSON数据并解析,最终实现标题、热度、摘要、链接及图片的高效抓取。
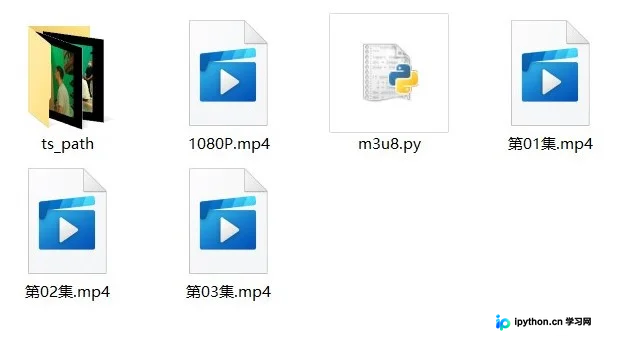
本文详细解析M3U8视频播放原理,介绍如何利用Python脚本抓取.m3u8索引文件及对应的.ts分片文件。通过requests库获取资源链接,结合os系统命令将多个小体积.ts文件合并为完整的mp4视频。文章提供具体操作步骤、代码示例及注意事项,适用于Windows环境下对特定网站视频资源的抓取与本地保存。
本文详细介绍Python中requests-html库的安装与核心用法。该库基于requests封装,支持CSS选择器与XPath定位,并能通过Chromium引擎执行JavaScript实现动态页面爬取。文章涵盖元素提取、分页处理及源码解析,帮助开发者快速掌握现代网页数据抓取技巧。
本文总结了在Python中清洗小说数据时去除HTML标签的三种常用方法。通过对比正则表达式、BeautifulSoup解析器以及lxml库的实际代码示例,展示了如何从混杂HTML的字符串中提取纯文本。此外,还介绍了利用正则表达式移除HTML标签属性的技巧,帮助开发者快速实现数据清洗。
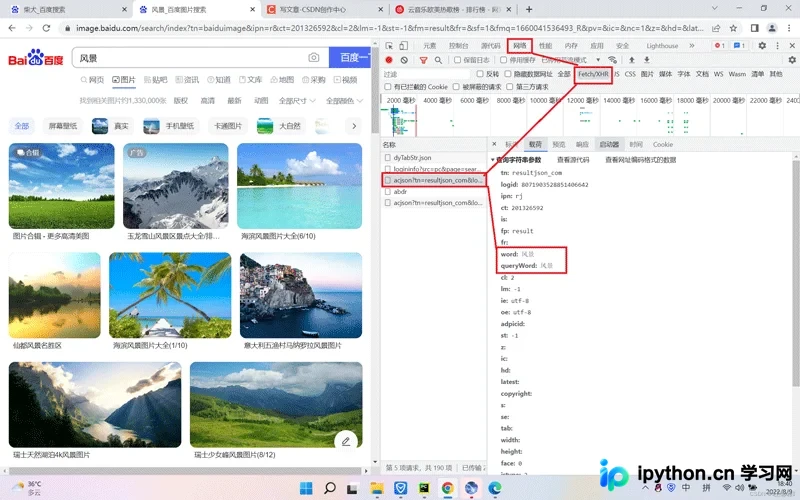
本文详细介绍如何使用Python编写一个简单的图片搜索引擎。通过发送HTTP请求获取网页源码,利用正则表达式筛选图片链接,并模拟浏览器头信息防止被封禁。最终将筛选出的图片二进制数据保存至本地指定文件夹,实现自动化的图片抓取与存储功能。
本文详细介绍了 PHP 进行网页数据采集时遭遇 IP 封禁的多种应对策略。核心方法包括伪装搜索引擎爬虫 User-Agent、伪造 Referer 来源、配置 HTTP 代理或 SOCKS 代理、模拟 X-Forwarded-For 头部,以及利用路由器重启获取新 IP 和修改 MAC 地址以规避更深层次的绑定限制。
本文详细介绍Python中re模块的findall()函数用法。该函数用于在字符串中查找所有匹配正则表达式的子串,并返回包含所有匹配结果的列表。文章通过多个具体代码示例,演示了基础字符匹配、未找到结果的处理、复杂正则模式(如锚点、字符集、数字匹配及取反)的应用,以及结合requests库提取网页Title的实战场景。
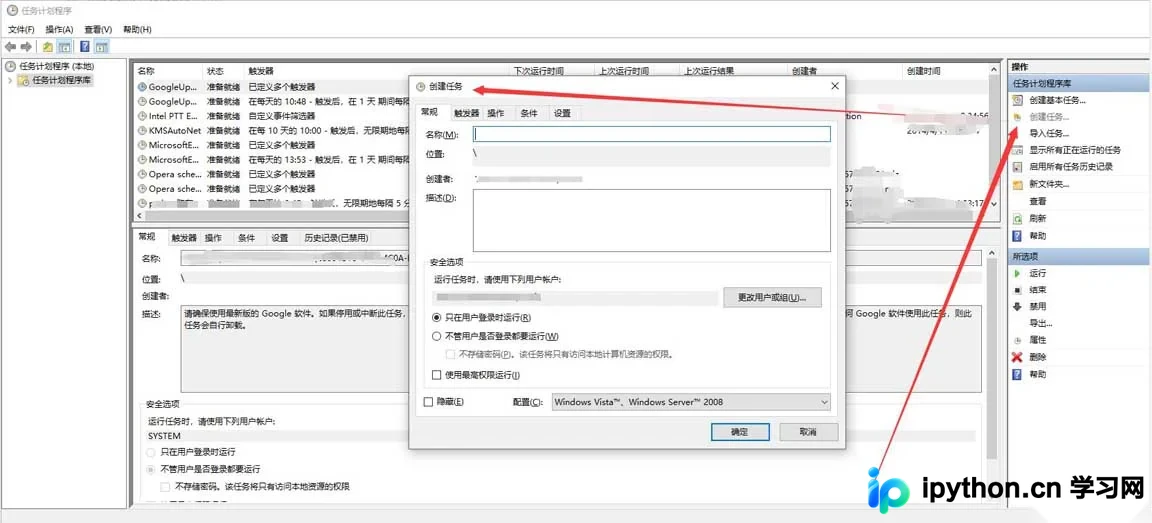
本文详细介绍在Windows系统中利用Python脚本结合Selenium库实现自动化数据采集与更新的方法。内容涵盖通过psutil监控Chrome进程状态、处理长时间未生成数据的异常退出机制,以及利用Windows计划任务实现脚本的周期性自动执行。此外,还包含基于日志的企业微信错误报警集成方案,确保自动化流程的稳定运行。
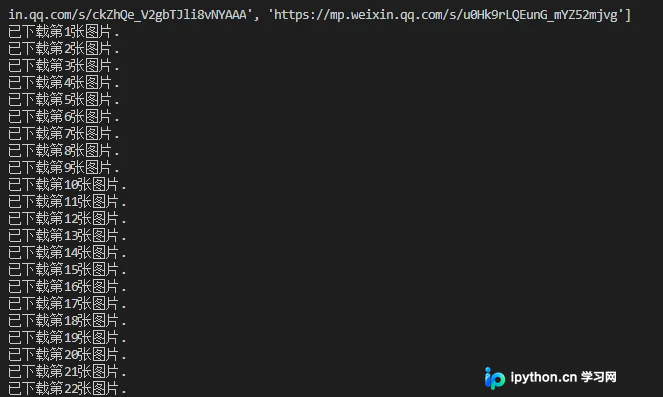
本文介绍使用Python脚本快速保存微信公众号文章图片的方法。通过requests获取HTML,利用BeautifulSoup解析标题与时间,结合正则表达式提取图片URL并保存至本地文件夹。同时附带Python正则匹配日期与时间的示例代码,帮助开发者掌握文本解析技巧,实现自动化内容抓取。
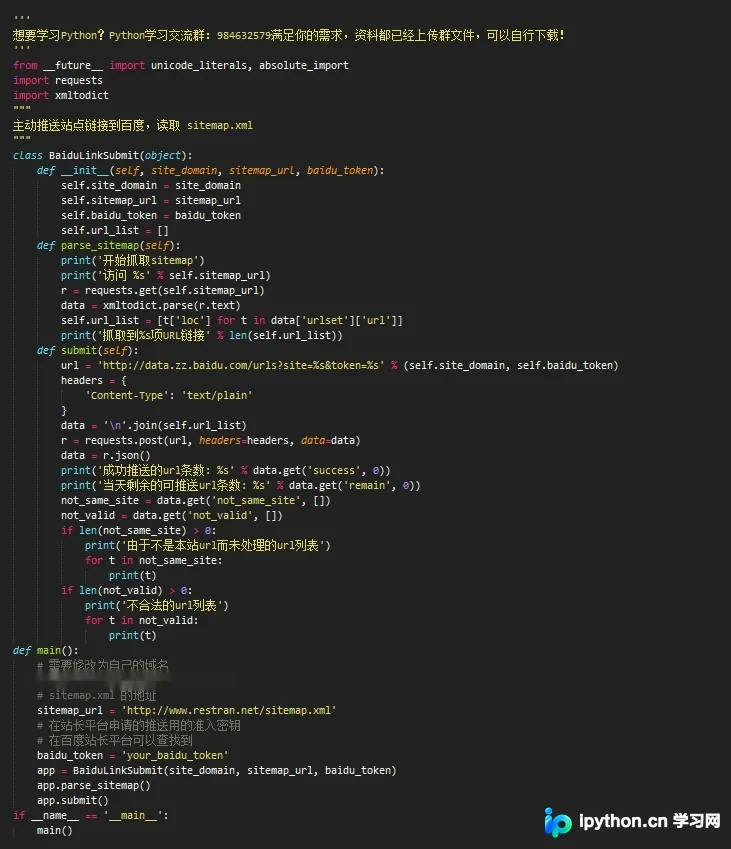
本文介绍如何使用Python脚本实现百度站长平台的主动推送功能,以加速新链接收录。通过抓取指定页面文章链接并调用百度API接口,可批量提交URL。文中提供了基于Python3的完整代码示例,涵盖链接获取、请求构造及状态判断,适用于希望提升搜索引擎收录速度的网站管理员。