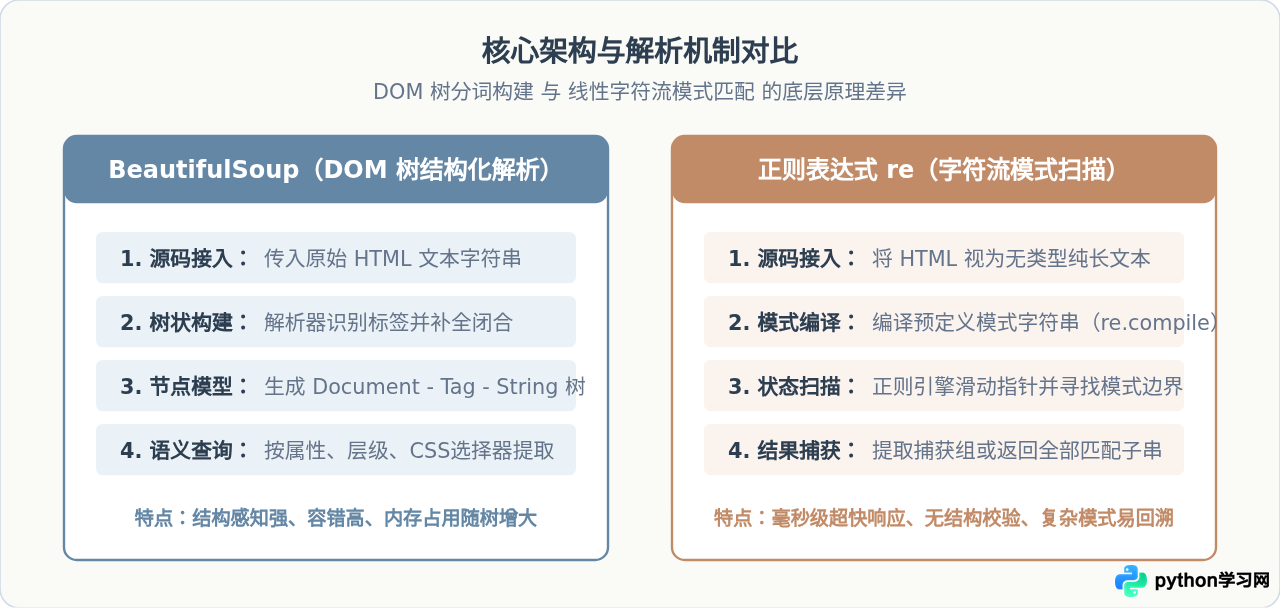
Python爬虫数据解析:BeautifulSoup与正则表达式对比
深入对比Python爬虫开发中两种主流数据解析手段:BeautifulSoup与正则表达式(re),剖析DOM树与字符流解析机制差异、代码实战、容错能力及选型指南。
2026-10-20
0
深入对比Python爬虫开发中两种主流数据解析手段:BeautifulSoup与正则表达式(re),剖析DOM树与字符流解析机制差异、代码实战、容错能力及选型指南。
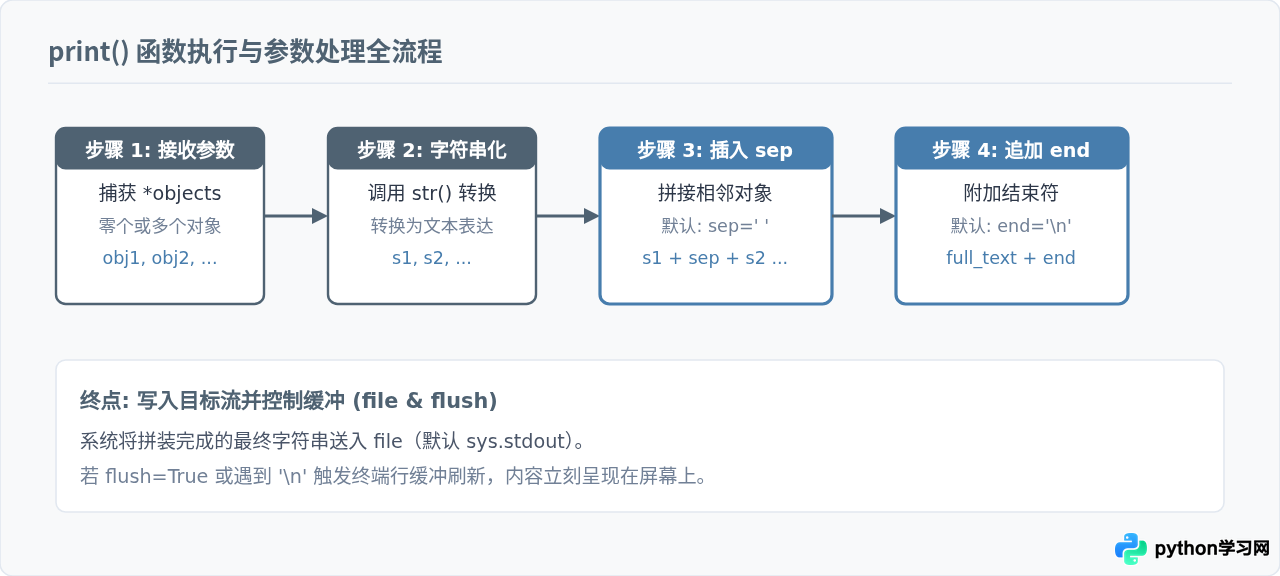
深入解析Python内置print函数的基础语法与核心参数,详细讲解sep分隔符与end结尾符的运行机制、代码示例、组合用法及常见避坑事项。
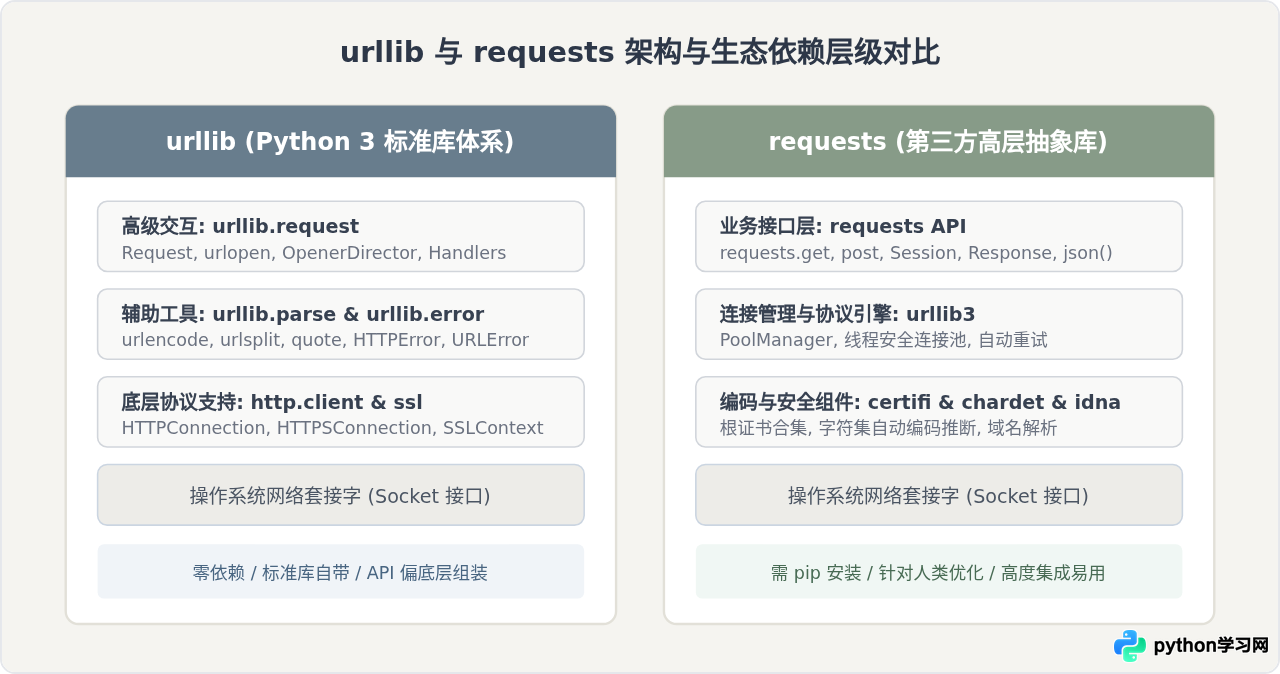
深入对比Python中urllib与requests访问网址的核心区别,从架构定位、代码实现、Cookie管理、连接池复用及适用场景等方面提供具体解析与选型建议。
针对Mac用户详细对比Anaconda与官方Python安装包的核心机制、存储占用、包管理逻辑与环境隔离差异,提供清晰的选型决策树、操作步骤对比与常见问题解答。
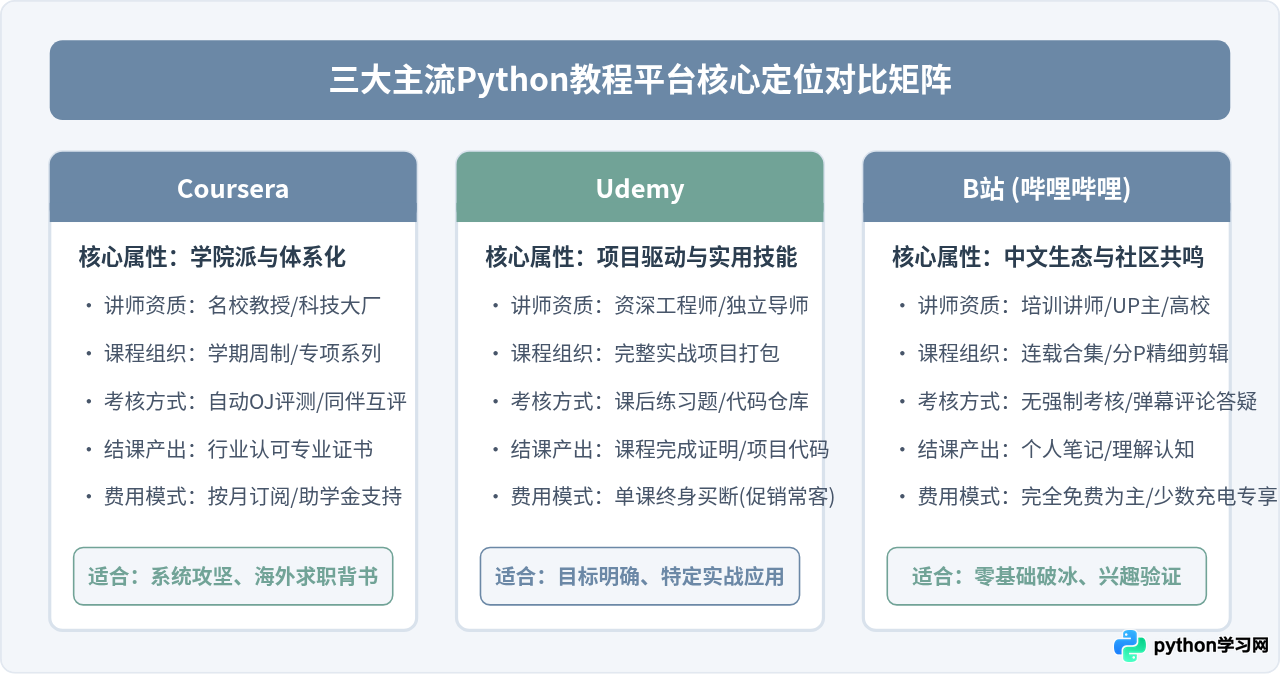
从课程体系、实战项目、练习反馈机制、费用成本与语言门槛等核心维度,深度对比Coursera、Udemy与B站三大主流Python教程平台,帮助不同基础的学习者选择最适合自己的学习路径。
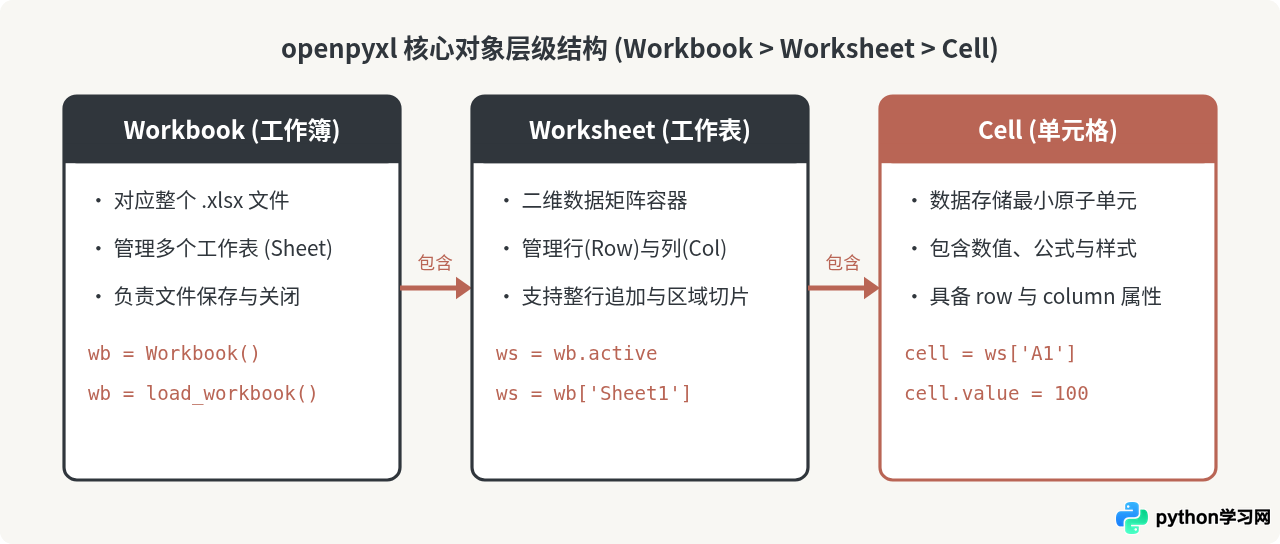
本教程详细讲解如何使用 Python 第三方库 openpyxl 进行 Excel 文件的读取与写入,涵盖工作簿创建、单元格定位、行列遍历及高频避坑要点。
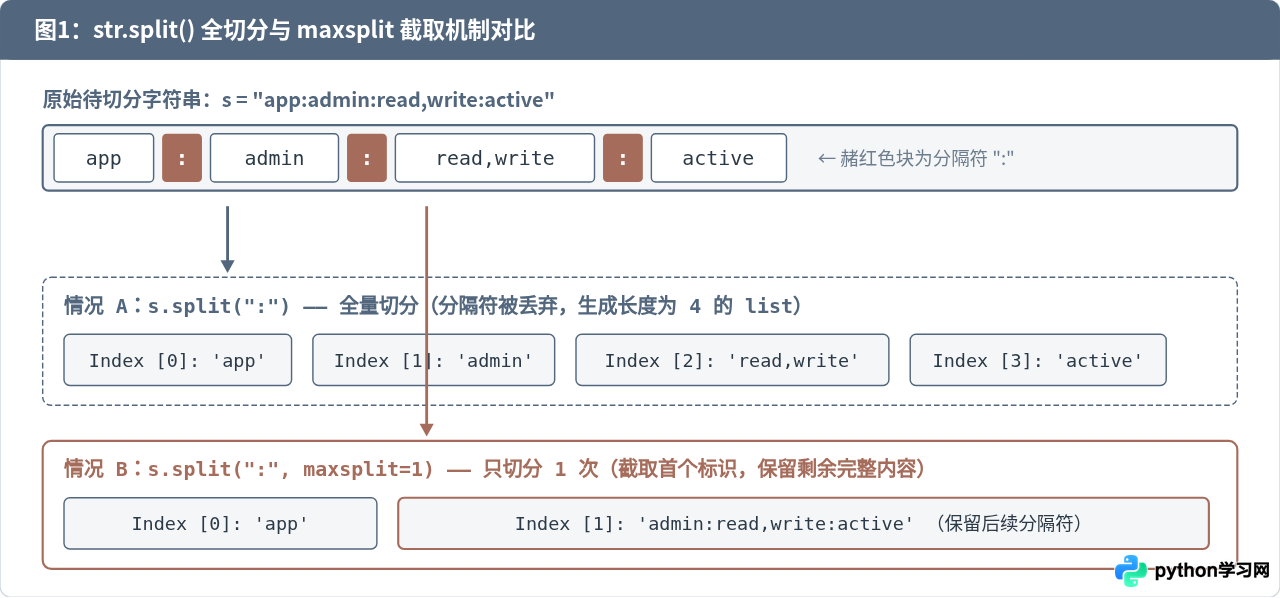
详细解析Python中按分隔符截取字符串的两大核心方法split与partition,结合底层机制、解包技巧、未找到分隔符的边界处理及性能差异,助你精准选择最佳截取方案。
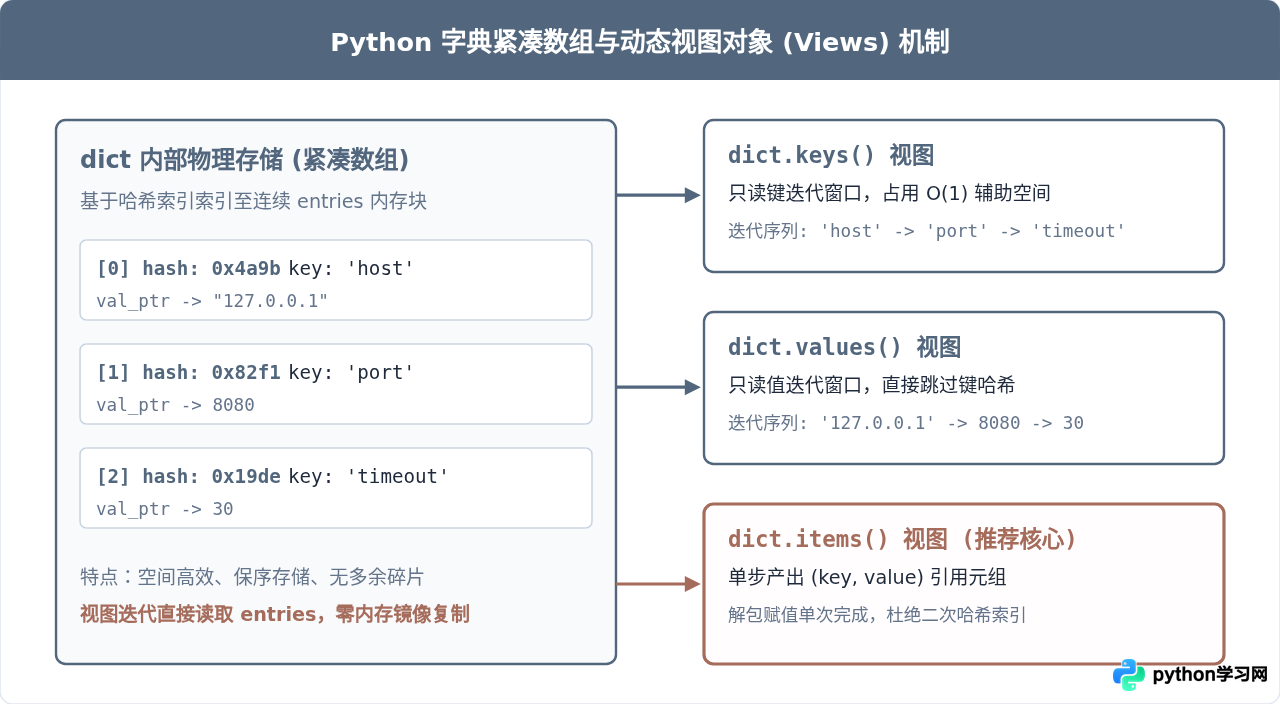
深入解析Python字典遍历的高效方法与底层机制,涵盖dict.items()、dict.keys()、视图对象原理、二次寻址性能损耗分析、遍历中安全增删字典项的最佳实践与排序技巧。
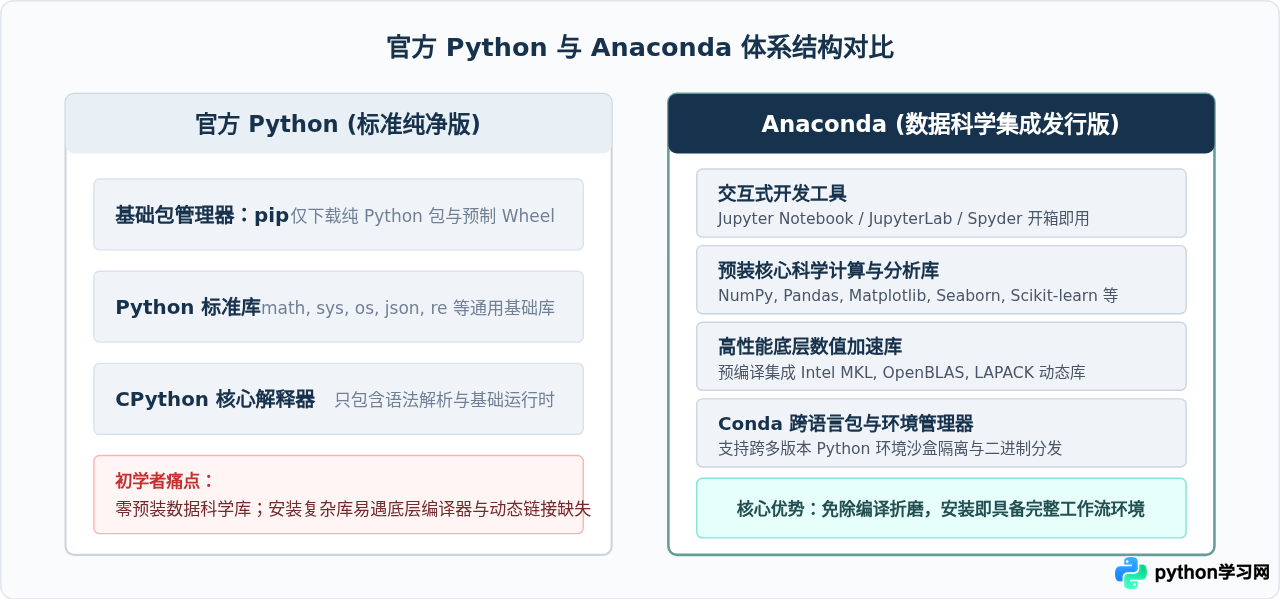
深入解析数据科学初学者为什么首选下载Anaconda而非官方Python。全面对比两者的架构差异、底层二进制依赖解析机制、Conda虚拟环境隔离优势及实际学习流,帮助初学者避开配置陷阱。
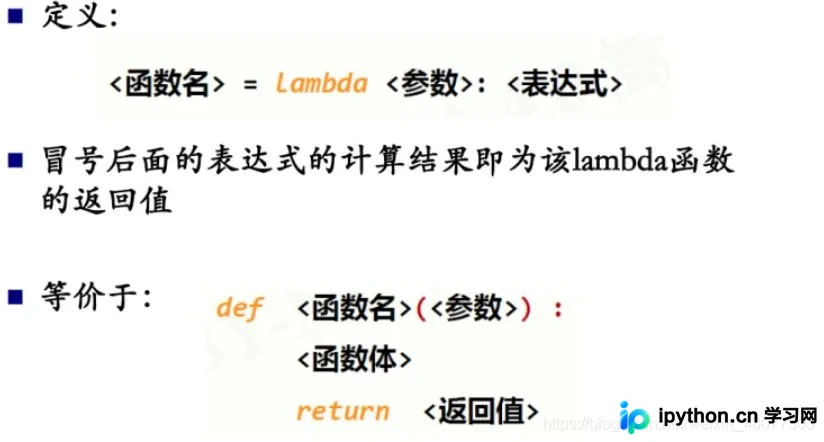
本文深入解析Python中的lambda匿名函数,涵盖其基本语法、单行表达式限制、多参数传递及与map函数的结合使用。同时探讨社区关于lambda使用的争议,对比def定义复杂函数的优劣,帮助开发者根据代码可读性与简洁性需求做出选择。
本文详解Python中IndexError: list index out of range错误的成因与解决方案。当XPath定位不到数据导致列表为空时,直接索引会触发此异常。通过引入try-except异常捕获机制,可将未定位到的元素赋值为None,从而避免程序崩溃,确保爬虫脚本稳定运行。
本文详细介绍Python中wordcloud库的安装方式,包括pip命令行、whl文件及IDE集成安装。通过配置width、height等参数,结合generate生成文本和to_file保存图像,演示如何制作基础词云。最后通过爱心形状遮罩案例,展示如何在指定图形中生成自定义词云文件。