

数据科学初学者为什么推荐下载Anaconda而非官方Python

一、架构与定位差异:纯净解释器与集成工作套件
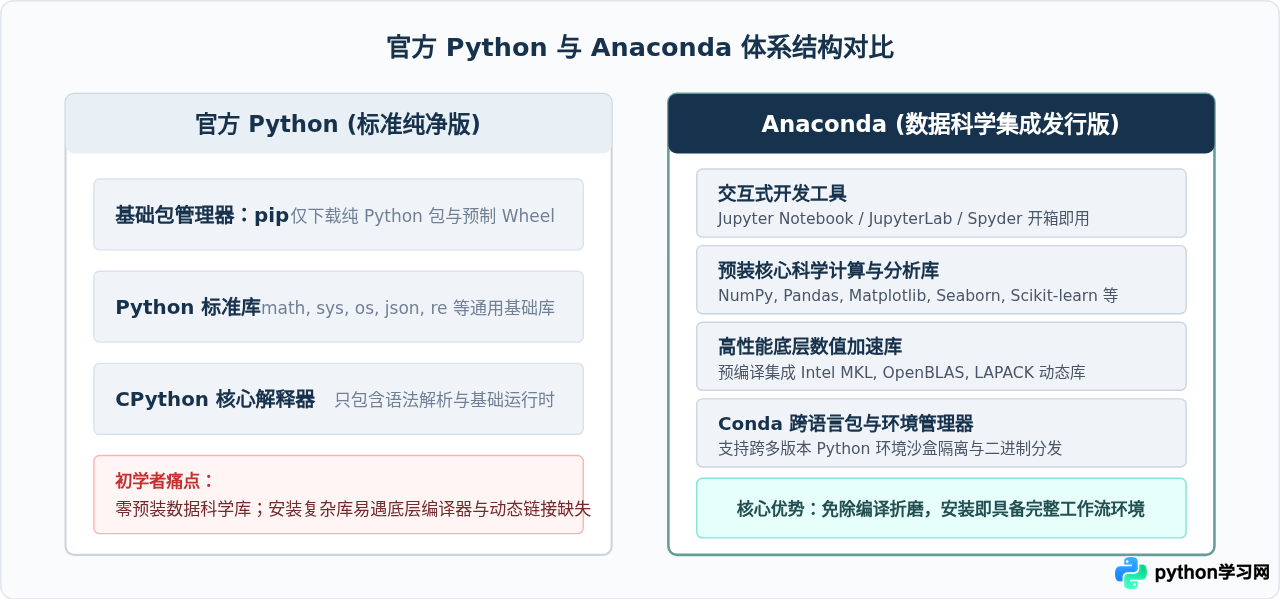
许多初学者容易产生一个误解,认为 Anaconda 和 Python 是两种平行的编程语言。事实并非如此:Python 是一门编程语言的规范,而 python.org 提供的“官方 Python”是最标准的 CPython 核心解释器及最基础的通用标准库。
官方 Python 的设计初衷是保持极简与通用,它不会预判你未来要做什么。无论你是开发网站、编写操作系统运维脚本,还是写爬虫,你都需要通过 pip 命令一个一个地去下载第三方扩展库。
而 Anaconda 是由 Anaconda, Inc. 针对科学计算与数据分析场景打包的专业发行版。它完整包含了官方 Python 解释器,并在其之上预装了超过 250 个数据科学常用的核心库(如 NumPy、Pandas、Matplotlib、Scikit-learn),同时集成了交互式笔记本工具 Jupyter Notebook、JupyterLab 以及跨语言的 Conda 环境管理器。
二、核心痛点:为什么 pip 在科学计算库面前常让初学者受挫
对通用编程而言,通过 pip install requests 或 pip install flask 安装纯 Python 库通常很顺利。但数据科学领域完全不同:NumPy、SciPy、Pandas 这类核心库为了获得极高的数值运算速度,核心计算模块几乎全部采用 C、C++ 以及 Fortran 编写,底层依赖诸如 BLAS、LAPACK、Intel MKL 等底层线性代数库。
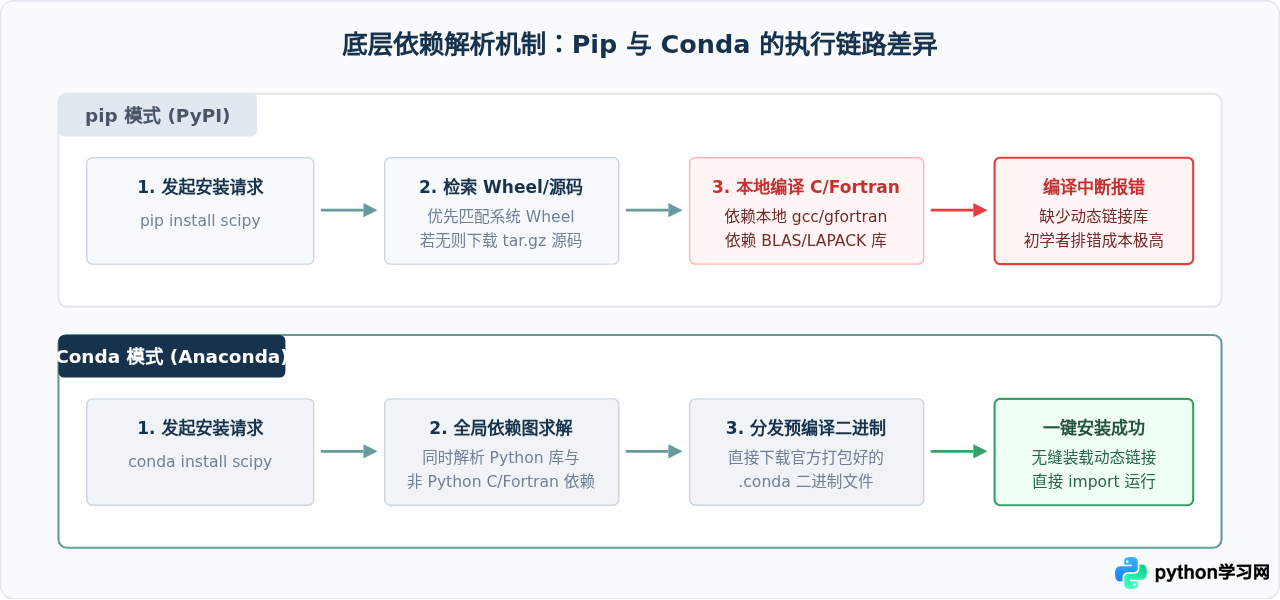
当初学者在官方 Python 中运行 pip 安装时,常见的问题链路如下:
- 平台轮子匹配缺失: 如果 PyPI 上没有恰好适配当前系统架构、操作系统版本或 Python 小版本的预编译二进制 Wheel 包,pip 就会自动下载源码包(.tar.gz)。
- 本地编译失败: 一旦退回到源码构建阶段,系统就会调用本地的 C/C++ 编译器。Windows 环境通常没有预装 Microsoft Visual C++ Build Tools,macOS 或 Linux 也可能缺少 gfortran 或对应的底层库头文件。
- 产生难以理解的报错信息: 终端会抛出长达上百行的 C 语法错误、符号未定义或
Microsoft Visual C++ 14.0 or greater is required,这对尚未掌握编译知识的初学者来说是巨大的挫败。
而 Conda 是一个跨语言的二进制包管理器。Conda 仓库中的每一个包,都是由官方工程团队在对应操作系统上完成编译、静态/动态链接并严格测试后的二进制产物。安装时只需要将文件解压并链接到目标目录,不依赖读者的本地编译环境。
三、虚拟环境管理能力:为什么初学者需要跨版本隔离沙盒
在数据科学实践中,环境冲突非常频繁。例如:今天你在跟着一本教程跑基于 Python 3.8 的旧版 TensorFlow 项目,明天你又想尝试要求 Python 3.11 及以上版本的最新大语言模型库。
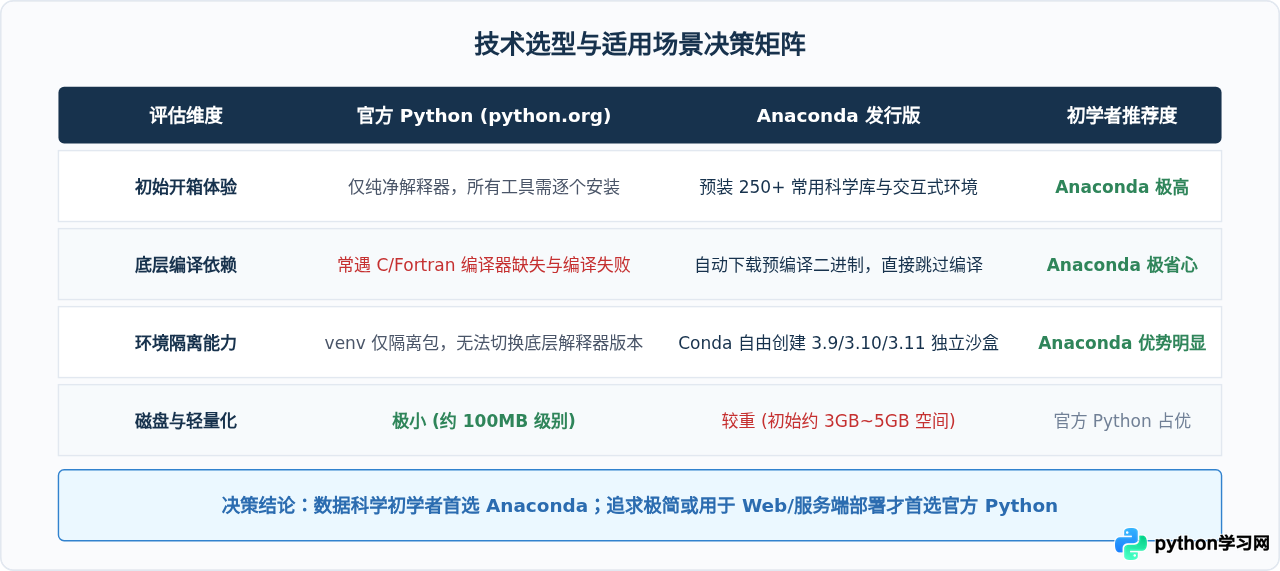
官方 Python 附带的 venv 模块虽然可以创建隔离环境,但它的隔离范围仅限于 site-packages 目录下的纯 Python 包。它无法改变环境内部的 Python 主版本(如果你系统装的是 Python 3.12,venv 创建出来的就只能是 3.12),更无法管理不同版本所需的底层 C 运行时库。
Conda 则是真正的系统级环境隔离工具:
- 一条命令即可在系统中同时拥有 Python 3.8、3.10、3.11 等多个完全独立的解释器实例。
- 每个环境拥有自己独立的二进制库路径与依赖树,彼此互不干扰。
- 当某个实验环境被破坏或不再需要时,只需整包删除该环境即可彻底清理,完全不会污染操作系统的全局环境。
四、数据科学初学者标准配置与验证步骤
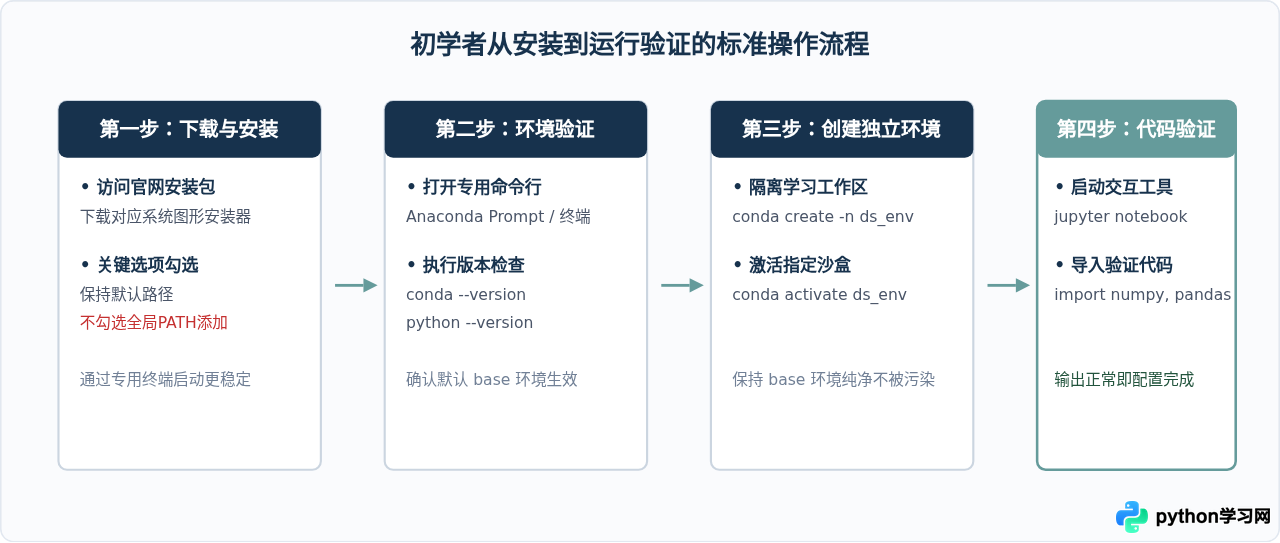
为了让初学者能够稳定上手,以下整理出规范的安装选项与第一步验证流程:
1. 安装时的关键选项提醒
在安装向导中(尤其 Windows 平台),会看到一个选项:“Add Anaconda3 to my PATH environment variable”。官方通常将这一项标记为红字并不建议勾选。初学者建议保持默认的不勾选状态。
这是因为强制添加到全局 PATH 可能会篡改操作系统的系统命令解析顺序,导致与其他软件或系统自带 Python 产生冲突。正确的做法是使用开始菜单中的“Anaconda Prompt”或在 macOS 终端中利用 conda init 进行环境激活。
2. 命令行创建与验证命令
打开 Anaconda Prompt(Windows)或终端(macOS/Linux),执行以下命令验证环境并创建专属学习沙盒:
# 检查 conda 与 python 版本
conda --version
python --version

# 创建一个名为 ds_learn 的专用数据科学环境,指定 Python 3.10
conda create -n ds_learn python=3.10

# 激活该环境
conda activate ds_learn

# 在新环境中安装数据科学核心套件与 jupyter
conda install numpy pandas matplotlib seaborn jupyter
3. 启动 Jupyter Notebook 运行第一行验证代码
在激活的环境中直接输入命令启动 Jupyter Notebook:
jupyter notebook浏览器将自动打开交互界面。新建一个 Notebook 并运行以下代码:
import numpy as np
import pandas as pd

# 创建简单数据并验证矩阵运算
data = {'A': [1, 2, 3], 'B': [4, 5, 6]}
df = pd.DataFrame(data)
print("Pandas 数据框生成正常:")
print(df)
print("\nNumPy 矩阵均值:", np.mean(df.values))
如果控制台顺利输出数据框内容且无任何动态链接或模块缺失警告,即说明整个科学计算环境已经健全就绪。
五、选型权衡与决策矩阵
虽然 Anaconda 在数据科学初学阶段优势压倒性显著,但客观认识其资源开销与适用边界,有助于初学者建立合理的技术选型认知:
哪些情况下应该坚持用官方 Python?
- Web 后端开发: 如果主要方向是 Django、FastAPI、Flask 等框架,其依赖通常是纯 Python 或由轮子支持良好的网络库,无需庞大的科学计算包。
- 云服务器与 Docker 镜像构建: 在资源有限的服务器或容器生产环境中,官方 Python 的镜像体积往往仅有几十兆,远比 Anaconda 轻巧。
- 设备磁盘空间极度受限: 如果本地电脑硬盘仅剩微量空间,无法承受 Anaconda 初始数 GB 的体积。不过在这种情况下,更推荐折中方案 Miniconda(仅保留 Python 与 Conda 核心,体积仅约百兆,兼具 Conda 的二进制管理能力)。
六、初学者常见疑问与误区排查
完全不会。Anaconda 内部使用的就是正统的 CPython 解释器,语法、运行逻辑与官方 Python 完全一致。你在 Anaconda 中编写的任何 Python 脚本,迁移到官方 Python 环境中都能完全正常执行。
可以。推荐的优先级是:能用 conda 安装的优先用 conda install;如果在 conda 渠道中找不到特定库,再使用 pip install 进行补充。避免在没有激活环境的情况下全局盲目混用 pip,即可保持依赖树的稳定。
可以并存。只要在安装 Anaconda 时不要勾选“强制添加 PATH”,并通过 Anaconda 提供的独立启动方式(如 Anaconda Prompt 或 IDE 内部指定解释器路径),两者在硬盘上各存各的文件,互不干扰。
总结
对数据科学初学者而言,学习路线的重心应该放在探索数据规律、理解数学统计原理、编写分析逻辑与模型评估上,而不是在尚未写出第一行有效代码之前,就耗费数小时去排查 C 编译器缺失或底层链接库冲突。
Anaconda 恰恰通过预先打包的科学库生态、免编译的二进制包分发以及稳固的环境隔离机制,抹平了操作系统底层的复杂度。这也是无论高校课程还是工业界数据团队,普遍推荐初学者将 Anaconda 作为第一站的核心原因。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









