

Python中Winsorize缩尾处理:空值与无效值的正确处理方法
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
2026-10-16
0
本文记录Python中使用scipy.stats.mstats.winsorize进行数据缩尾处理时的常见陷阱。直接应用会导致空值被填充,介绍通过np.where、masked_invalid或布尔索引mask三种方式屏蔽空值与无效值的正确做法,并说明如何处理后续出现的负无穷值问题,确保缩尾后数据长度不变且空值保留。
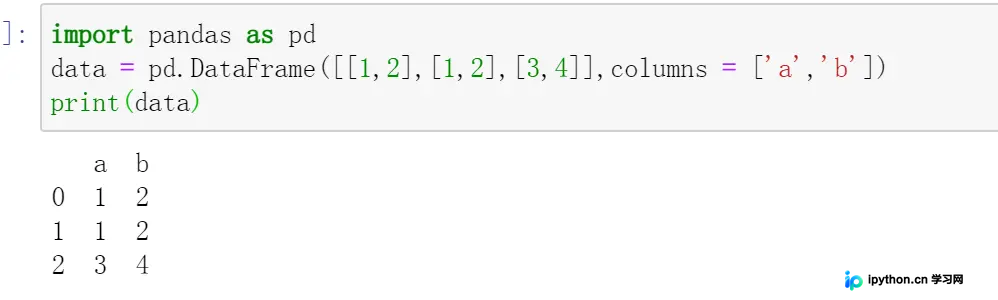
本文详细解析Python pandas库中pd.cut()与pd.qcut()两个数据离散化函数的区别。pd.cut()基于固定区间或数量进行等距划分,而pd.qcut()基于分位数确保各区间样本数量一致。文章通过具体代码示例对比了参数如bins、q、right、include_lowest及duplicates的使用场景,帮助开发者根据数据分布特征选择合适的离散化方法。
本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。
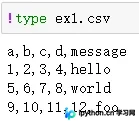
本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。
本文详细介绍如何使用Python的Pandas库对CSV文件进行创建、读取和修改操作。通过具体代码示例,演示如何从Numpy数组生成DataFrame并保存为CSV,以及如何读取CSV文件并转换为数组。此外,还涵盖了列与行的增删改操作及索引重置,帮助开发者高效处理结构化数据。
本文总结了6个常用的Pandas数据处理技巧,帮助开发者高效处理数据。内容涵盖快速定位含缺失值的行、根据条件替换列值、使用pd.cut进行数据分箱统计、利用split拆分文本列、通过正则表达式筛选中文字段,以及调整列顺序的两种方法。掌握这些代码片段能显著提升数据清洗与处理的效率。
本文详解pandas中read_csv与read_table函数的数据读取方法,涵盖分隔符指定、表头处理、索引设置及缺失值标识配置。同时介绍to_csv导出技巧、header与index_col参数用法,以及利用chunksize实现大文件分块读取和聚合操作,帮助高效处理文本格式数据。
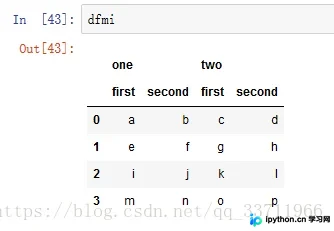
本文介绍在Pandas中修改DataFrame值时如何避免链式索引(Chained Indexing)导致的SettingWithCopyWarning。通过对比直接链式访问与使用loc方法的差异,说明直接标签访问的潜在问题,并推荐正确的赋值方式以确保数据修改生效。
本文详细介绍Python Pandas库中的基本数据操作,涵盖索引选取、赋值修改及排序功能。通过股票数据示例,演示如何使用直接索引、loc、iloc及ix进行数据提取,讲解DataFrame与Series的赋值方法,并深入解析按值与按索引排序的参数设置与实现细节。
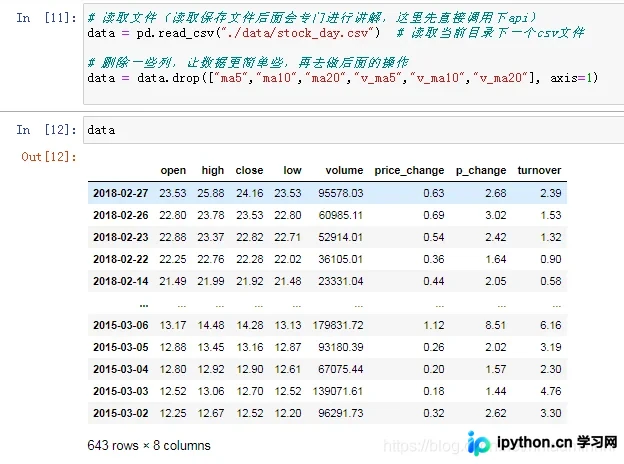
本文整理了八个Python数据清洗的常见场景及对应代码,涵盖删除多列、转换数据类型、分类变量数值化、检查缺失值、处理字符串异常及空格、条件拼接字符串以及时间戳转换。通过封装函数,帮助开发者高效完成数据预处理工作,提升数据分析效率。
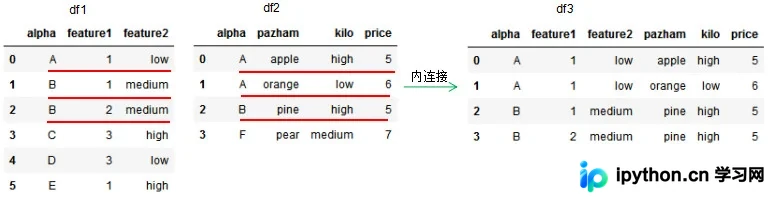
本文详解Python pandas库中数据合并与拼接的三种核心方法:merge、join和concat。重点解析merge基于列的内、外、左、右连接参数,join基于索引的连接方式,以及concat对Series和DataFrame的行/列拼接操作,涵盖多列连接、索引处理及常见报错解决方案。
本文详解Python Pandas中dropna()方法删除特定行与列的参数用法,包括axis、how、thresh和subset。针对仅基于单列缺失值删除行的需求,提供通过fillna填充后索引定位删除的替代方案,帮助精准过滤数据。