

Python Pandas基本数据操作指南:索引、赋值与排序

本文详细介绍Python Pandas库中的基本数据操作,涵盖索引选取、赋值修改及排序功能。通过股票数据示例,演示如何使用直接索引、loc、iloc及ix进行数据提取,讲解DataFrame与Series的赋值方法,并深入解析按值与按索引排序的参数设置与实现细节。
为了更直观地理解这些基础操作,下文将借助读取股票数据文件的方式,逐步介绍Pandas中基本数据操作的语法用法。
# 读取文件(读取保存文件后面会专门进行讲解,这里先直接调用下api)
data = pd.read_csv("./data/stock_day.csv")  # 读取当前目录下一个csv文件

# 删除一些列,让数据更简单些,再去做后面的操作
data = data.drop(["ma5","ma10","ma20","v_ma5","v_ma10","v_ma20"], axis=1)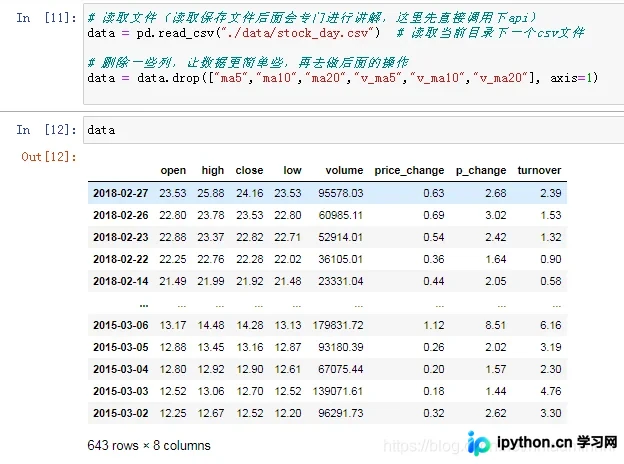
1 索引操作
在之前的Numpy章节中,我们已经讨论过利用索引选取序列以及进行切片选择的方法。Pandas同样支持这类操作,并且允许用户直接通过列名或行名称进行选取,甚至可以将两者结合使用。
1.1 直接使用行列索引(先列后行)
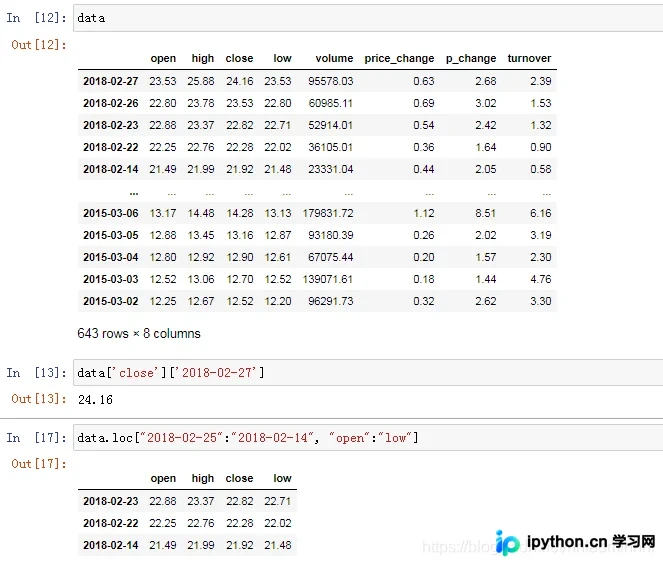
例如,我们需要获取2018-02-27这一天的收盘价,即提取'2018-02-27'日期对应的'close'列的值。
# 直接使用行列索引名字的方式(先列后行)
data['close']['2018-02-27']
24.16

# 不支持的操作
# 错误
data['2018-02-27']['close']
# 错误
data[:1, :2]
1.2 结合loc或iloc使用索引
获取从'2018-02-27'到'2018-02-22'期间'close'列的数据结果。
# 使用loc:只能指定行列索引的名字
data.loc["2018-02-25":"2018-02-14", "open":"low"]
# 使用iloc可以通过索引的下标去获取
# 获取前3天数据,前5列的结果
data.iloc[:3, :5]

            open    high    close    low
2018-02-27    23.53    25.88    24.16    23.53
2018-02-26    22.80    23.78    23.53    22.80
2018-02-23    22.88    23.37    22.82    22.71
1.3 使用ix组合索引
获取第1天到第4天的数据,并提取['open', 'close', 'high', 'low']这四个指标的结果。
# 使用ix进行下表和名称组合做引
data.ix[0:4, ['open', 'close', 'high', 'low']]

# 推荐使用loc和iloc来获取的方式
data.loc[data.index[0:4], ['open', 'close', 'high', 'low']]
data.iloc[0:4, data.columns.get_indexer(['open', 'close', 'high', 'low'])]

            open    close    high    low
2018-02-27    23.53    24.16    25.88    23.53
2018-02-26    22.80    23.53    23.78    22.80
2018-02-23    22.88    22.82    23.37    22.71
2018-02-22    22.25    22.28    22.76    22.02
2 赋值操作
对DataFrame中的close列进行重新赋值,将所有值设置为1。
# 直接修改原来的值
data['close'] = 1
# 或者
data.close = 1
3 排序
排序操作主要分为两种形式:一种是针对索引进行排序,另一种是针对数据内容进行排序。
3.1 DataFrame排序
使用df.sort_values(by=, ascending=)函数进行排序。
支持单个键或多个键进行排序操作。
相关参数说明如下:
1.by:指定用于排序参考的键名。
2.ascending:默认值为升序排列。
- ascending=False:表示降序排列。
- ascending=True:表示升序排列。
# 按照开盘价大小进行排序 , 使用ascending指定按照大小排序,取前5行数据
data.sort_values(by="open", ascending=True).head()

# 按照多个键进行排序
data.sort_values(by=['open', 'high'])
使用df.sort_index函数对索引进行排序。
股票的日期索引原本是从大到小排列,现在通过排序将其重新调整为从小到大排列。
# 对索引进行排序
data.sort_index()
3.2 Series排序
使用series.sort_values(ascending=True)方法进行排序。
对Series进行排序时,由于只有一列数据,因此不需要额外指定参数。
data['p_change'].sort_values(ascending=True).head()

2015-09-01   -10.03
2015-09-14   -10.02
2016-01-11   -10.02
2015-07-15   -10.02
2015-08-26   -10.01
Name: p_change, dtype: float64
使用series.sort_index()进行排序,其用法与DataFrame的方法一致。
# 对索引进行排序
data['p_change'].sort_index().head()

2015-03-02    2.62
2015-03-03    1.44
2015-03-04    1.57
2015-03-05    2.02
2015-03-06    8.51
Name: p_change, dtype: float64
至此,关于Python Pandas基本数据操作的详细介绍完毕,更多相关Python Pandas数据操作内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









