

MySQL索引底层数据结构详解:B+树、聚簇与非聚簇索引
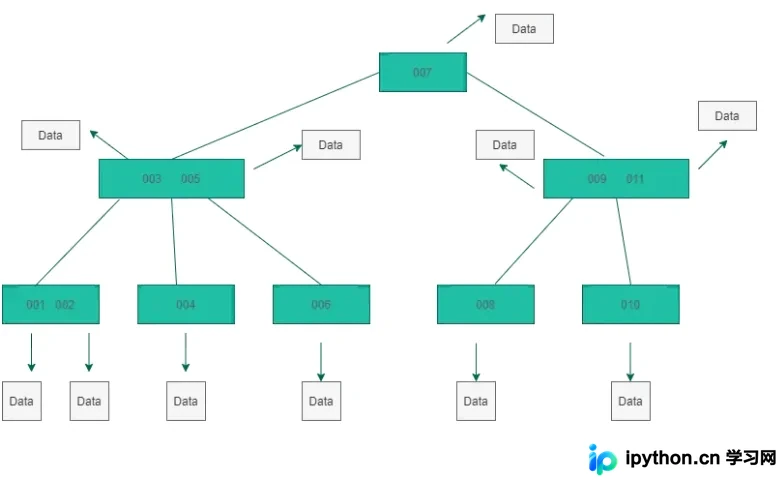
深入解析MySQL索引的底层数据结构,对比B树与B+树差异,阐明InnoDB中聚簇索引与非聚簇索引(二级索引)的实现机制。涵盖回表查询、覆盖索引优化及哈希索引适用场景,帮助理解数据库高效查询的原理。
2026-10-16
0
深入解析MySQL索引的底层数据结构,对比B树与B+树差异,阐明InnoDB中聚簇索引与非聚簇索引(二级索引)的实现机制。涵盖回表查询、覆盖索引优化及哈希索引适用场景,帮助理解数据库高效查询的原理。
在 MySQL 中使用 NOT IN 进行子查询时,若子查询结果包含 NULL 值,最终查询将返回空结果。这是因为 NOT IN 底层等价于多个 != 条件的 AND 组合,而任何值与 NULL 的比较结果均为 NULL(视为 FALSE)。本文详解其底层逻辑,并提供过滤 NULL 或改用 NOT EXISTS 的可靠解决方案。
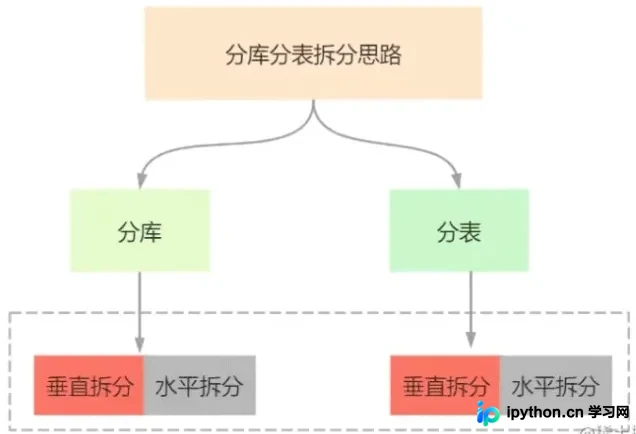
面对高并发和数据量增长,MySQL 分库分表是提升性能的关键手段。本文详细解析垂直拆分与水平拆分的逻辑、优缺点及适用场景,对比 ShardingSphere 与 MyCAT 等主流中间件的直连与代理层差异,并提供分布式事务、全局 ID 及跨库 Join 等核心问题的处理思路,帮助开发者根据业务特性选择最佳架构方案。
本文详解MySQL字符集工作原理,重点解析client、connection、server及results四层交互机制。通过set names gbk指令统一客户端写入与服务器读取编码,解决乱码问题,并提供查看变量与插入中文数据的完整实操示例。
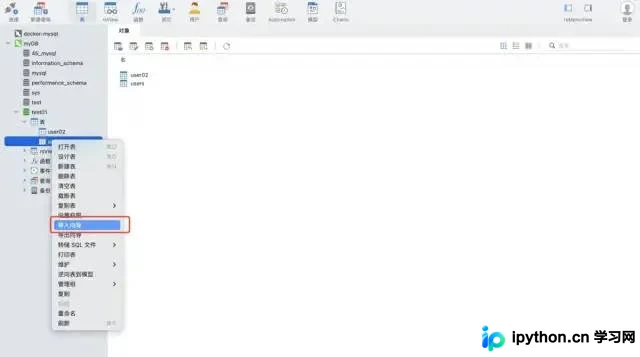
本文系统分享将千万级数据写入 MySQL 的两种场景及对应方案。针对非频繁写入,推荐使用 Navicat 导入向导;针对增量自动化写入,对比了 Pymysql 与 Pandas+SQLAlchemy 两种 Python 实现方式。测试显示,Pandas 方案仅需五行代码且耗时约 4 分钟,远优于 Pymysql 的 12 分 47 秒,且无需预先建表,推荐作为高效首选。
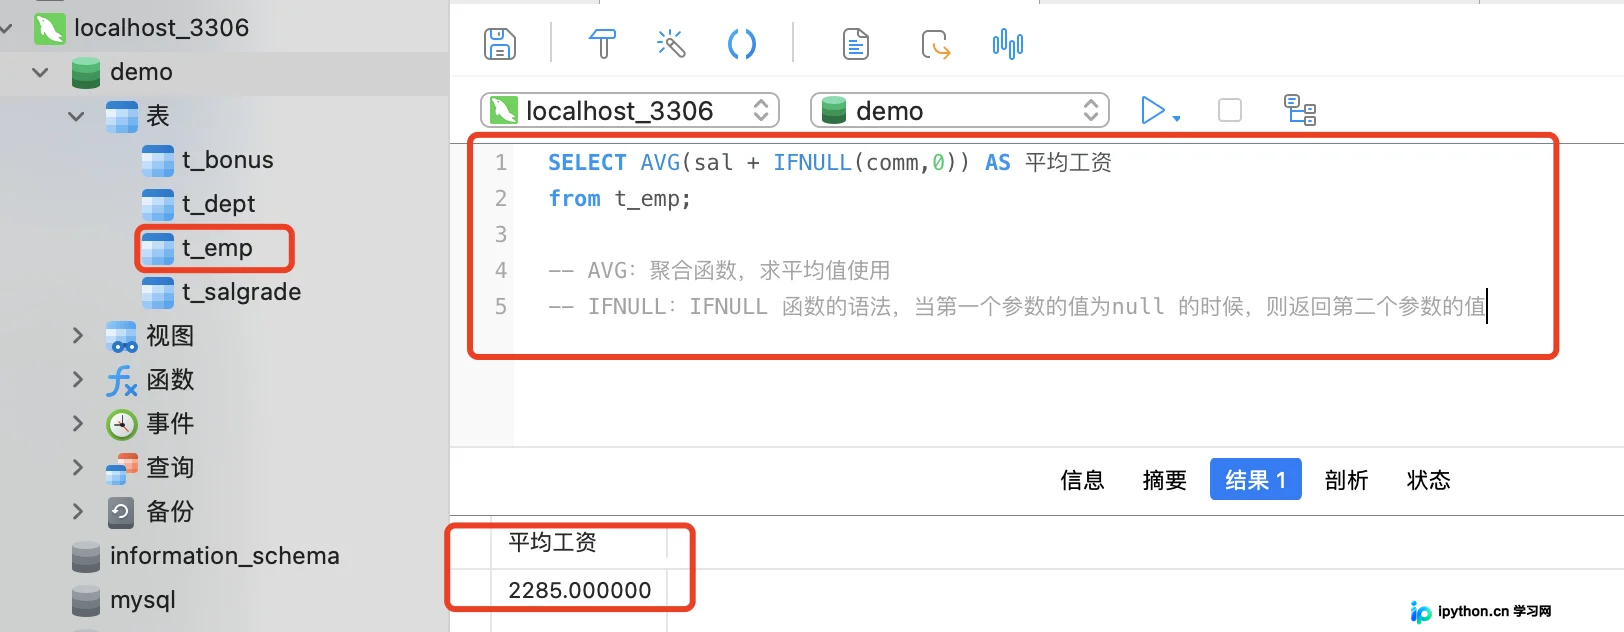
本文详细介绍MySQL中常用聚合函数的使用方法,包括求和(SUM)、最大值(MAX)、最小值(MIN)、平均值(AVG)及计数(COUNT)。通过员工表示例演示各函数在整表统计中的应用,重点解析COUNT(*)与COUNT(列名)的区别,并深入探讨为何聚合函数不能直接出现在WHERE子句中及其背后的执行顺序原理。
在MySQL中直接解析包含多个对象的JSON数组字符串较困难。本文介绍通过SUBSTRING_INDEX函数配合自增ID表(或help_topic),将JSON数组拆分为独立行,再利用JSON_EXTRACT提取具体字段的方法。该方法无需自定义存储过程,适用于单行文本批量解析场景。
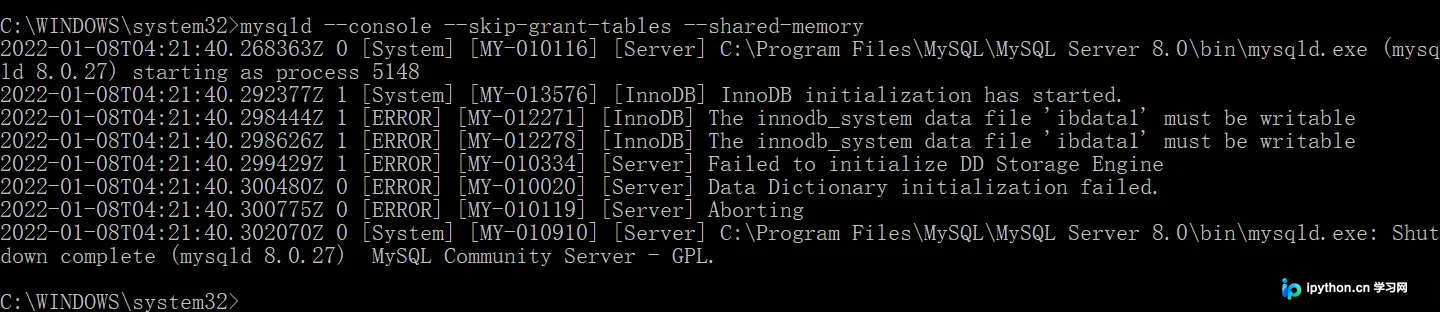
针对 MySQL 无法登录或遗忘 root 密码的问题,本文提供两种基于 Windows 环境的有效解决方案。方法一通过管理员命令行以 skip-grant-tables 参数启动 mysqld,配合 flush privileges 完成无密登录后修改密码;方法二通过转移数据目录并重新执行初始化命令生成新密码。文章包含详细的代码指令、截图说明及端口配置技巧,适用于 MySQL v8.0 版本。
面对日均百万级增长的 MySQL 日志表,本文对比了老数据归档、应用层分表及迁移至 TiDB 三种方案。重点复盘迁移 TiDB 过程中遇到的主键冲突难题,并分享基于 Redis 状态记录的断点续传同步脚本设计,实现平滑迁移且避免线上阻塞。
本文解决如何在MySQL中筛选“进行中”状态的数据,核心在于处理开始或结束时间可能为空的情况。通过 `IS NULL` 结合 `NOW()` 函数,实现四种时间边界条件的统一查询。同时提供MyBatis动态SQL的XML配置示例,确保参数灵活传入时逻辑依然准确。
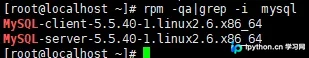
本文详细介绍在CentOS 7系统中通过RPM包手动安装MySQL 5.5的完整流程。内容涵盖卸载旧版本残留文件、解压并安装服务端与客户端、设置初始密码及开机自启,最后提供开启3306端口及授权root用户远程连接的详细命令,解决本地无法直连生产环境数据库的问题。
在MySQL中,使用UNSIGNED INT存储IPv4地址比VARCHAR更节省空间且查询更快。本文详解利用INET_ATON和INET_NTOA函数实现字符串IP与整数的相互转换,并提供Java应用层转换逻辑及IPv6的VARBINARY方案,帮助开发者构建高效的数据库存储结构。