

MySQL索引底层数据结构详解:B+树、聚簇与非聚簇索引

本文深入解析MySQL索引的底层数据结构,重点讲解B+树与B树的优劣对比,以及InnoDB引擎中聚簇索引和非聚簇索引(二级索引)的实现方式。通过图表展示数据分布规律,剖析回表查询机制与覆盖索引优化策略,帮助读者透彻理解数据库高效查询原理。
为什么选择B+树作为核心结构?
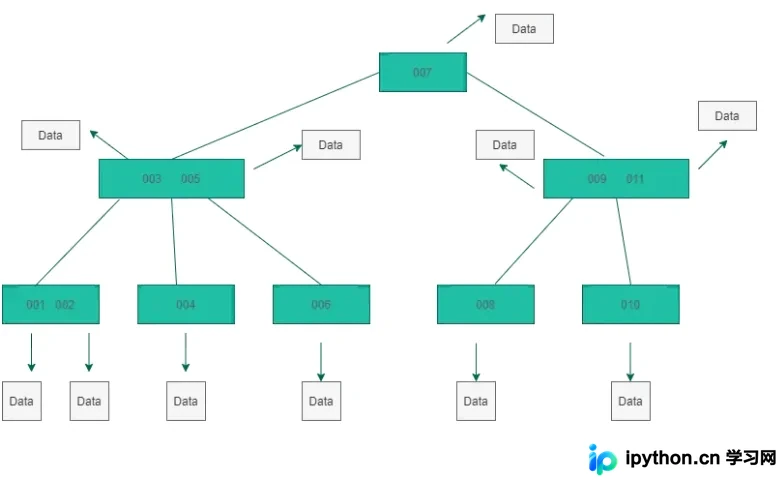
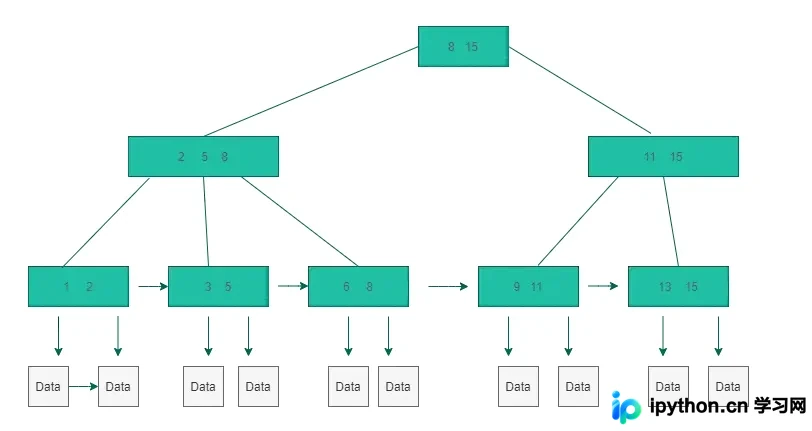
在关系型数据库中,B+树因其在磁盘IO和范围查询上的优势,成为主流索引结构。与B树相比,B+树具有以下显著区别:
- 数据存储位置不同:B树在每个节点都存储卫星数据(即整行数据),而B+树仅在叶子节点存储完整数据,非叶子节点仅存储索引键值。这意味着在相同大小的磁盘页(如16KB)中,B+树能容纳更多的索引项,从而降低树的高度,减少磁盘IO次数。
- 查询效率稳定性:B+树的所有数据都在叶子节点上,任何查找都必须走到叶子节点,路径长度一致;而B树可能在非叶子节点找到目标,最快时间复杂度可达O(1),但最慢情况需遍历到底层,效率不稳定。
- 区间查询能力:B+树的叶子节点通过双向链表连接,天然支持高效的范围扫描(Range Scan)。相比之下,B树进行范围查询时需要中序遍历,效率较低。
InnoDB的聚簇索引实现机制
InnoDB是一种聚簇索引(Clustered Index)存储引擎,其数据组织方式具有特殊性。
1. 什么是聚簇索引?
聚簇索引将数据行直接存储在B+树的叶子节点中。InnoDB优先使用主键(Primary Key)作为聚簇索引的键值;若未定义主键,则选择第一个唯一且非空的索引列;若两者皆无,InnoDB会隐式生成一个自增的主键列作为聚簇索引。
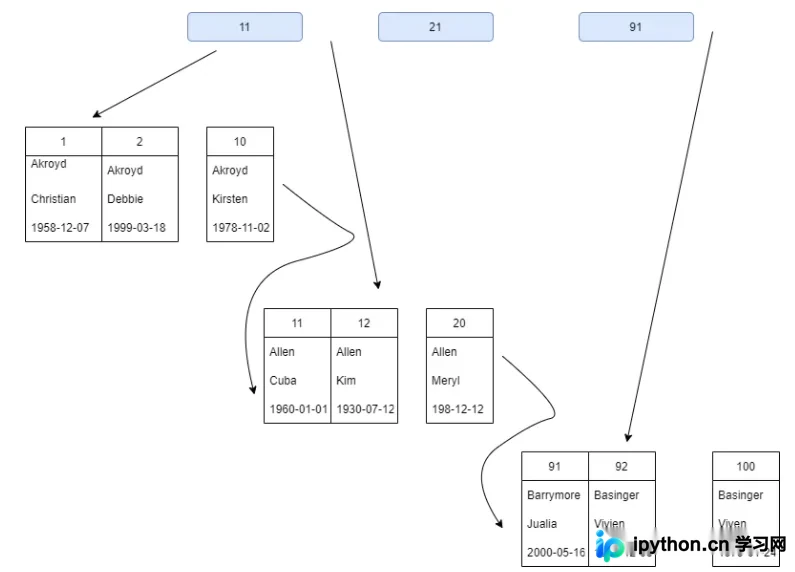
注意:在InnoDB的聚簇索引叶子节点中,除了包含用户定义的列数据外,还隐含包含了事务ID(DB_TRX_ID)、回滚指针(DB_ROLL_PTR)等系统字段,用于支持MVCC(多版本并发控制)。
2. 二级索引与“回表”查询
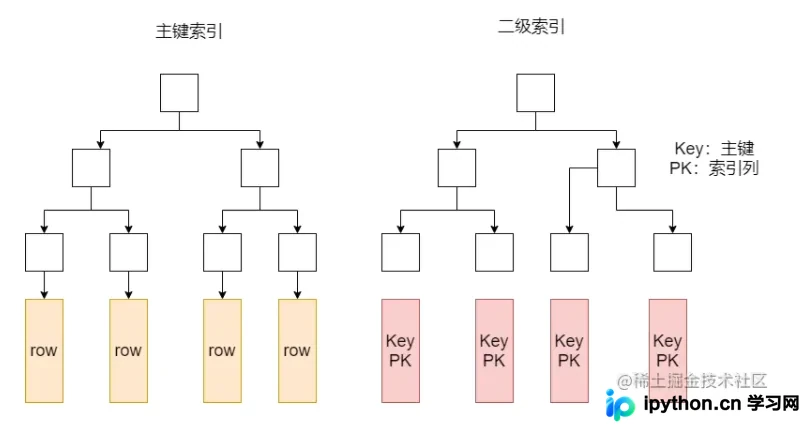
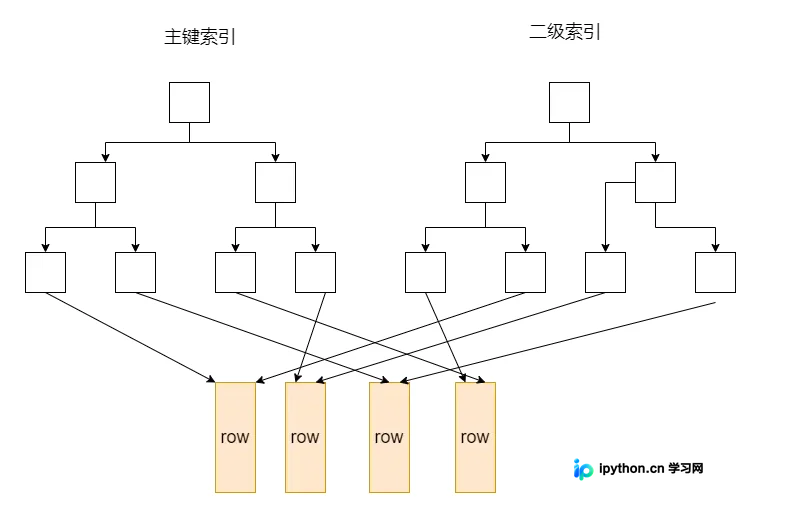
除聚簇索引外,InnoDB还支持二级索引(Secondary Index,通常指非主键的唯一索引或非唯一索引)。二级索引的叶子节点并不存储完整的数据行,而是存储:索引列值 + 主键值。
当通过二级索引查找数据时,流程如下:
- 先在二级索引的B+树中找到对应的叶子节点,获取主键值。
- 拿着这个主键值,去聚簇索引(主键索引)中再次查找,才能获取完整的行数据。
这种先从二级索引查到主键,再回到聚簇索引查数据的过程称为“回表”。多次回表会增加磁盘IO开销。
优化策略:
- 覆盖索引:如果SELECT查询的列只存在于二级索引中(例如 `SELECT id FROM table WHERE email='...'`),则无需回表,直接在二级索引叶子节点即可获取结果。
- 自适应哈希索引:InnoDB会监控索引使用情况,对热点索引自动在内存中构建哈希表,加速精确匹配查询。
MyISAM等非聚簇索引的区别
不同于InnoDB,MyISAM引擎采用非聚簇索引(Non-Clustered Index)。其核心特征如下:
- 数据与索引分离:数据和索引文件分开存储(.MYD 和 .MYI 文件)。
- 行指针存储:无论是主键索引还是二级索引,叶子节点存储的都是数据行的物理地址(文件偏移量/指针),而非主键值或完整数据。
- 性能影响:由于主键索引和二级索引结构相同,且都需要通过指针跳转读取数据,因此随机访问性能相对较差,且不支持事务。
其他索引类型与优缺点总结
1. 哈希索引
哈希索引基于Hash Table实现,仅支持等值查询(=),不支持范围查询和排序。它将索引列计算为Hash值并存储指针。主要应用于Memory引擎。对于Hash冲突,Memory引擎采用链地址法解决。
2. 聚簇索引优缺点评估
- 优点:
- 速度快:数据按主键顺序存储,聚齐相关数据,大幅减少随机IO。
- 利用覆盖索引:部分查询无需回表。
- 缺点:
- 插入代价高:如果插入顺序不是单调递增,会导致频繁的页分裂(Page Split)和数据移动,产生碎片。
- 更新开销大:修改主键会导致所有二级索引都要更新主键引用。
- 二级索引较大:每个二级索引都需要存储主键值,占用额外空间。
以上就是关于MySQL索引底层数据结构详情的详细内容,更多关于MySQL索引底层数据结构资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









