

MySQL 日志表数据迁移 TiDB 实战:方案对比与断点续传脚本设计

针对 MySQL 中随业务增长迅速膨胀的日志数据表,本文对比了历史数据归档、代码层分表以及迁移至 TiDB 分布式数据库三种技术路线。最终选择迁移 TiDB 以解决长期扩展性问题,并详细记录了双写过渡、老数据同步过程中遇到的主键冲突风险,以及通过记录位点和分批处理实现的断点续传同步方案。
背景
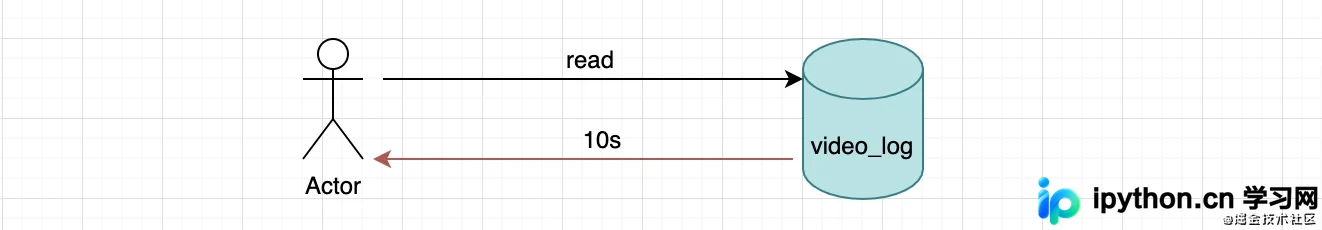
随着业务发展,操作记录表 video_log 的数据量急剧上升。该表仅包含插入操作(Insert),用于支撑用户创建、更新及审核人员审核时的日志留存。注意:在进行任何大规模数据迁移或清理操作前,请务必先对数据库进行完整备份。
数据规模估算如下:
- 日均数据量:约 50 万条日志(按每天 10 万视频操作,平均每个视频关联 5 条日志计算)。
- 月度增量:约 1500 万条。
- 年度存量:约 1.8 亿条。
目前线上已有超 2 亿条记录。虽然日志查询允许一定的延迟,但随着数据积累,单表查询性能持续下降,严重影响排查效率,急需进行架构改造。
方案设计
方案一:老数据归档
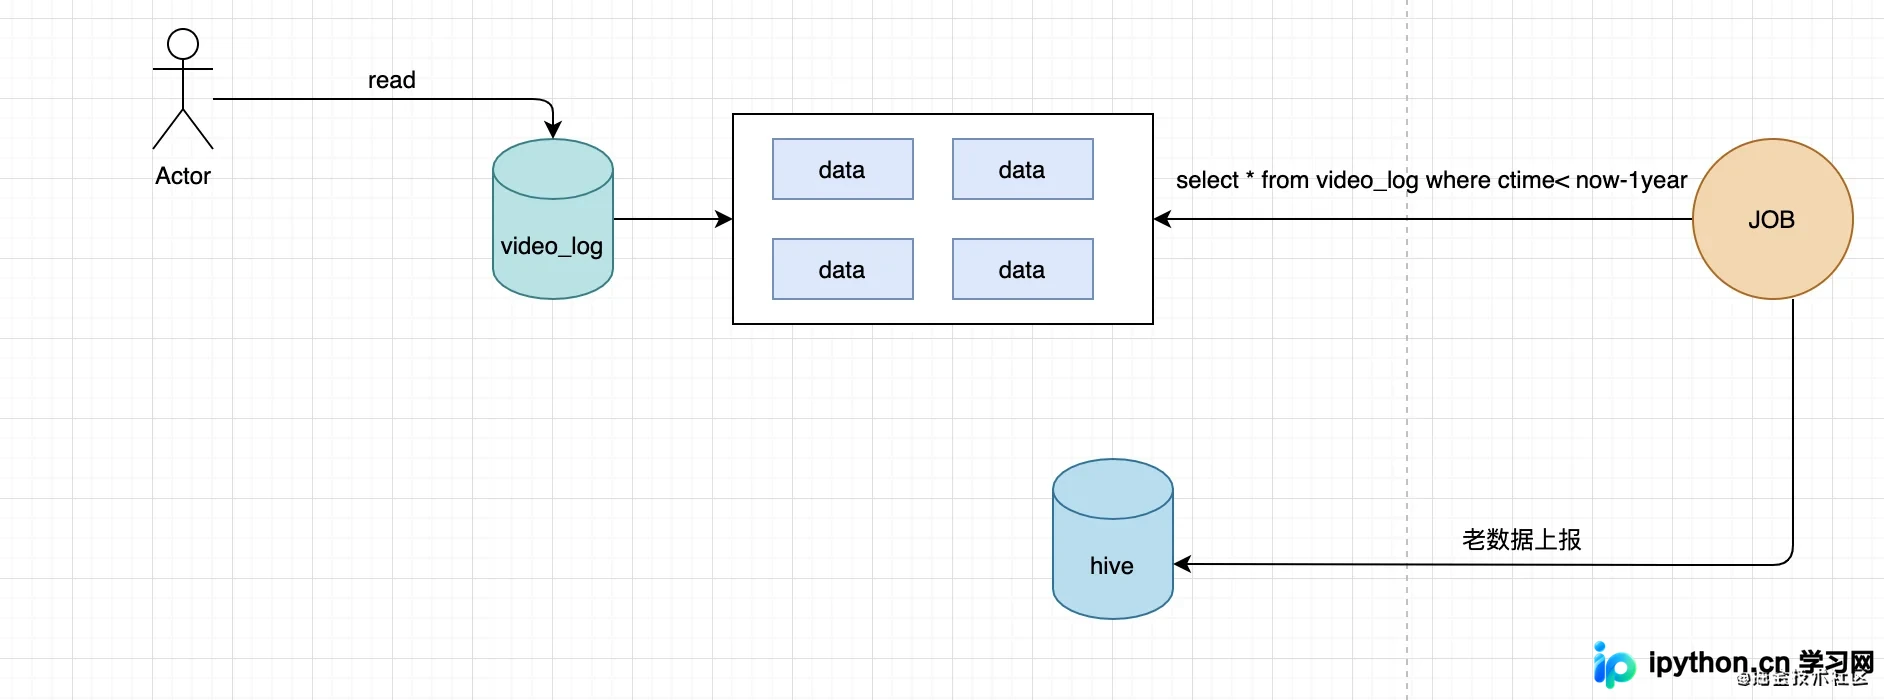
思路是将非核心的历史数据从在线库剥离。优点**是线上核心库压力减轻;**缺点**在于无法满足高实时性查询要求。若需查询一年前的日志,只能走离线数仓(如 Hive),无法满足即时排障需求。
方案二:应用层分表
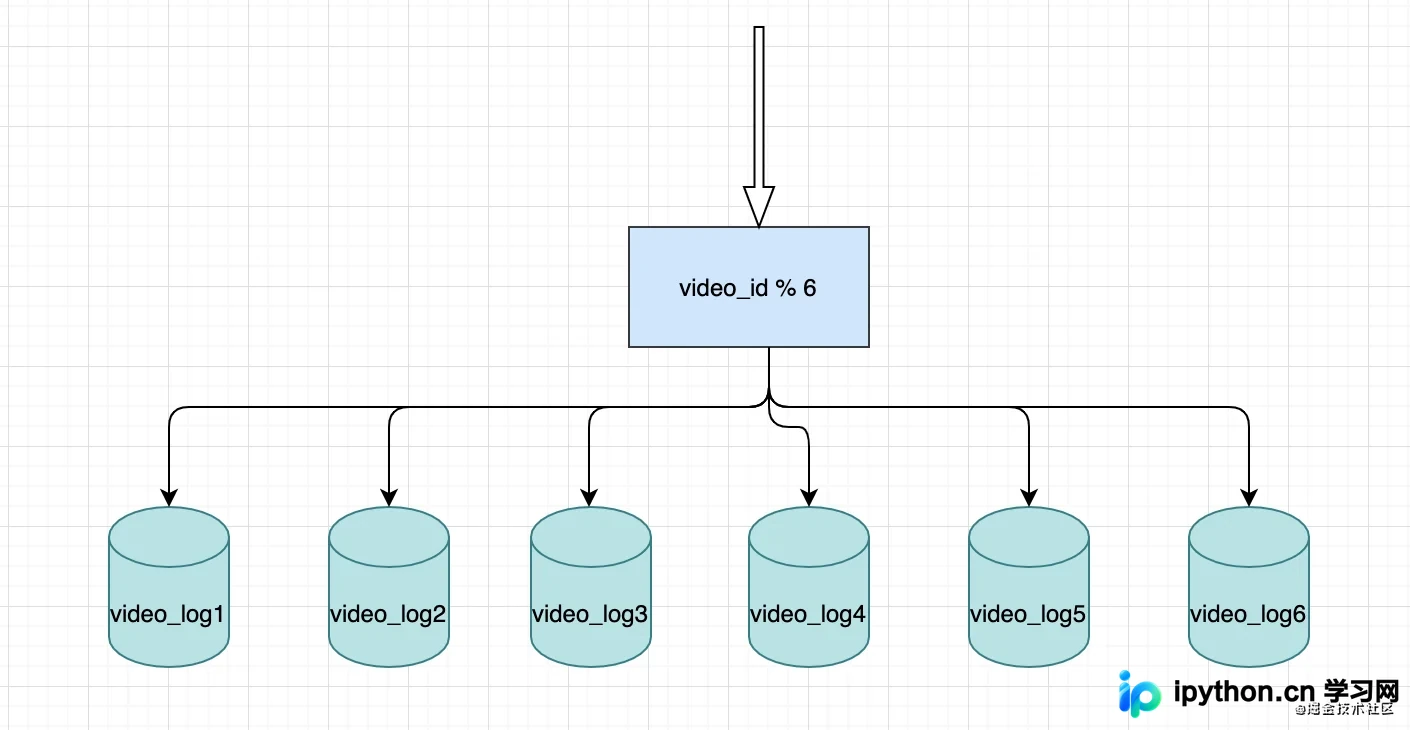
引入 ShardingSphere 等中间件在代码层进行分库分表。**优点**是所有数据支持实时查询;**缺点**是需要改造现有读写代码,且未来如果数据量继续指数级增长,仍需重复造轮子拆表,存在长期的技术债务。
方案三:迁移至 TiDB(最终方案)
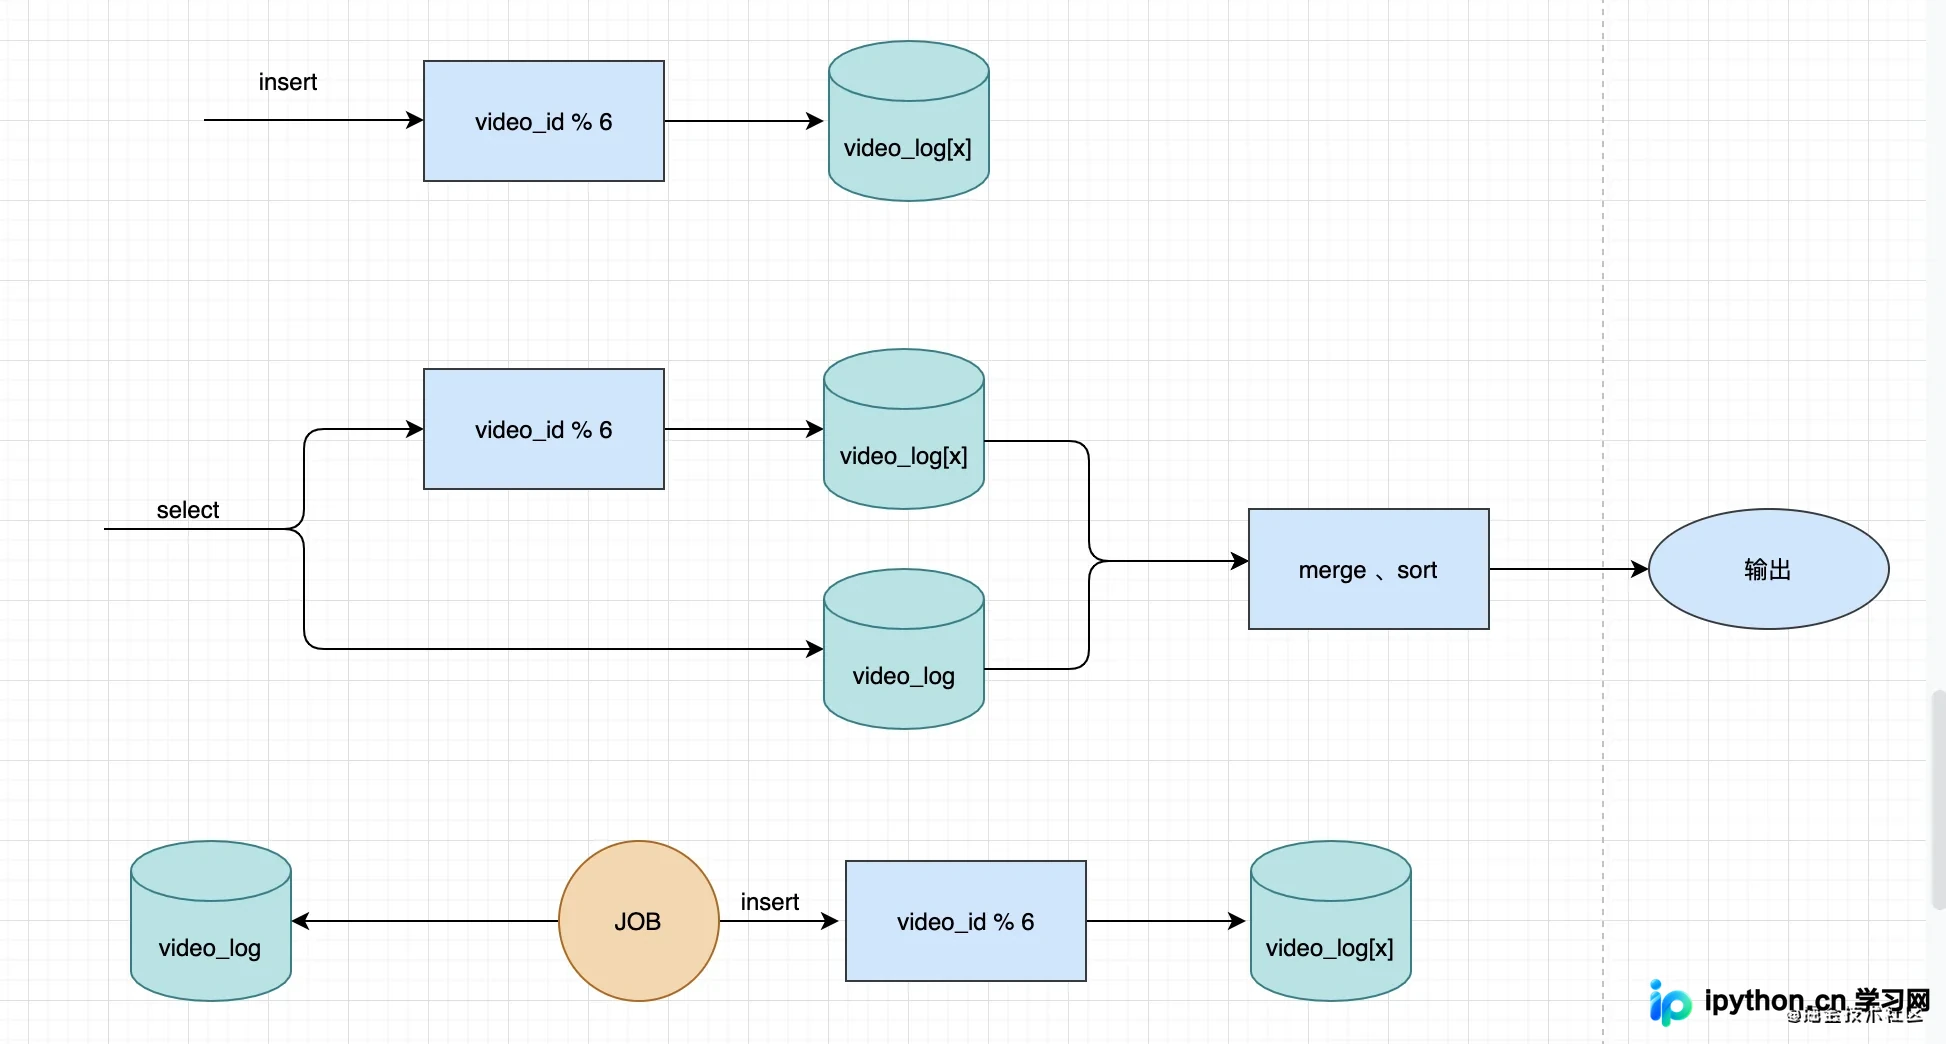
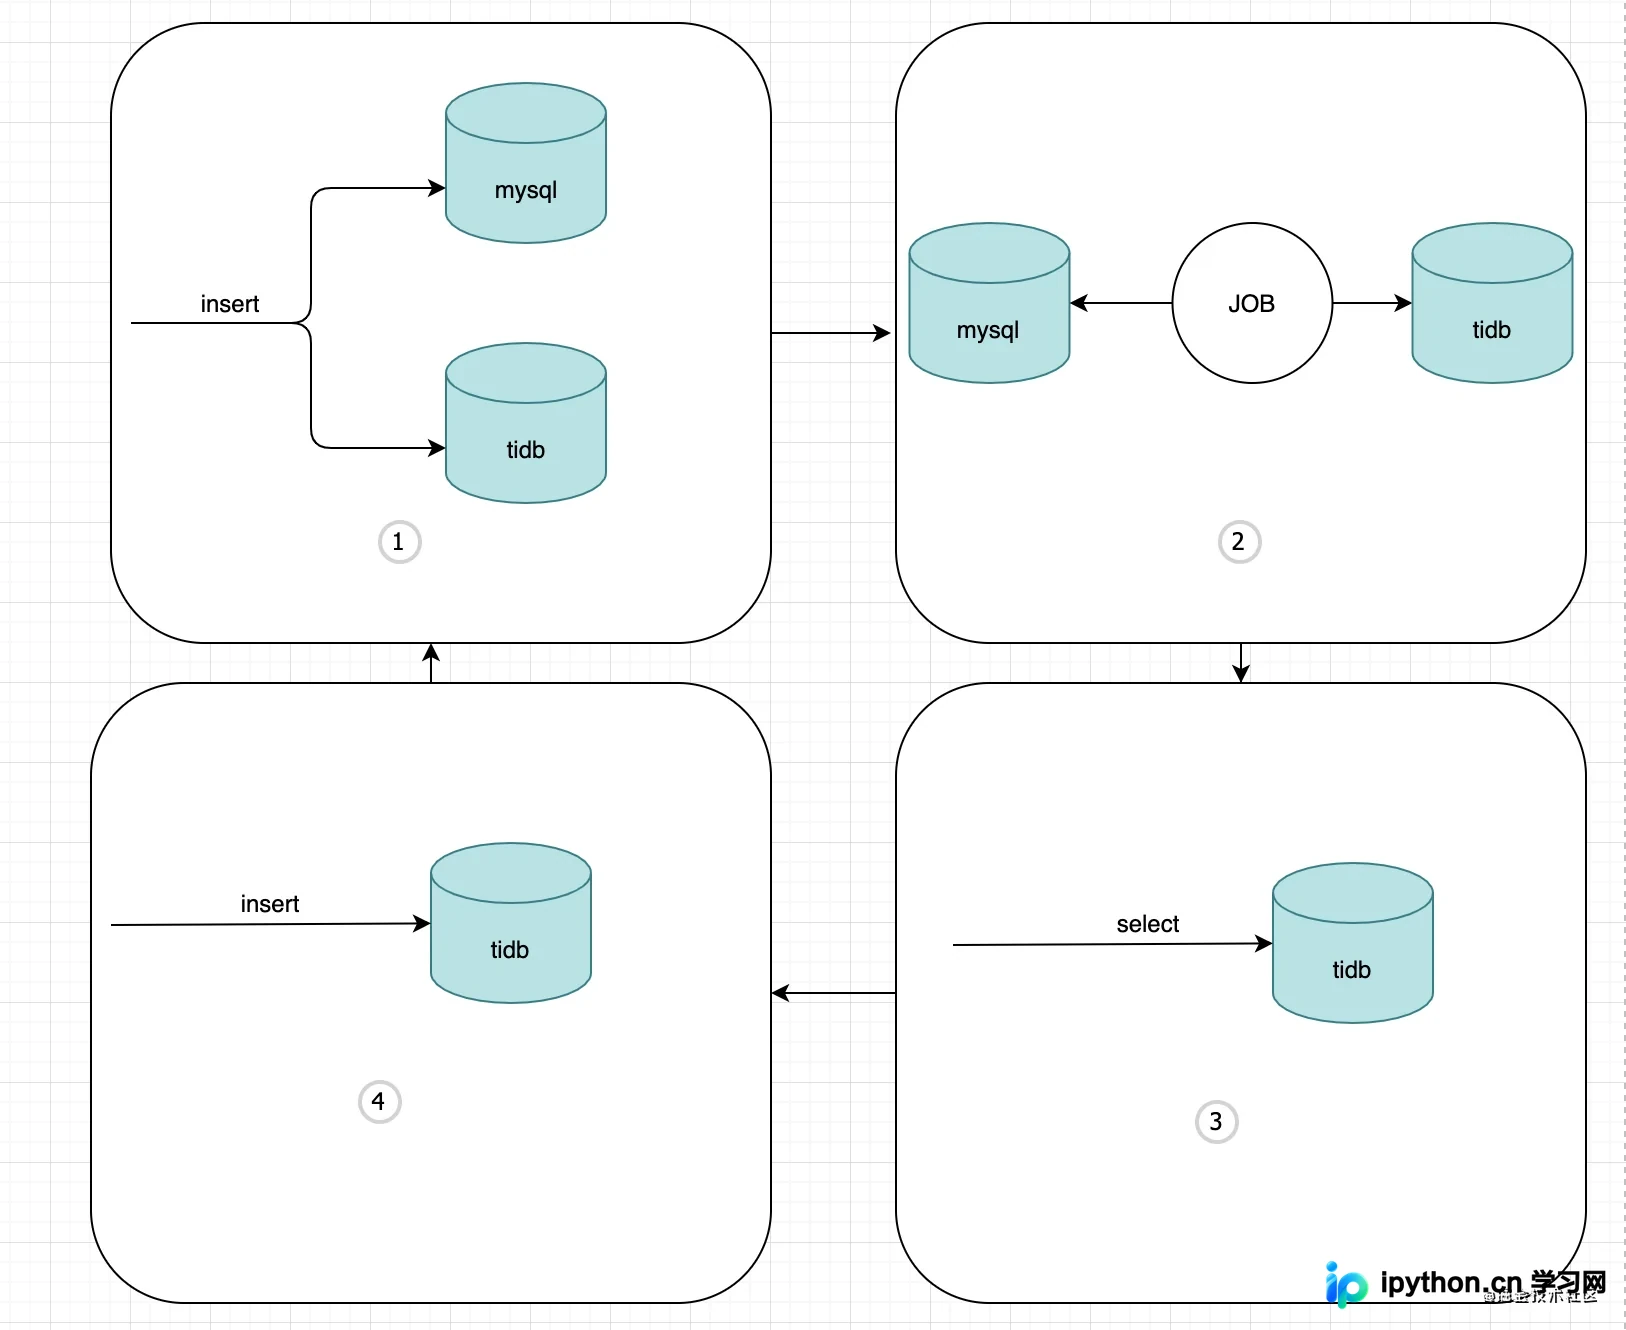
TiDB 作为兼容 MySQL 协议的分布式数据库,自动屏蔽了分片细节,实现了透明扩容。整个迁移过程分为四个阶段:
- 双写阶段:业务同时向 MySQL 和 TiDB 写入,记录起始迁移 ID。
- 历史数据同步:将起始 ID 之前的旧数据同步至 TiDB。
- 切换读流量:验证数据一致性后,应用程序只读 TiDB。 <4>下线双写:关闭向 MySQL 的写入逻辑,完成迁移。
迁移 TiDB 的核心难点与踩坑
痛点分析:如何处理老数据同步中的“断点”与“冲突”?
迁移看似流程清晰,但在具体的 Job 脚本执行层面遇到了两个棘手问题:
- 任务中断恢复:如果同步脚本中途异常中断,重启时需知道上次运行到的位置,否则重新全量跑代价巨大。常规做法是在表里加一个 `synced` 标记字段,但在线大表加字段操作风险极高,极易导致锁表阻塞业务。
- TiDB 主键冲突:考虑到用主键 ID 做去重约束看似完美,但 TiDB 采用分布式算法生成全局唯一 ID,而 MySQL 通常是自增有序 ID。当历史数据导入 TiDB 时,TiDB 分配的新 ID 极可能与后续正常业务产生的 ID 冲突(即便不同步主键,若采用唯一索引校验也会冲突,且这里主要指如果尝试保留原 MySQL PK 会导致 TiDB 报错或因分布式特性导致的随机分配差异)。更关键的是,如果不保存 MySQL 原始 ID,很难精准定位断点位置。
最终的断点续传同步方案
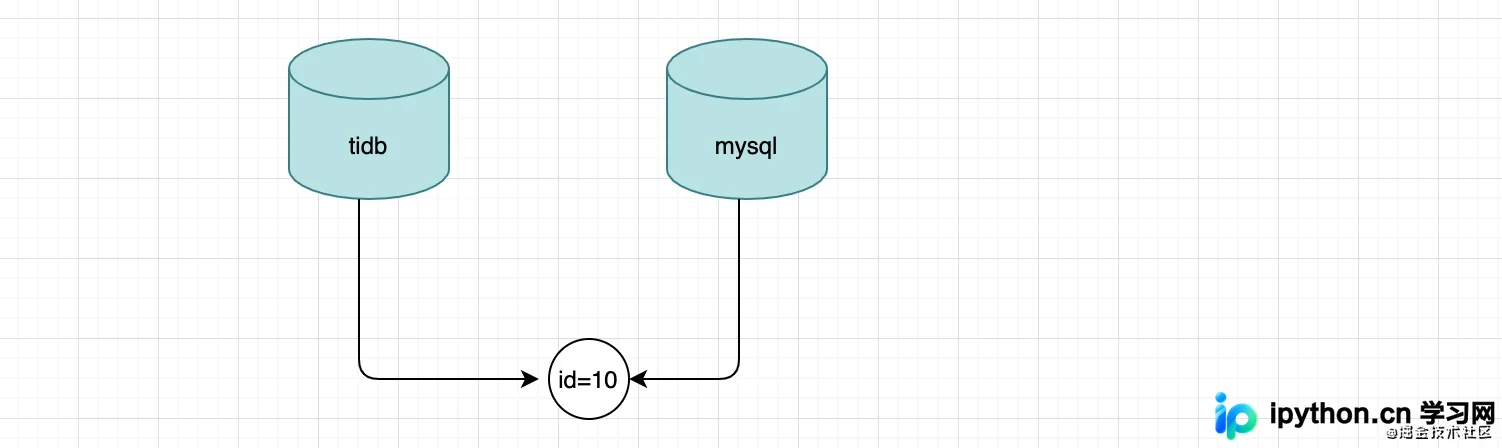
为了兼顾效率、安全性和可维护性,设计了如下同步策略:
- 任务分批并发:将 2 亿数据根据主键 ID 范围切分成 10 个批次,启动 10 个并发 Job 并行处理不同区段,互不干扰,每次批量更新 100 条,提升吞吐量。
- 利用 Redis 记录位点:不使用修改源表结构的方式,而是将每次同步完成的最后一条数据的 ID 存入 Redis 缓存。一旦 Job 崩溃重启,直接从 Redis 读取上次的 `last_sync_id`,实现无缝断点续传。
- 避开主键映射风险:在同步脚本中,除主键外的所有其他业务字段均进行拷贝。由于利用了上面的“分批 + Redis记录ID”机制,即使遇到极少量的重复数据或冲突,也可以通过程序层面的异常捕获与重试机制解决,不再依赖数据库的唯一约束来强制过滤。
通过上述步骤平稳完成了从 MySQL 到 TiDB 的平滑迁移,既解决了历史包袱,又保证了未来的无限扩展能力。
总结
数据表规模的膨胀是互联网业务的常态。对于日志类高频写入场景,提前规划存储架构至关重要。通过合理的分片策略和精心设计的离线同步工具,可以有效规避生产环境的数据迁移风险。以上就是 MySQL 迁移 TiDB 方案的详细内容,更多关于数据分表与迁移优化技术的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









