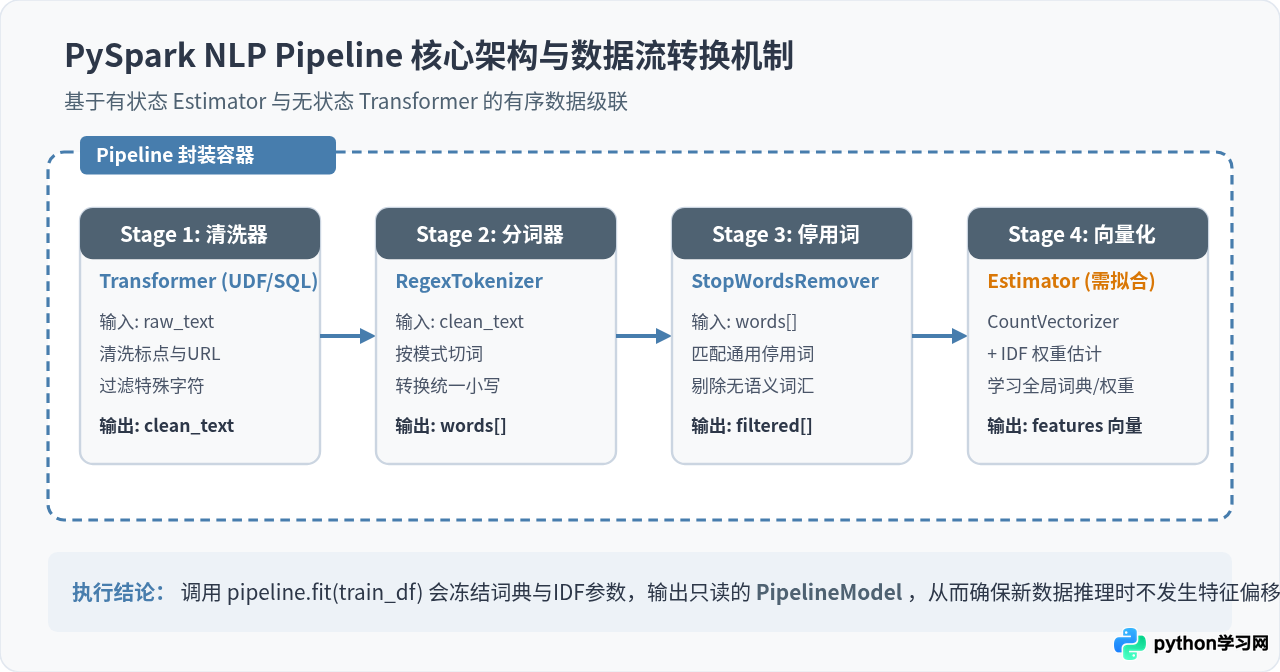
Python实现RSA算法:原理详解与密钥生成完整教程
本文深入解析RSA公钥加密算法原理,涵盖模数生成、公私钥派生及加解密公式。通过Python代码实例,演示如何利用Cryptomath和Rabin-Miller模块生成大素数并创建RSA密钥对,提供完整的代码实现与文件保存方法。
2026-10-15
0
本文深入解析RSA公钥加密算法原理,涵盖模数生成、公私钥派生及加解密公式。通过Python代码实例,演示如何利用Cryptomath和Rabin-Miller模块生成大素数并创建RSA密钥对,提供完整的代码实现与文件保存方法。
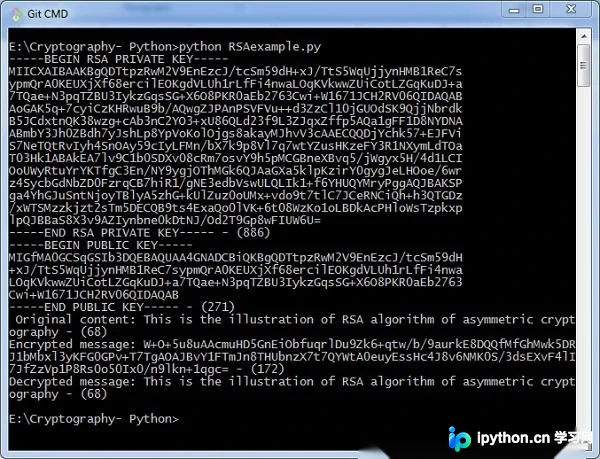
本文详细介绍如何在Python中使用Matplotlib库绘制折线图、柱状图以及柱线混合图。内容涵盖从环境安装到具体代码实现,包括单条与多条折线的绘制、普通与多组柱状图的生成,以及通过调整参数实现柱状图并列显示和柱线混合图表的绘制方法。
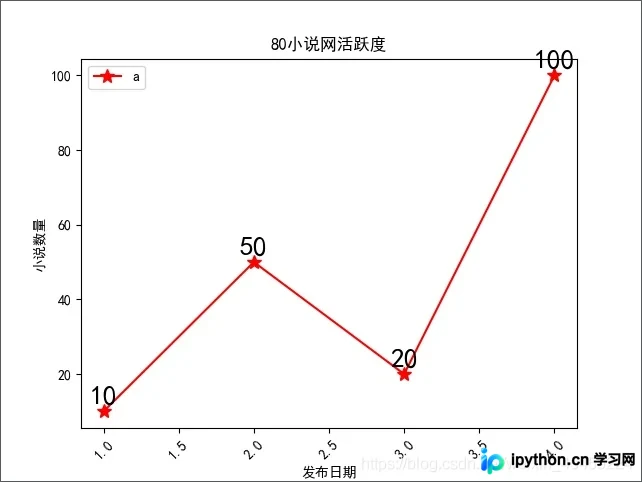
本文介绍如何使用Go语言构建二叉树数据结构,并通过递归遍历计算节点坐标,最终将其转换为SVG矢量图进行可视化展示。文章详细解析了核心代码逻辑,包括节点信息存储、坐标映射及SVG元素生成,并提供多棵树并列排版的扩展方案,帮助开发者直观理解树结构算法并掌握简单的数据可视化技巧。
本文详细解析MySQL索引合并机制,涵盖Intersection(交集)、Union(并集)及Sort-Union三种类型。重点说明在等值匹配、主键范围过滤下的适用条件,对比单索引回表与多索引合并的成本差异,并提供通过联合索引替代索引合并以提升查询性能的优化建议。
本文详细介绍Python中用于远程过程调用(RPC)的xmlrpclib模块。内容涵盖模块定义、ServerProxy构造函数参数说明、常用系统方法、DateTime与Binary对象处理、Fault错误处理以及MultiCall复合调用机制。通过服务端与客户端的完整代码示例,展示如何构建基于XML-RPC的分布式应用,并提及Python 3中该模块更名为xmlrpc.client。
本文详解Python中JSON库的序列化与反序列化操作。通过对比不同编程语言的数据类型,阐述JSON作为跨语言数据交换标准的优势。重点讲解json.dumps()与json.loads()方法,特别是利用ensure_ascii=False参数解决中文编码问题。此外,还提供将列表对象序列化为文件及从文件反序列化的完整代码示例,帮助开发者掌握实际工作中的应用技巧。
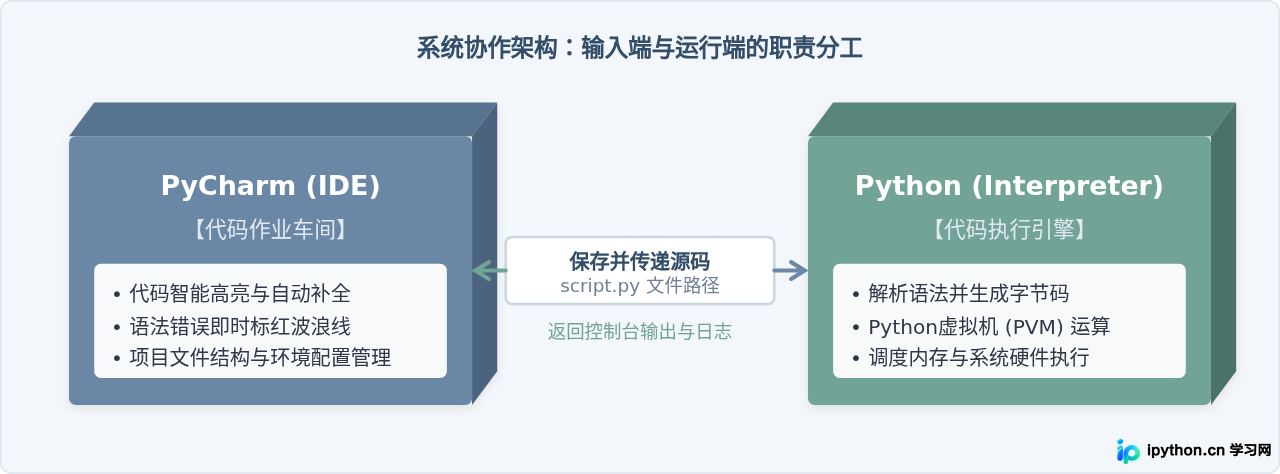
很多初学者分不清Python和PyCharm的区别。本文详细拆解解释器与集成开发环境的核心差异,解答只装Python或只装PyCharm的常见疑惑,并梳理环境配置与协作原理。
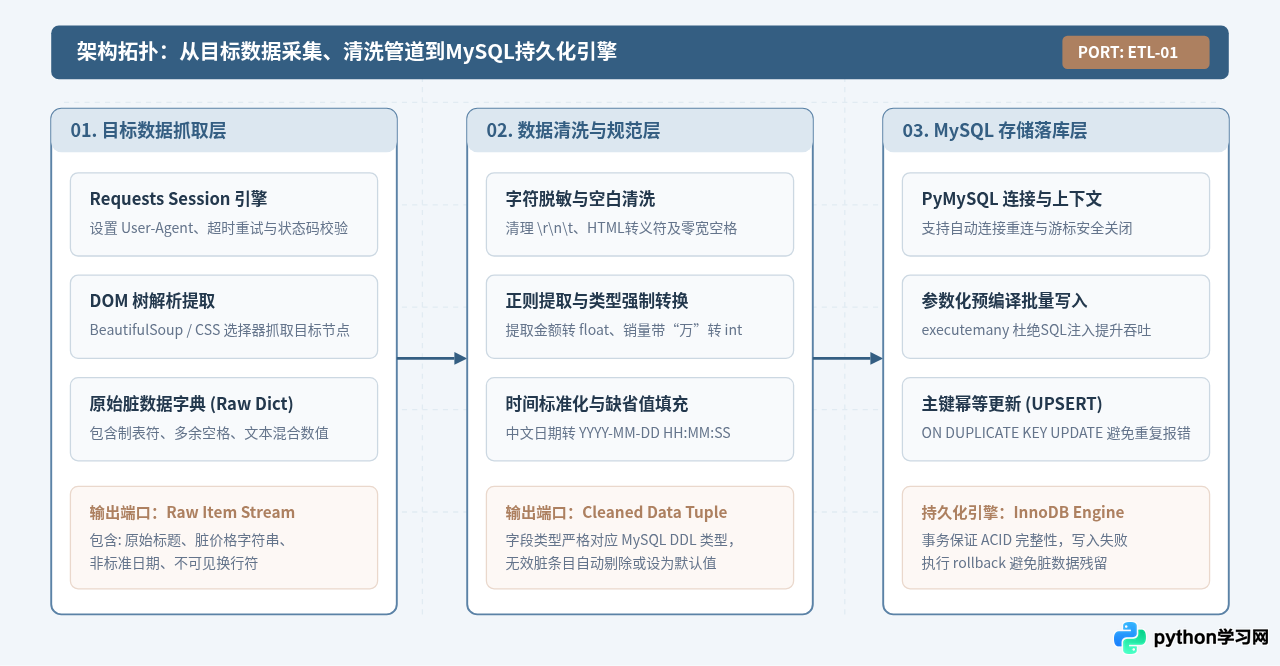
详解使用Python实现网络爬虫数据抓取、正则与类型清洗预处理,并通过PyMySQL参数化批量存入MySQL数据库的完整方案与生产级代码。
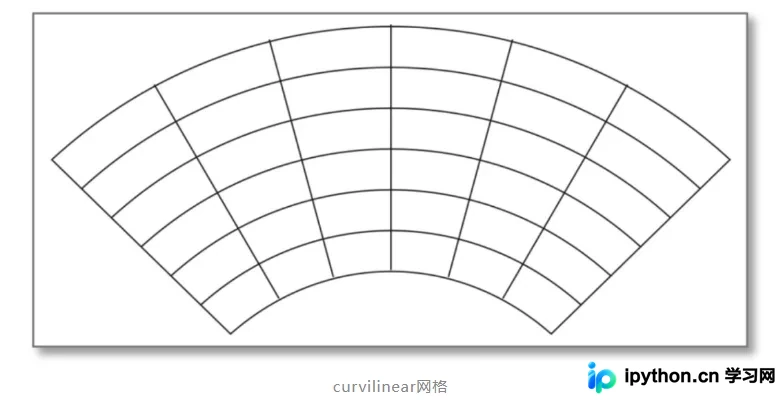
本文介绍如何将WRF模式输出的非等间距风场数据转换为网页可用的JSON格式。通过NCL脚本进行网格插值生成NetCDF文件,再利用Python脚本读取并转换为包含经纬度信息的JSON数据,最终实现网页端的动态风场展示。
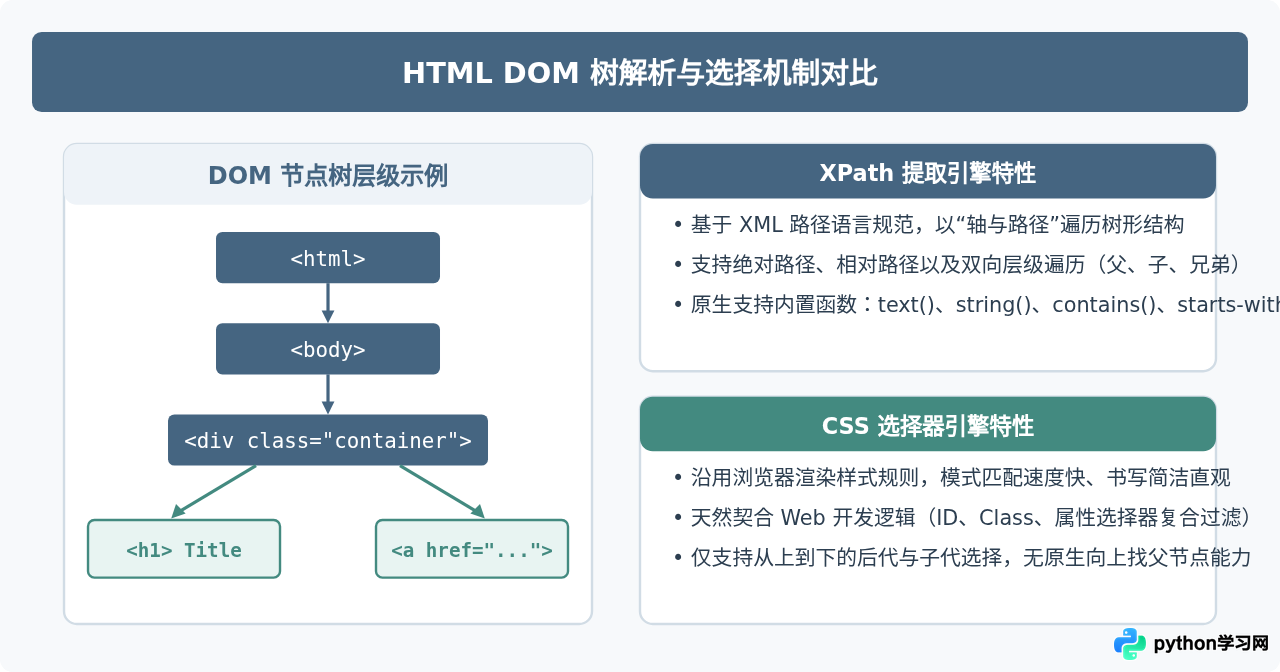
深入解析Python网络爬虫中XPath与CSS选择器的核心语法、节点定位规则、相对路径避坑及性能优化技巧,通过实际代码与对照图解掌握高效数据提取方案。
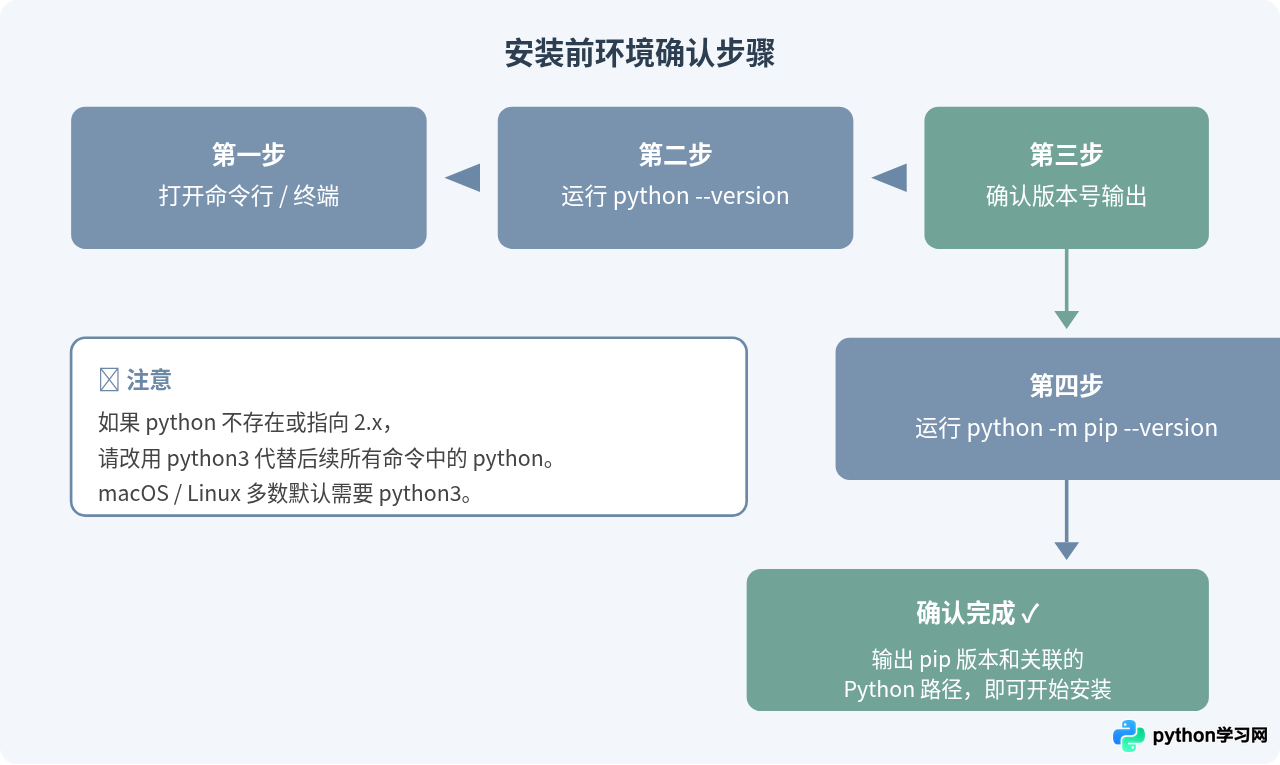
详细讲解如何在命令行中通过 python -m pip 命令安装 Python 第三方库,包括具体步骤、常用选项、虚拟环境配合使用以及常见问题排查。
深入解析如何在PySpark中构建模块化、可复用且支持持久化的自然语言处理(NLP)数据处理Pipeline,涵盖Transformer与Estimator原理、特征工程搭建、模型保存与生产复用实践。