

MySQL 索引合并原理解析:Intersection、Union 及性能优化策略

MySQL在某些复杂查询中会采用索引合并技术,即同时使用多个二级索引来完成一次查询。本文深入解析Intersection(交集)、Union(并集)及Sort-Union三种合并算法的执行流程与成本权衡,明确其触发的必要非充分条件(如等值匹配要求),并指出在实际应用中,构建合适的联合索引往往是比依赖索引合并更高效的选择。
索引合并的基本概念与成本权衡
通常情况下,MySQL在单个查询中只使用一个二级索引。但在特定条件下,优化器可能选择使用多个二级索引,这种机制被称为索引合并(Index Merge)。 optimizer trace(优化器追踪)的输出结果中通常包含对是否使用索引合并的分析片段。
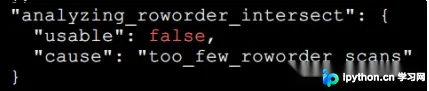
索引合并的核心逻辑在于比较不同执行路径的I/O成本。我们需要区分两种主要的成本来源:
- 二级索引读取(顺序I/O): 从B+树中提取主键ID的过程,通常是顺序扫描,开销相对较小且可预测。
- 回表操作(随机I/O): 根据主键ID从聚簇索引中获取完整记录的过程,属于随机I/O,开销较大。
当仅使用单一索引时,若满足条件的记录数较多,回表的随机I/O次数会显著增加。相反,如果使用多个二级索引分别过滤,虽然读取多个B+树的总成本略高,但最终需要回表的记录集合大幅缩小(取交集或高效并集),从而节省了大量的随机I/O。因此,**读取多个二级索引后取交集的成本低于只读取一个索引再大量回表**时,索引合并不仅在理论上成立,在性能上也具有优势。
Intersection 索引合并(交集)
Intersection索引合并适用于搜索条件之间是 AND 连接的场景。它将来自不同二级索引的结果集求交集,得到最终的主键列表后进行回表。
第1步:Intersection 适用的基本条件
要实现高效的Intersection合并,必须满足以下两个必要条件(非充分条件,需看优化器代价估算):
- 等值匹配要求: 涉及的二级索引列必须是等值匹配(=)。对于联合索引,参与匹配的列也必须是连续的等值条件。如果涉及范围查询(如
>,<,BETWEEN),则无法直接进行Intersection合并。
示例:
SELECT * FROM order_exp WHERE order_no = 'a' AND expire_time = 'b';(可行)
SELECT * FROM order_exp WHERE order_no > 'a' AND insert_time = 'a';(不可行,因order_no为范围匹配) - 主键列允许范围匹配: 如果搜索条件中包含主键(PK)的范围查询,可以与其它二级索引的等值条件合并。因为主键本身有序,不影响排序逻辑。
示例:
SELECT * FROM order_exp WHERE id > 100 AND order_no = 'a';
第2步:Intersection 的执行流程
假设查询使用了 idx_order_no 和 idx_expire_time 进行Intersection合并:
- 独立提取: 分别从两个二级索引中筛选出满足各自条件的记录,这些记录包含索引值和对应的主键ID。
- 基于Rowid Ordered Retrieval (ROR) 求交集: MySQL利用二级索引中“相同索引值的记录按主键排序”的特性。当所有参与的索引列都是等值匹配时,提取出的主键ID序列本身就是有序的。优化器可以使用类似归并排序中的双指针法,线性时间复杂度
O(n)地求出两个有序主键序列的交集。 - 回表查询: 使用求得的交集主键ID列表,通过聚簇索引获取完整的用户记录。
第3步:主键范围匹配的优化处理
在情况二中提到的主键范围匹配(如 id > 100),MySQL并不会真的去聚簇索引中提取数据再求交。而是直接从其他二级索引(如 idx_order_no)中提取主键ID后,直接在内存中对这些主键ID应用 id > 100 的过滤条件。这样既利用了其他索引的快速过滤,又避免了额外的随机I/O。
Union 索引合并(并集)
Union索引合并适用于搜索条件之间是 OR 连接的场景。它将从不同索引获取的主键集合合并(去重)后,进行统一回表。
第1步:Union 适用的基本条件
除了需满足类似Intersection的等值匹配和主键范围可选条件外,Union还有特殊情形:
- 复合条件嵌套: 可以将一部分条件使用Intersection合并得到的主键集,与其他条件使用Union合并。
示例:
SELECT * FROM order_exp WHERE insert_time = 'a' AND order_status = 'b' AND expire_time = 'c' OR (order_no = 'a' AND expire_time = 'b');
优化器先通过Intersection合并左侧三个等值条件得到一个主键集A,再通过Intersection合并右侧两个等值条件得到主键集B,最后对A和B进行Union(并集)。
第2步:Sort-Union 索引合并
当 OR 条件中的子句涉及范围查询(如 order_no < 'a'),导致从二级索引提取的主键ID无序时,标准的Union合并无法直接应用(因为无法高效去重)。此时MySQL会使用Sort-Union合并:
- 提取并排序: 分别按各条件从二级索引提取主键ID,并分别对这些主键ID进行内部排序。
- 归并去重: 对所有排好序的主键ID序列执行归并操作,实现并集与去重。
- 回表: 根据最终的有序主键列表进行ROR回表。
注:Sort-Union相比标准Union多了一步排序开销,因此在条件允许纯等值匹配时,优先生成标准Union计划。
性能优化建议:联合索引 vs 索引合并
尽管索引合并能优化某些查询,但其本质是“妥协”方案。在大多数情况下,构建正确的联合索引是更优解。
场景对比:
查询:SELECT * FROM order_exp WHERE order_no='a' AND expire_time='z';
- 现状(索引合并): 访问
idx_order_no和idx_expire_time两棵B+树,内存中进行交集计算,然后回表。 - 优化(联合索引): 创建联合索引
(order_no, expire_time)。查询可直接在单棵B+树上定位到目标节点,一次回表即可命中结果。
操作步骤:
ALTER TABLE order_exp
drop index idx_order_no,
drop index idx_expire_time,
add index idx_order_no_expire_time(order_no, expire_time);
建立联合索引后,不仅消除了多索引读取和网络/内存拷贝开销,还避免了复杂的索引合并逻辑。只有当业务场景导致索引数量爆炸,无法全部覆盖,或特定组合出现频率极低且回表开销巨大时,才应依赖MySQL自动生成的索引合并计划。建议在排查慢查询时,若发现Execution Plan中出现 type: index_merge,应优先检查是否存在缺失的联合索引来替代当前的多索引合并。
以上就是MySQL索引合并机制的详细解析,更多关于MySQL执行计划优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









