

Python正则表达式实战:爬取京东商品数据详解
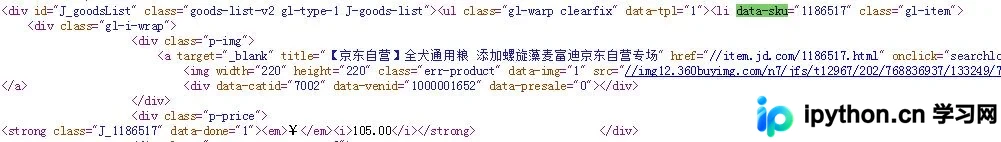
本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
2026-10-13
6

本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
本文详解Python爬虫应对常见反爬策略的三种核心方案:通过维护代理IP池解决IP限制与验证码问题;利用time.sleep控制访问频率以规避限流;以及通过设置User-Agent和Referer头伪装浏览器身份。内容涵盖Requests与Urllib库的具体代码实现,帮助开发者提升爬虫稳定性。
本文详细讲解Python中requests库的多种实用技巧。内容涵盖库的安装、GET与POST请求的参数及头部设置、代理IP的配置方法,以及通过获取Cookie和使用Session对象实现自动登录和状态保持。适合希望提升爬虫效率与稳定性的开发者参考。
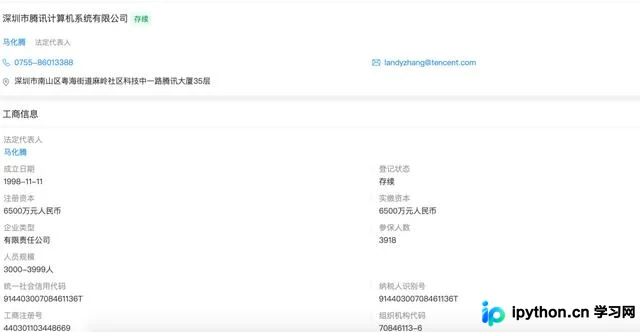
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
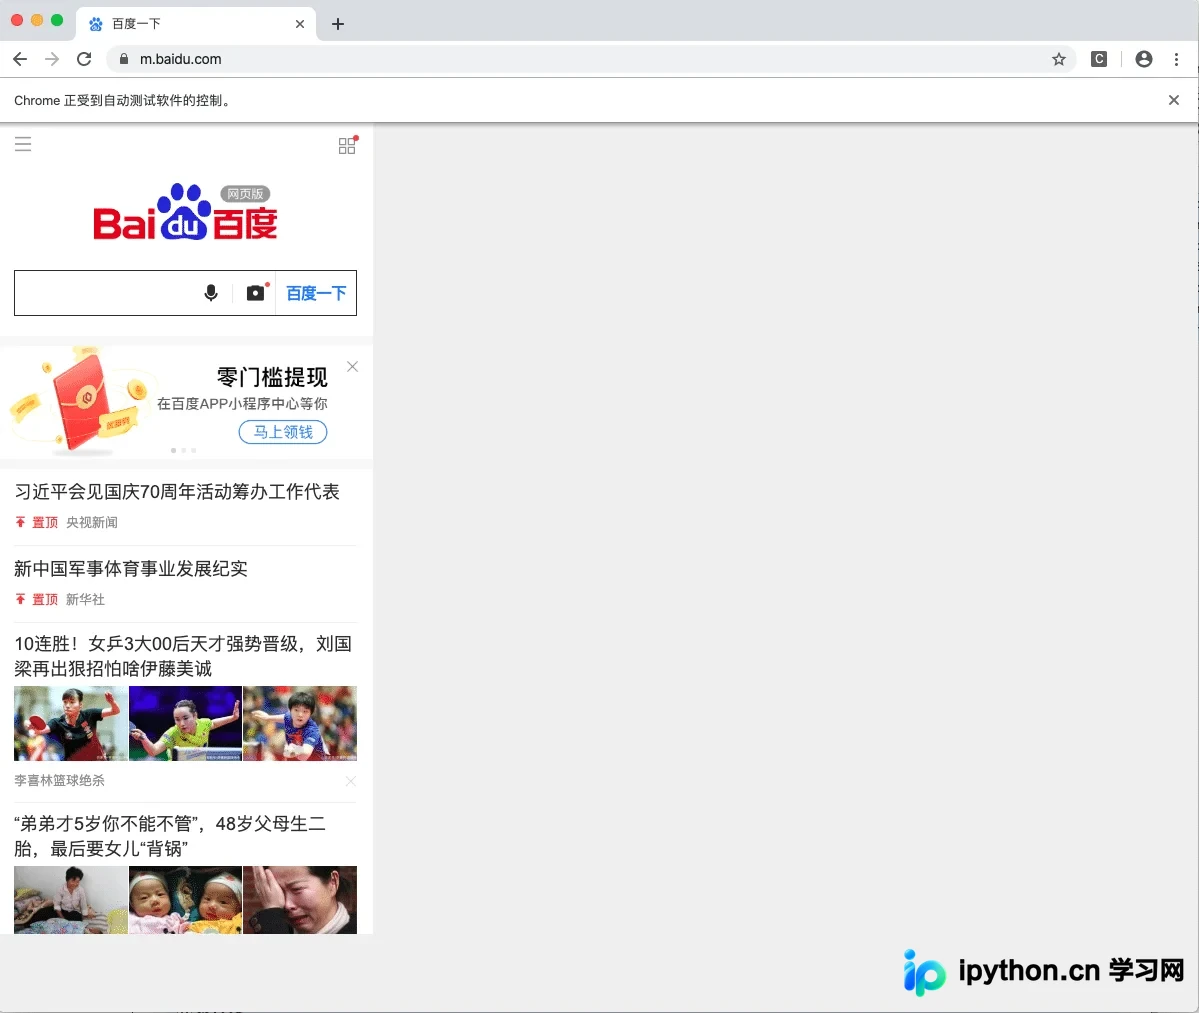
本文解析如何利用Selenium控制Chrome浏览器模拟移动端环境。通过ChromeOptions配置mobileEmulation,可调用预设设备名称(如iPhone X)或自定义设备指标(宽度、高度、像素比及User-Agent)。该方法适用于H5页面兼容性测试及降低移动端反爬策略影响,提供完整代码示例与参数说明。
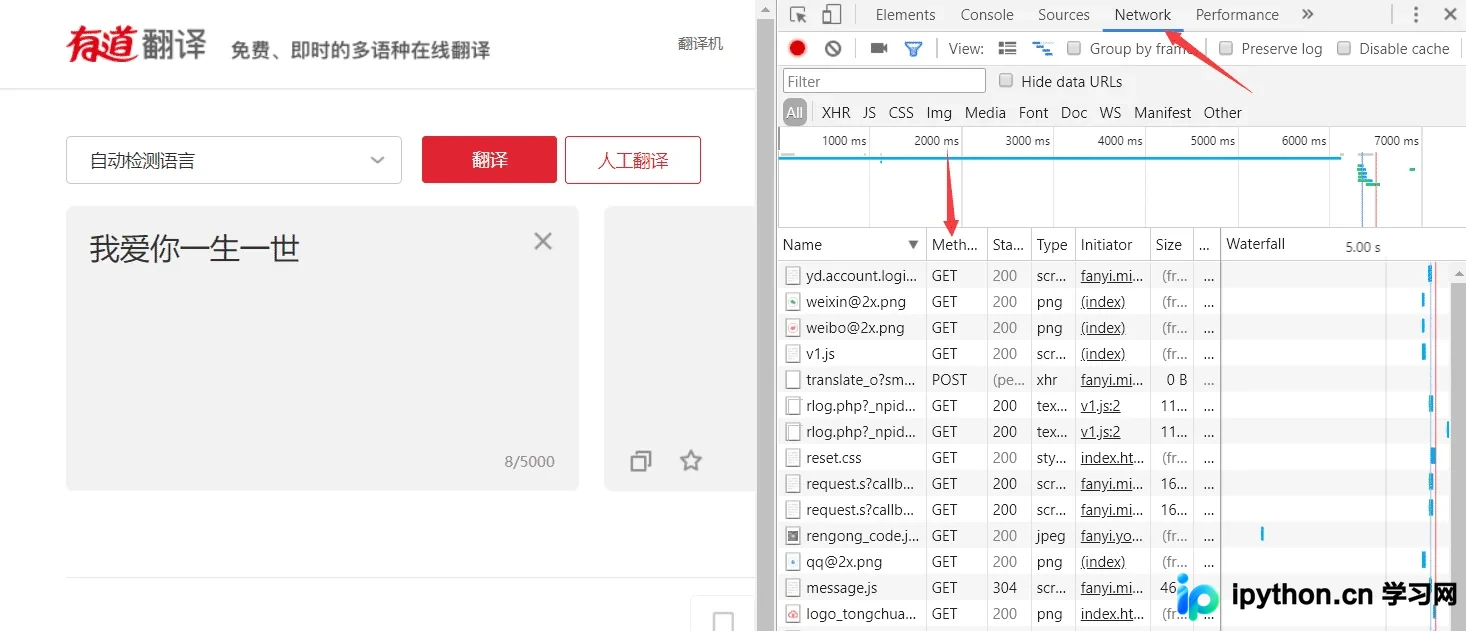
本文详解如何使用Python的urllib库模拟有道在线翻译的POST请求。通过浏览器开发者工具分析网络请求,识别GET与POST差异,重点讲解urlopen方法中data参数的应用、字典数据的构造以及UTF-8编码转换原理,帮助开发者掌握基础网页抓取与接口模拟技巧。
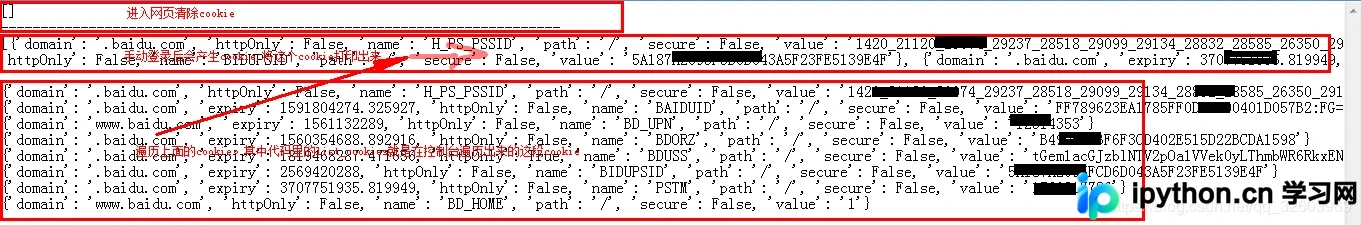
本文介绍如何利用Python3与Selenium库实现Cookie免密登录。通过清除现有Cookie、手动或程序化获取目标网站的Cookie信息,再将获取的Cookie添加至浏览器会话中,从而跳过密码登录步骤。文章提供了具体的代码示例,包括登录获取Cookie和后续免密登录两个场景,适用于爬虫和自动化测试场景。
本文详细介绍Python Selenium中ChromeOptions类的核心配置方法。涵盖禁止图片加载、添加代理IP、修改User-Agent、设置编码及禁用JavaScript等常用技巧,并提供关闭密码提示框、添加扩展插件等高级配置代码示例,帮助开发者提升爬虫稳定性与执行效率。
本文介绍Selenium处理网页内容需滚动加载的两种方法:调整浏览器窗口高度延时加载,以及模拟下拉滚动操作。针对懒加载特性,强调page_source仅包含已加载内容,需通过模拟滚动触发加载。提示网速慢时需增加等待时间,确保获取完整HTML后再执行翻页或元素定位操作。
本文介绍使用 Python 的 Selenium 库抓取页面点击后弹出的窗口信息。通过 Firefox 浏览器配合 GeckoDriver,利用 XPath 定位元素并切换窗口句柄获取数据。针对自动化测试中点击按钮弹窗不显示的问题,提供使用模拟键盘 Enter 键替代 click() 的解决方案,并附带完整代码示例。
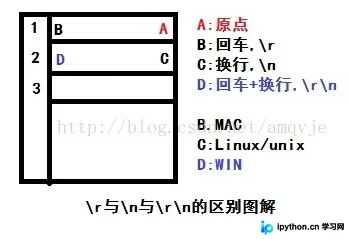
本文详细解析了Python中\r、\n及\r\n的历史渊源与系统差异,涵盖Unix、MAC和Windows的不同标准。同时介绍了如何处理爬虫获取的Unicode编码文件,通过指定encoding='unicode_escape'等参数正确读取和解码内容,确保数据准确输出。
本文详解Python中urllib模块的自定义Opener构建原理。通过HTTPHandler、ProxyHandler及HTTPCookieProcessor处理器,实现代理IP切换与Cookie持久化。涵盖Debug调试、免费与私密代理选择策略,以及基于CookieJar的模拟登录流程,帮助开发者突破基础urlopen的功能限制。