

Python爬虫乱码处理实战:编码检测与转换技巧
本文探讨Python爬虫中常见的乱码问题,介绍如何利用chardet库自动检测网页编码,并通过unicode解码与encode编码将不同字符集(如Big5、GBK、EUC-JP)统一转换为UTF-8,确保数据顺利存入MySQL数据库。
2026-10-13
6

本文探讨Python爬虫中常见的乱码问题,介绍如何利用chardet库自动检测网页编码,并通过unicode解码与encode编码将不同字符集(如Big5、GBK、EUC-JP)统一转换为UTF-8,确保数据顺利存入MySQL数据库。
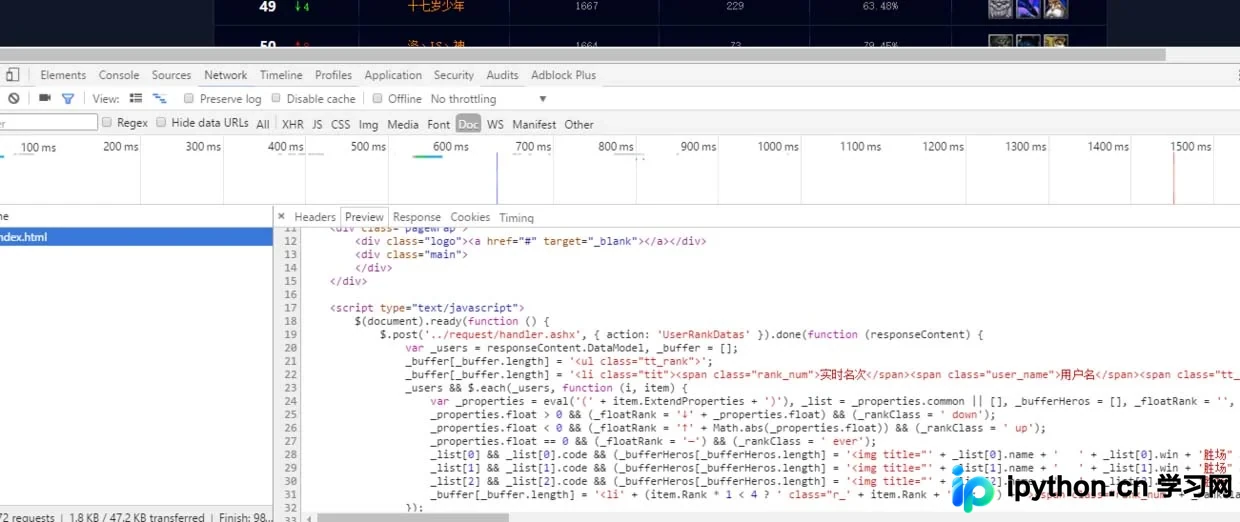
本文详细介绍如何利用Python抓取DOTA2游戏排行榜数据。通过浏览器开发者工具分析网络请求,定位异步POST接口及JSON数据结构,编写脚本模拟浏览器行为获取数据,并最终将结果保存至Excel文件中。适合希望学习网络爬虫基础及数据处理流程的开发者参考。
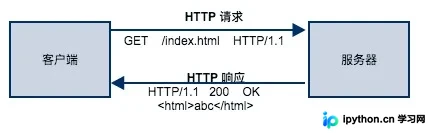
本文详解HTTP协议在Python爬虫中的核心作用,剖析HTTP请求(请求行、首部、体)与响应(状态码、首部、体)的标准格式,并通过Socket模块模拟真实通信过程,帮助开发者掌握爬虫底层原理。
本文详细介绍Python中Beautiful Soup模块修改HTML/XML文档的方法。涵盖修改标签名称与属性、添加新标签、修改及删除字符串内容、移除节点以及使用wrap/unwrap等方法包裹或解包标签。通过具体代码示例,帮助开发者掌握动态修改网页内容的技巧。
本文详解Python爬虫中常见的403禁止访问错误原因,介绍通过urllib2模块添加User-Agent、Host和Referer等请求头来伪装浏览器访问的方法,并提供封装好的随机User-Agent选择函数代码,帮助开发者绕过基础反爬限制。
本文详解Python3中提取字符串内数字的两种常用方法。首先解析利用re.sub配合正则表达式\D替换非数字字符的实现原理及代码示例;其次探讨通过split()按空格分隔并取首元素的方式处理特定格式数据。对比两者适用场景与局限性,为处理爬虫数据或格式化文本提供清晰的技术参考。
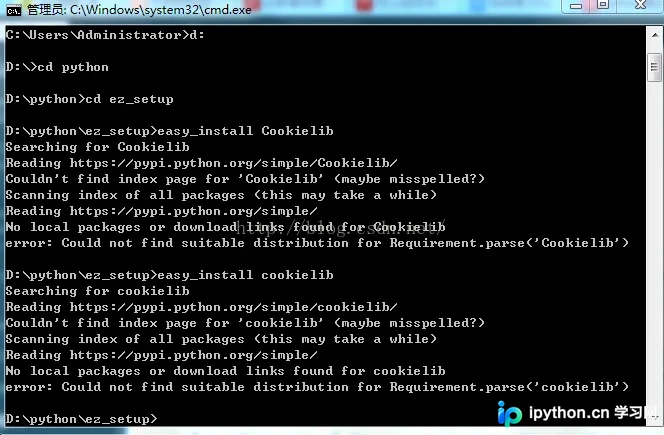
本文详解Python爬虫中利用cookielib模块实现模拟登录的方法。通过构建CookieJar及子类MozillaCookieJar,结合urllib2的build_opener,可自动捕获并保存网站Cookie。文章涵盖从获取Cookie、保存到文件(cookie.txt)再到读取Cookie访问受限页面的完整流程,帮助开发者突破游客限制,高效抓取目标网页数据。
本文详解如何在Python Selenium中利用execute_script方法绕过网站JS行为监控。通过注入JavaScript代码,实现模拟鼠标直接点击、拦截弹窗、创建派发事件、悬停后点击、滚动至元素及等待可点击状态等多种复杂交互场景,帮助开发者解决元素遮挡、未加载或反爬限制问题。
本文详解如何利用Python构造__jsluid_h和__jsl_clearance字段以应对网站反爬机制。通过分析JS混淆脚本,复现__jsl_clearance的生成逻辑,并结合Js2Py获取Cookie,实现自动化的请求头构造,有效解决因Cookie频繁过期导致的爬虫中断问题。

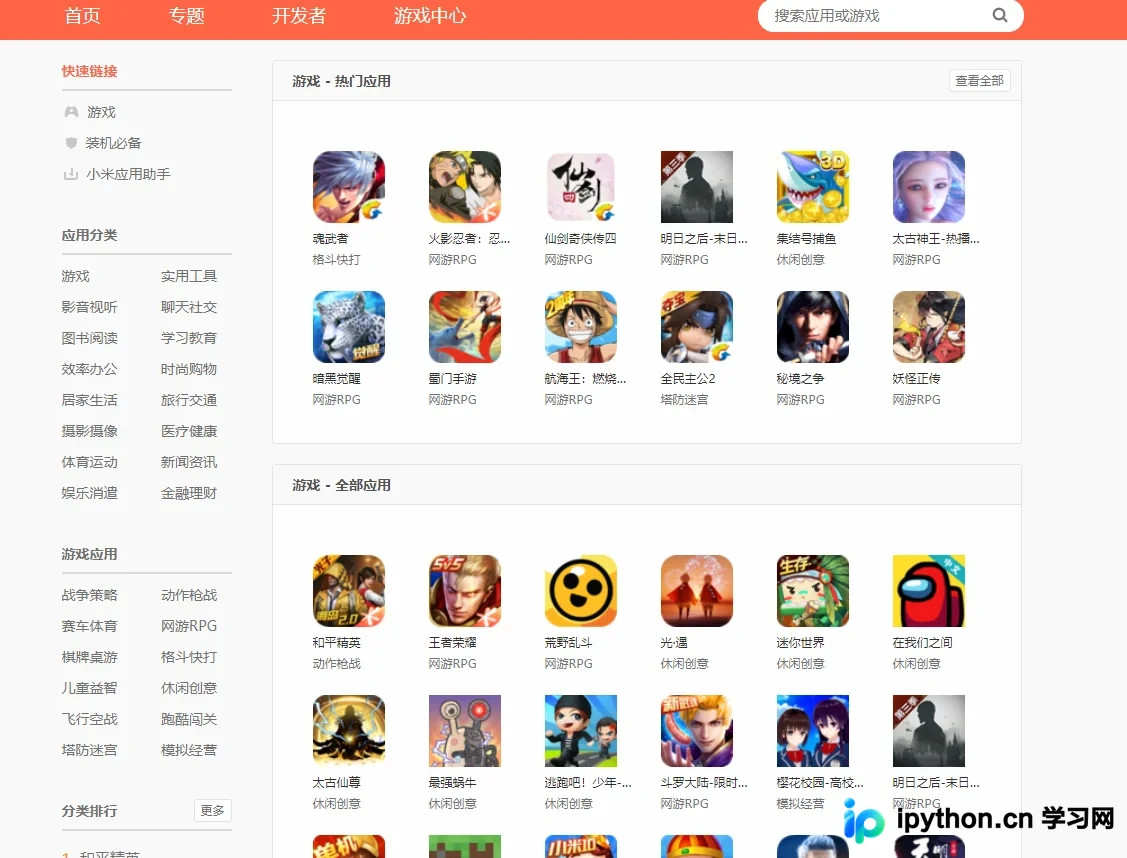
本文详解如何利用Python多线程技术高效抓取小米应用商店数据。通过分析动态加载接口,使用requests、threading和queue库构建爬虫,实现聊天社交类应用名称与链接的快速批量获取,并展示控制台输出结果及执行时间统计。
本文详细介绍Python爬虫应对Cookie反爬的两种核心策略。针对静态且无有效期的Cookie,建议通过抓包工具手动提取并封装至Headers;针对动态变化的Cookie,推荐使用requests.Session对象实现自动存储与发送。文章结合雪球网数据抓取案例,演示了Session在保持会话状态中的具体应用,帮助开发者高效解决身份验证问题。
本文详解Python爬取动态网页的两种主流方案:Dryscrape与Selenium。重点讲解Selenium在Ubuntu下的安装步骤,包括geckodriver的下载与路径配置,以及解决Firefox版本兼容性问题。通过代码示例演示如何调用浏览器引擎获取JS执行后的页面源码,并解决常见报错,如模块调用错误及元素定位方法。