

Python怎么打开并读取txt文件内容
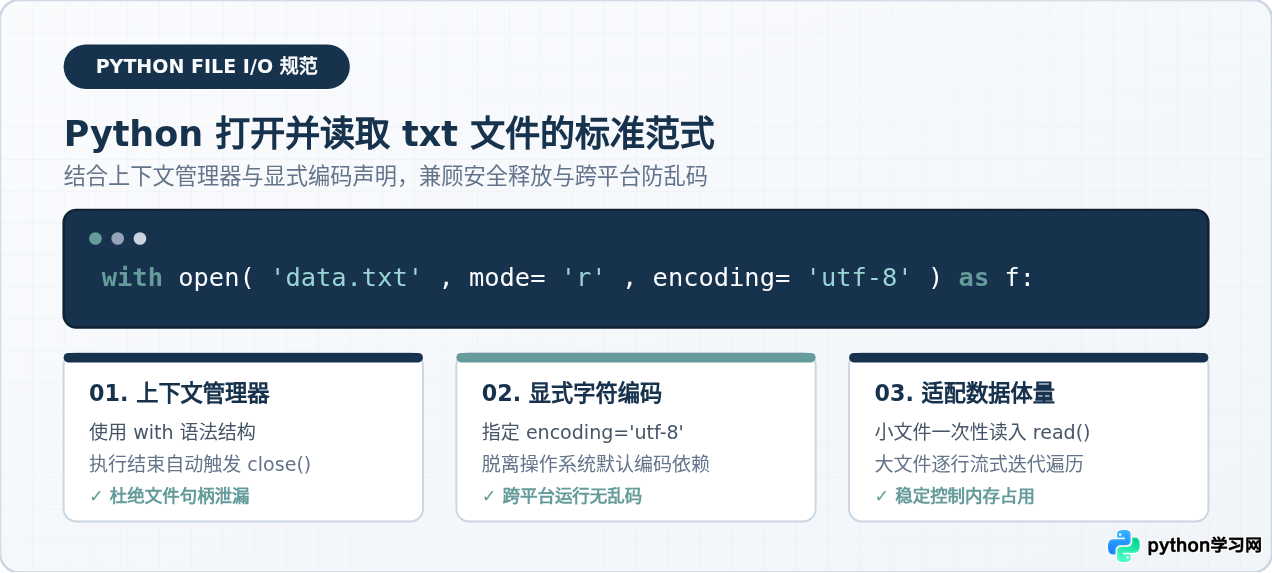
详细讲解在Python中如何正确打开并读取txt文本文件内容,涵盖with open标准语法、read/readline/readlines/逐行迭代四种读取方式对比、路径与编码异常排查及生产选型建议。
2026-10-31
27

详细讲解在Python中如何正确打开并读取txt文本文件内容,涵盖with open标准语法、read/readline/readlines/逐行迭代四种读取方式对比、路径与编码异常排查及生产选型建议。
本文详细介绍Python中使用with语句安全读写文本文件与二进制文件的方法,涵盖open()核心参数、编码设置、逐行读取、二进制数据处理及异常处理机制,并附带完整可运行代码示例。
本文对比分析Discuz和EcShop两款开源系统中PHP字符串截取函数的实现差异。针对UTF-8编码下中英文混杂场景,指出原版函数在长度判定上的缺陷,并提供一种将中文按双字节计算的通用优化方案,确保截断处不会出现乱码。
本文介绍Go语言中如何安全地按指定字节数截取UTF-8编码字符串,避免产生乱码。核心方法是先将字符串转为[]byte切片,获取目标长度前缀后,从末尾向前遍历检查字节是否为多字节字符的尾随字节或头字节。若发现不完整的字符开头,则向前收缩截取范围至最近的可读边界,确保返回的字符串是合法的UTF-8序列。
本文详解如何在 C++ 中使用 Windows API 函数 WideCharToMultiByte 将宽字符转换为 UTF-8 编码,并结合 BOM 头正确写入文本文件。文章提供完整代码示例,涵盖参数配置、缓冲区大小计算及错误处理关键点,确保生成的文件符合标准 UTF-8 规范且能被记事本等编辑器正确识别。
本文介绍如何在Python3中实现自定义编码类型的URL编码与解码。通过封装Urlchuli类,支持指定GBK或UTF-8等编码格式,解决中文URL处理中的乱码问题。提供完整的编码与解码调用示例,适用于需要灵活处理不同字符集编码的Web开发场景。