

Python怎么打开并读取txt文件内容
详细讲解在Python中如何正确打开并读取txt文本文件内容,涵盖with open标准语法、read/readline/readlines/逐行迭代四种读取方式对比、路径与编码异常排查及生产选型建议。
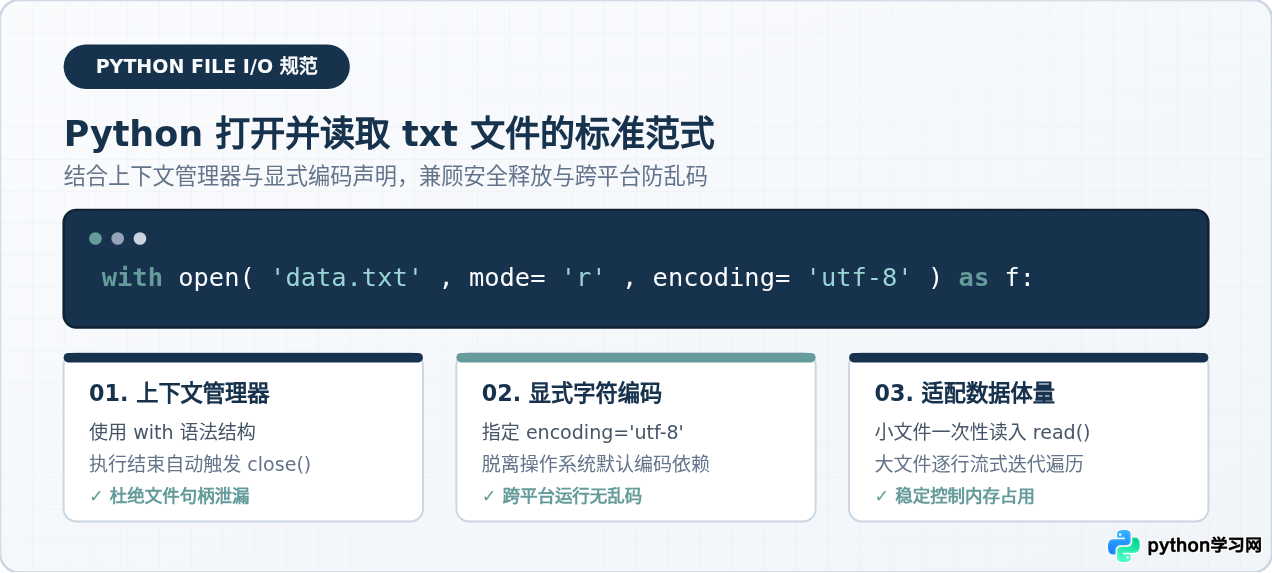
open() 函数配合 with 上下文管理器,并显式指定字符编码 encoding='utf-8'。这种语法结构不仅能在代码块执行完毕后自动关闭文件、避免内存与系统文件句柄泄漏,还能防止跨平台时常见的字符乱码问题。
一、标准操作步骤:使用 with 语句安全读写
向初学者介绍文件读取时,最推荐的写法就是直接使用 with open(...) 结构。我们先看一段能够立即在本地运行的完整代码示例:
# demo.py:标准打开并读取 txt 文件
with open('example.txt', mode='r', encoding='utf-8') as f:
    content = f.read()
    print(content)
这是第二行内容。
这段代码包含四个关键部分,各自承担着特定的职责:
- 文件路径('example.txt'):表示要打开的目标文本。如果文件和 Python 脚本在同一个工作目录下,直接写文件名即可;若在其他位置,则需要提供相对路径或绝对路径。
- 打开模式(mode='r'):字符
'r'代表以只读(Read)模式打开文件。如果不显式写该参数,Python 默认也是只读模式,但显式声明能使代码意图更直观。如果文件不存在,此模式会抛出FileNotFoundError。 - 字符编码(encoding='utf-8'):文本文件本质上是以特定编码存储的字节序列。显式指定
'utf-8'可以避免 Python 使用操作系统的默认编码(如中文 Windows 环境下默认使用 GBK),防止中文字符解析乱码。 - 上下文管理器(with ... as f):将打开的文件流对象命名为变量
f。无论在后续读取过程中是否发生异常,一旦代码执行离开with缩进块,Python 都会自动调用底层释放方法,确保文件被妥善关闭。
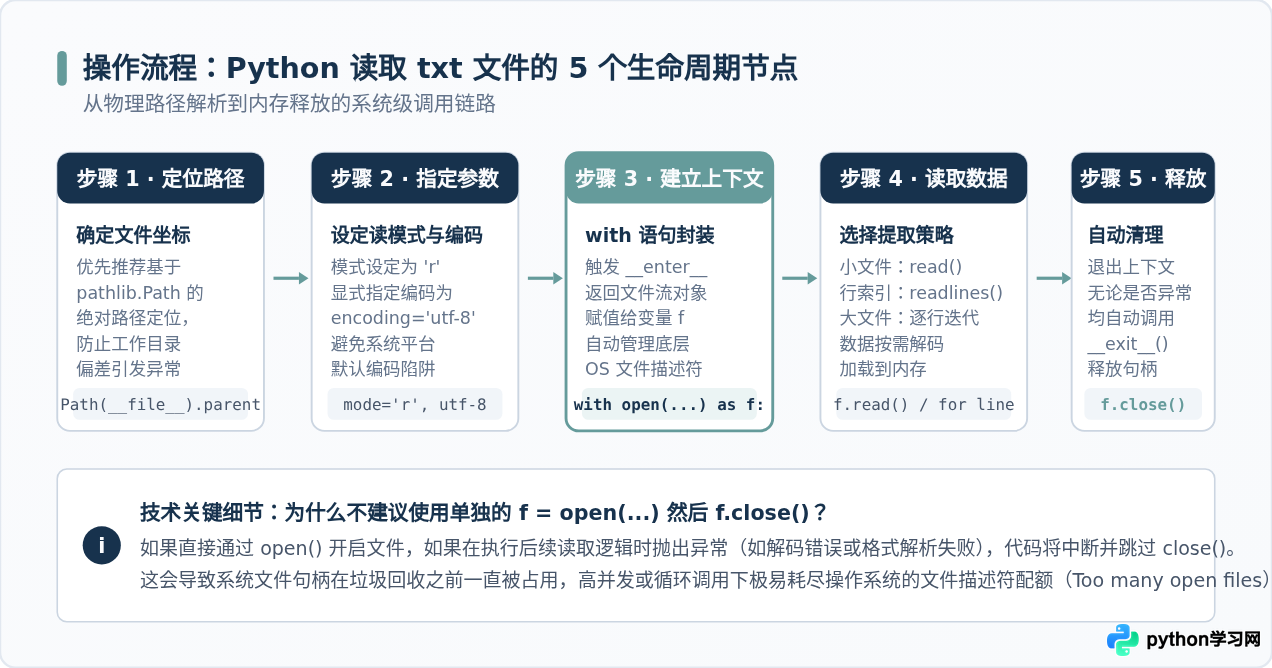
很多早期教材中常见手动调用
close() 的写法。但在实际项目中,如果在读取内容或处理逻辑阶段产生错误,程序会直接中断退出,导致最后的 f.close() 永远无法被执行。长期运行的后台任务可能会因此积累大量未释放的文件描述符,最终引发系统崩溃。
二、四种读取方式及适用场景分析
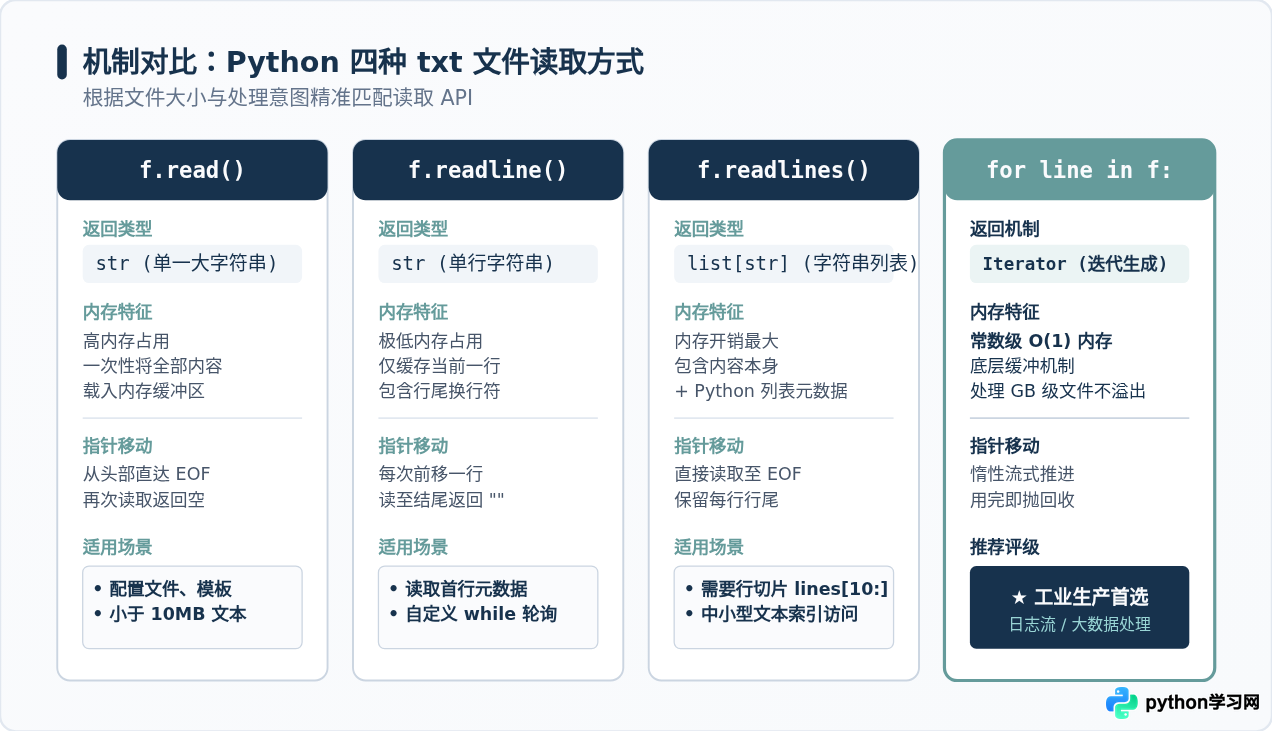
当成功打开文件并获得文件流对象 f 后,Python 提供了多种方法来提取文本内容。常见的方式包括 read()、readline()、readlines() 以及直接遍历文件对象。了解它们的运行机制与内存开销,可以帮助我们在面对不同大小的文件时做出正确选择。
1. 一次性读取全部内容:f.read()
f.read() 会从当前文件指针位置一直读到文件结尾(EOF),并将整个文本以一个完整的字符串(str)形式返回。
with open('config.txt', 'r', encoding='utf-8') as f:
    text = f.read()
    print(f"文件总字符数: {len(text)}")
适用场景:文件体积较小(例如小于 10MB 的配置文件、Prompt 模版、短篇文章)。如果需要做全局正则表达式匹配或文本替换,这种方式最为顺手。但切忌用它直接读取几百兆甚至数吉字节的超大日志,否则会导致内存瞬时暴增甚至产生内存溢出(MemoryError)。
2. 逐行读取:f.readline()
f.readline() 每次仅读取文件中的一行内容。它会从当前指针开始读取,直到遇到换行符
为止。当读取到文件末尾时,它会返回一个空字符串 ""。
with open('data.txt', 'r', encoding='utf-8') as f:
    header = f.readline().strip()  # 读取并剔除首行元数据两端的空白与换行符
    first_row = f.readline().strip()
    print(f"表头: {header}")
    print(f"第一行记录: {first_row}")
适用场景:只想探查文件的前几行内容、校验文件头部格式,或者编写自定义循环精细控制每次读取的行数。
3. 读取所有行到列表:f.readlines()
f.readlines() 会将整个文本的每一行作为独立元素读取到一个列表中,返回类型为 list[str]。注意,列表中每个字符串元素的末尾通常都包含原有的换行符
。
with open('data.txt', 'r', encoding='utf-8') as f:
    lines = f.readlines()
    # 使用列表切片查看最后 3 行,并清洗换行符
    tail_lines = [line.rstrip('
') for line in lines[-3:]]
    print(tail_lines)
适用场景:适合需要在内存中通过列表下标随机访问某一行,或者进行多重切片与反转操作的中小型文本。
4. 内存高效的工业级方案:逐行迭代文件对象(for line in f)
在 Python 中,打开的文件对象 f 本身就是一个可迭代对象(Iterator)。使用 for line in f: 结构遍历时,Python 会在底层利用分块缓冲机制按需读取单行,而不是把整个文件装入内存。
with open('access.log', 'r', encoding='utf-8') as f:
    for line_no, line in enumerate(f, start=1):
        clean_text = line.rstrip('
')
        if 'ERROR' in clean_text:
            print(f"行 {line_no}: {clean_text}")
核心优势:这种流式处理方式的内存消耗几乎是常数级(O(1))。即便面对 20GB 大小的海量服务器日志,执行该循环时的内存占用也只有数十千字节,是实际生产开发中最推荐的逐行处理范式。
三、必须重视的两大高发问题:路径与编码
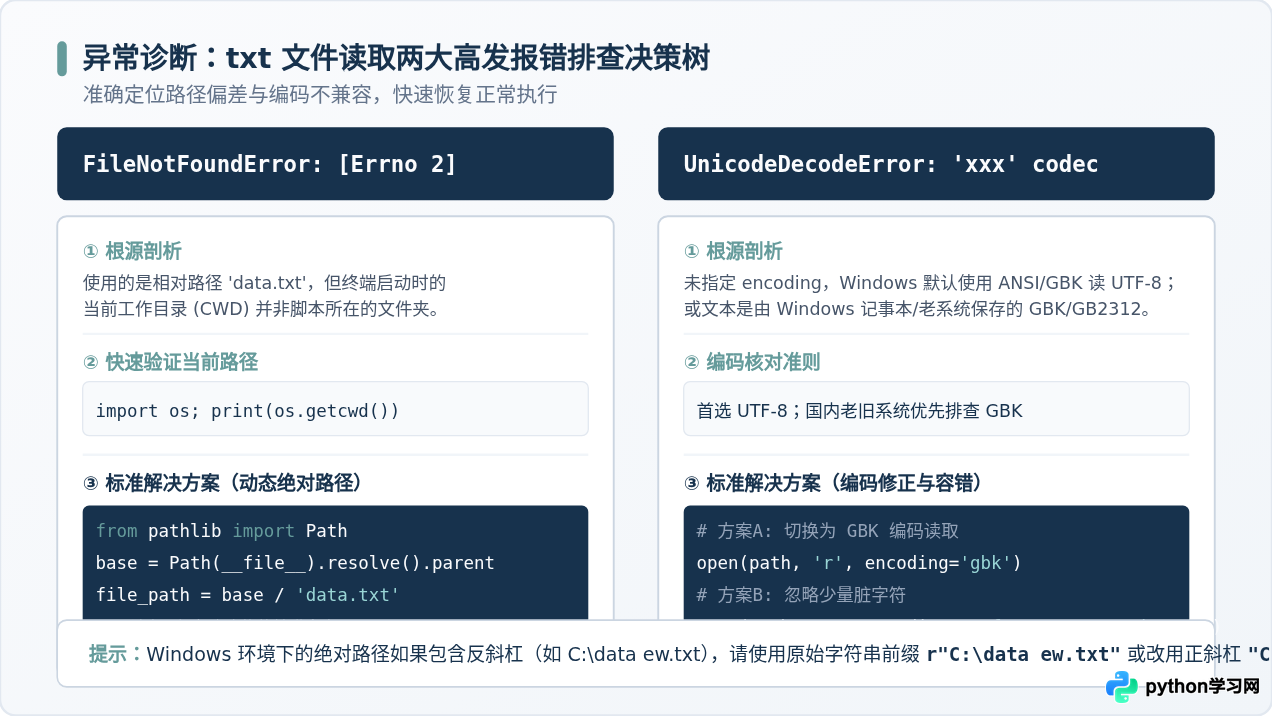
在日常开发中,打开 txt 文件失败通常并非 Python 语法写错,而是因为遭遇了路径找不到或字符编码不匹配。了解其底层原因后,便能从容应对。
1. 路径问题:如何避免 FileNotFoundError
当执行 open('data.txt') 时,Python 默认在当前工作目录(Current Working Directory, CWD)中寻找该文件。如果你的代码文件位于 /project/src/run.py,但在项目根目录 /project 下启动命令,工作目录就是根目录,此时直接写 data.txt 就会提示找不到文件。
为了保证代码无论从哪个终端路径启动都能准确找到同目录下的文件,建议使用内置的 pathlib 模块构建动态绝对路径:
from pathlib import Path

# 获取当前脚本所在文件夹的绝对路径
BASE_DIR = Path(__file__).resolve().parent
file_path = BASE_DIR / 'data.txt'

with open(file_path, 'r', encoding='utf-8') as f:
    data = f.read()
Windows 路径转义说明:在 Windows 操作系统中,文件路径通常使用反斜杠(如 C: est
ew.txt),其中的 或
会被 Python 误判为制表符或换行符转义。此时必须在字符串前加上 r 标记为原始字符串(Raw String),如 r"C: est
ew.txt",或者统一改用正斜杠 "C:/test/new.txt"。
2. 编码问题:如何解决 UnicodeDecodeError
常见报错为:UnicodeDecodeError: 'gbk' codec can't decode byte ... 或 'utf-8' codec can't decode byte ...。这说明指定的解码方式与文件实际写入时的编码规则产生了冲突。
- 情况一:未指定
encoding参数,Windows 中文系统默认使用 GBK 尝试解码 UTF-8 编码的文本。解决办法:显式声明encoding='utf-8'。 - 情况二:文件本身是由 Windows 记事本默认以 ANSI/GBK 格式保存的中文文本,用 UTF-8 读取时报错。解决办法:将参数调整为
encoding='gbk'。 - 情况三:文本中夹杂了损坏的不规则字节,希望跳过异常字符以完成读取。解决办法:加入
errors='ignore'参数实现容错读取:with open('corrupted.txt', 'r', encoding='utf-8', errors='ignore') as f: text = f.read()
四、健壮的生产级代码模式
在实际工程或自动化脚本中,文件可能被移动、被误删,或者由于权限问题无法读取。通过结合 try-except 结构,可以使程序在遇到异常时给出明确提示,而不会直接崩溃:
from pathlib import Path

def safe_read_txt(target_filename: str) -> str:
    target_path = Path(__file__).resolve().parent / target_filename

    try:
        with open(target_path, mode='r', encoding='utf-8') as f:
            return f.read()
    except FileNotFoundError:
        print(f"[错误] 目标文件不存在,请核实路径: {target_path}")
    except UnicodeDecodeError:
        # 备选降级策略:尝试用 gbk 编码读取
        print("[提示] UTF-8 解码失败,正在尝试以 GBK 编码重新读取...")
        try:
            with open(target_path, mode='r', encoding='gbk') as f:
                return f.read()
        except Exception as inner_e:
            print(f"[错误] GBK 读取仍然失败: {inner_e}")
    except PermissionError:
        print(f"[错误] 没有权限读取该文件: {target_path}")
    return ""

# 执行测试
data = safe_read_txt("sample.txt")
五、总结与技术选型决策矩阵
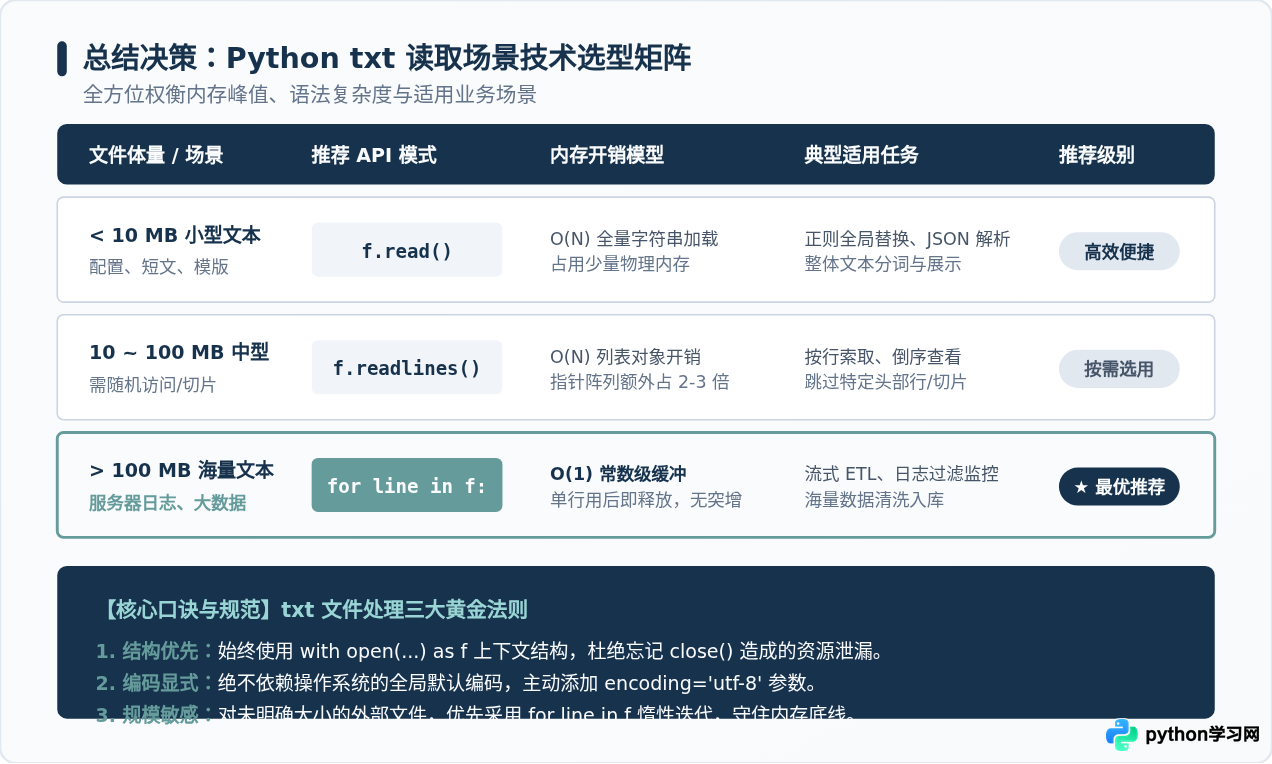
为了在不同业务场景中快速做出合理的方案选择,下表及图示对常见的 txt 读取方式进行了综合对比:
| 读取方式 | 返回数据结构 | 内存占用峰值 | 是否保留换行符 | 最佳适用业务场景 |
|---|---|---|---|---|
f.read() |
str(单一字符串) |
高(等同文本大小) | 包含全部换行 | 配置文件、JSON/模板读取、短文本全局替换 |
f.readline() |
str(单行字符串) |
极低(单行缓冲区) | 保留当前行末尾换行 | 探查文件首行/表头、精细控制读取步长 |
f.readlines() |
list[str](字符串列表) |
最高(文本+列表指针) | 各元素保留末尾换行 | 小文件随机索引、行反转、特定切片访问 |
for line in f: |
Iterator(逐行流) |
常数级(O(1) 极低) | 保留当前行末尾换行 | 日志流分析、海量数据逐行清洗、工业级首选 |
记住三个核心原则即可轻松应对几乎所有文本读取任务:优先使用 with open 确保系统句柄及时释放;显式标注 encoding='utf-8' 杜绝跨平台乱码;面对未明确大小的数据优先使用 for line in f: 守住程序内存底线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









