

Python查找文件中包含中文的行方法
本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
2026-10-13
5

本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
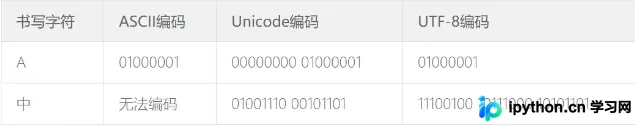
本文深入解析Python字符串的本质,阐述其作为Unicode码点不可变序列的定义。详细梳理ASCII、GB2312到Unicode及UTF-8的编码演进,并对比Python与Java在字符串定义、多行支持及字符处理上的差异,帮助开发者理解底层原理与跨语言特性。
本文介绍在pandas中筛选包含中文字符的列时,因编码类型不匹配导致的常见错误。通过导入sys模块设置默认编码或在字符串前添加u前缀声明unicode,可有效解决该问题。
本文介绍在Python中分离中英文文本的两种常用方法。针对超短文本,可通过ASCII码值直接过滤;对于复杂混合文本,利用Unicode编码范围\u4e00-\u9fa5及正则表达式匹配英文字符与空格,实现精准提取。
Python3 默认使用 Unicode 编码,不再提供 sys.setdefaultencoding 方法。处理中文乱码时,应在输出序列化阶段通过 str.encode('GBK') 将字符串转换为本地编码字节串,从而实现与外部环境的兼容交互。
本文深入解析Python中的编码机制,通过复现常见的UnicodeDecodeError错误,剖析ASCII默认解码导致的冲突。详细阐述decode与encode的工作原理,解释Unicode对象作为内部统一表示形式的优势,并提供处理多编码文本文件的最佳实践建议。
本文总结Python 2.7环境下处理中文编码的实用技巧。通过设置默认编码、使用unicode函数处理文件路径,以及利用codecs模块写入BOM头,可有效解决文件名及Excel打开时的中文乱码问题。
本文详细介绍Python中去除字符串多余字符的多种技巧。涵盖使用strip系列方法处理两端空白,利用切片拼接删除固定位置字符,通过replace或re.sub清理任意位置的多类字符,以及利用str.maketrans和unicodedata模块处理Unicode组合字符与音调符号,帮助开发者高效完成文本清洗任务。
本文总结了 Python 2 中常见的中文处理问题,包括文件注释乱码、变量打印异常及编码转换方法。通过添加编码声明、使用 sys.setdefaultencoding 及 codecs 库,可有效解决 UTF-8 与 GBK 互转、复杂结构打印乱码等难题,帮助开发者在迁移至 Python 3 前优化现有代码。
本文深入解析Python处理中文乱码的核心原理,重点区分“字符”与“字节”的概念。通过对比Python、Perl及Ruby在编码处理上的差异,解释str与unicode的区别,以及encode和decode的实际作用,帮助开发者从根本上理解并解决编码问题。
本文详解Python中正则表达式如何启用ASCII模式。针对Python3默认Unicode编码与Python2 ASCII编码的差异,介绍通过re.ASCII标志实现兼容旧代码的方法。结合代码示例对比ASCII与Unicode模式下\w+匹配非ASCII字符(如法语、波兰语、德语)的结果,帮助开发者理解字符集处理机制。
本文详解Python中chr、unichr和ord三个字符转换函数的用法。chr接收0-255整数返回对应字符,unichr返回Unicode字符,ord则反向获取字符的ASCII或Unicode数值。文章包含具体代码示例及异常处理说明,帮助开发者掌握字符与编码的转换技巧。