

PHP/JS中UTF-8与Unicode编码区别及字数计算实现
深入解析UTF-8变长编码与Unicode固定长度的区别,展示二进制转换逻辑。提供前端JavaScript计算UTF-8字节数的方法及后端PHP针对不同编码(GBK/UTF-8)计算字符长度的实用代码方案,解决跨平台文本长度校验问题。
2026-10-13
4

深入解析UTF-8变长编码与Unicode固定长度的区别,展示二进制转换逻辑。提供前端JavaScript计算UTF-8字节数的方法及后端PHP针对不同编码(GBK/UTF-8)计算字符长度的实用代码方案,解决跨平台文本长度校验问题。
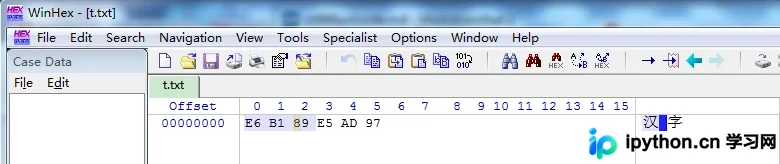
本文介绍在Python中处理UTF-8文件时,如何去除数据中的\u0000等Unicode控制字符,以及如何将反斜杠u类型的\uXXXX字符串转换为对应的Unicode字符。通过Python的decode函数配合unicode-escape编码,可实现字符串的正确解码与清理。
本文对比Python2与Python3在字符串处理上的核心差异。Python2区分str与unicode类型,而Python3中所有字符串默认为Unicode,并引入bytes类型处理字节数据。文章通过代码示例展示类型判断及操作差异,帮助开发者理解版本间的兼容性问题。
本文详解Python3处理Unicode编码转中文时的常见误区,特别是通过requests获取非硬编码字符串时的显示问题。提供了利用decode().encode('unicode_escape')进行转换的具体代码方案,并介绍了使用__future__模块及codecs库解决文件写入UnicodeEncodeError的方法,帮助开发者避免Python2迁移过程中的编码困扰。
本文深入解析Python中json.dumps处理中文时的编码机制。重点讲解ensure_ascii参数对非ASCII字符转义的影响,结合requests库发送数据时的常见错误,剖析Unicode码点转换原理及源码实现逻辑,并提供服务器端识别转义字符串的正确解码方法。
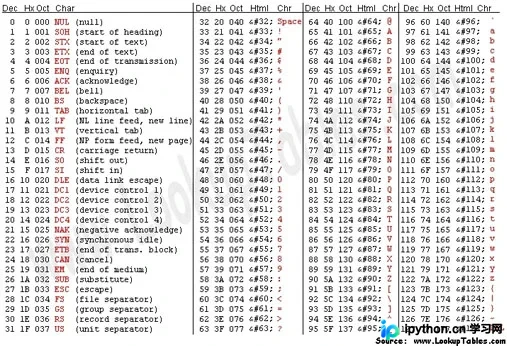
本文详解 Python 中处理复杂文本过滤与清理的多种方案。涵盖使用 str.translate() 进行字符映射、利用 unicodedata 处理 Unicode 组合字符与重音符号,以及通过 encode/decode 剥离非 ASCII 字符。重点对比 str.replace() 与 translate() 的性能差异,提供针对空格、控制字符及数字转换的高效代码示例,帮助开发者在保持数据纯净的同时优化运行效率。
本文详细解析Python 2与Python 3在字符编码处理上的核心差异。Python 2默认使用ASCII,需手动指定编码;而Python 3默认采用UTF-8。文章深入探讨了内存中Unicode存储机制、终端编码转换过程,以及通过u前缀解决乱码问题的具体方法,帮助开发者理解并避免编码错误。
本文详解Python2中Unicode与Str类型的转换机制,以及Python3中Str与Bytes的区别。重点解析Python2默认ASCII编码对中文的限制,Python3默认UTF-8编码下的字符串处理。通过具体代码示例说明decode与encode的正确用法,以及Python2中Unicode转字符串的特殊技巧,帮助开发者理解不同版本间字符串处理的差异。
本文介绍在 Python 中利用正则表达式判断字符串是否包含简体中文或非简体中文的方法。通过定义匹配 Unicode 汉字范围的编译对象,结合 search 方法实现检测,并提供了完整的代码示例供参考。
本文深入解析Python3中str(Unicode)与bytes类型的核心差异。详细阐述两者在I/O操作中的角色,演示显式编码与解码的正确方法,并通过文件读写示例说明如何避免编码错误。掌握“内部Unicode、外部Bytes”原则,提升Python编程中的数据处理准确性。
本文详细解析Python2与Python3在字符串类型处理上的核心差异,重点阐述Python3中str与bytes的区别。针对爬虫开发中常见的GBK编码错误,提供从decode到encode的完整转换逻辑,并给出print输出及文件读写时的具体解决方案,帮助开发者避免编码陷阱。
本文深入解析 Python 3 中 Unicode 字符串的内部存储机制,包括 Latin-1、UCS-2 和 UCS-4 三种编码方式对内存占用的影响。通过 sys.getsizeof 和 cbytes 工具演示如何检测编码类型,并详细阐述字符串驻留(String Interning)技术及其在常量、短字符串中的应用场景,帮助开发者理解并优化 Python 程序中的内存使用效率。