
TensorFlow矩阵运算实战:乘法、点乘与累加操作详解
本文深入解析TensorFlow中的核心矩阵运算。通过具体代码实例,演示如何使用tf.matmul进行多维矩阵乘法,利用tf.multiply实现元素级点乘及广播机制,并掌握tf.reduce_sum按指定轴进行行/列累加的方法。
2026-10-12
6


本文深入解析TensorFlow中的核心矩阵运算。通过具体代码实例,演示如何使用tf.matmul进行多维矩阵乘法,利用tf.multiply实现元素级点乘及广播机制,并掌握tf.reduce_sum按指定轴进行行/列累加的方法。
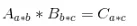
本文介绍在TensorFlow中如何使用expand_dims和squeeze函数对Tensor进行维度扩展与压缩。通过具体示例说明如何指定axis参数在特定位置增加或移除尺寸为1的维度,适用于文本挖掘、Embedding处理及卷积操作前的形状调整。
在使用 TensorFlow 进行模型训练或推理时,若代码强制指定 GPU 设备而当前环境仅有 CPU,会触发 Operation was explicitly assigned to /device:GPU:0 报错。本文介绍通过修改 tf.app.Flags.DEFINE_boolean 参数 clone_on_cpu 的值,将其从 False 改为 True,从而解决该设备分配冲突问题。
本文介绍在TensorFlow中屏蔽Warning的几种方式,包括通过设置环境变量TF_CPP_MIN_LOG_LEVEL和Python代码中配置os.environ。详细说明了不同日志级别的含义,以及如何在Linux终端中临时或永久屏蔽Warning。
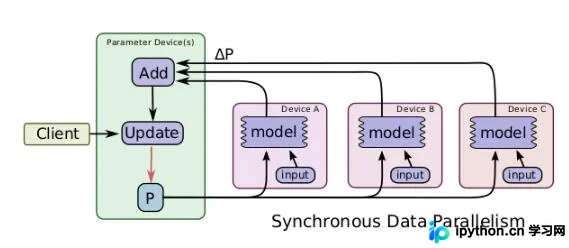
本文深入解析TensorFlow的三种核心分布式并行策略:数据并行、模型并行及模型计算流水线并行。详细对比同步与异步数据并行的机制与适用场景,阐述模型并行在大规模参数处理中的应用,以及流水线并行如何优化单设备资源利用率,帮助开发者根据模型规模与硬件条件选择最优训练方案。
本文介绍在TensorFlow中如何处理任意尺寸输入数据的Batch梯度更新。当网络支持不同尺寸图片时,可通过先独立计算每个样本的梯度,再在内存中累加或求平均,最后统一应用优化器更新参数。该方法避免了固定Placeholder的限制,实现了灵活的异步梯度更新策略。
本文介绍TensorFlow中两种主要的张量拼接方式:tf.concat与tf.stack。tf.concat沿现有轴拼接,保持维度数不变;tf.stack沿新轴拼接,增加维度。通过具体代码示例展示不同axis参数下的输出结果差异,帮助开发者根据需求选择合适的拼接方法。
本文深入解析TensorFlow的核心机制,涵盖计算图的构建与执行流程。详细阐述如何通过Context Manager建立Graph,利用Session启动Op并分发至硬件设备。重点讲解Fetches参数在run()中的应用,以及Variable状态管理、初始化方法及与Optimizer的交互,帮助开发者掌握模型训练的基础架构。
本文解决TensorFlow中tf.nn.max_pool的ksize参数必须为整型常量,无法直接使用tf.shape()返回的动态张量值的问题。通过对比tf.reshape与max_pool的参数差异,介绍利用tf.reduce_max替代固定窗口池化的方法,适用于PointNet等需要动态处理特征维度的场景。
本文解决Python3.5在Windows 10环境下导入Keras时因TensorFlow依赖缺失导致的DLL加载失败报错。通过安装Microsoft Visual C++ 2015 Redistributable Update 3,并重新安装TensorFlow,可有效修复该问题。
本文详解在MacOS High Sierra 10.13.3系统中解决Python 2.7与Anaconda冲突的方法。通过配置PYTHONPATH环境变量切换至Python 3.6,并逐步指导安装OpenCV及Keras,包括处理cv2.so链接及TensorFlow依赖,帮助开发者顺利搭建本地AI开发环境。
在Django项目中调用基于TensorFlow的Keras模型时,常遇到Tensor不在当前图的ValueError。本文介绍通过导入keras模块并在加载模型后执行clear_session()及预测测试来重置计算图,从而解决该错误。