

Python基础入门:字符串、变量与控制流详解
本文详细解析Python基础语法,涵盖字符串的三种定义方式及转义字符处理,变量类型的动态确定机制,以及基于缩进的代码块结构。重点讲解if、while、for等控制流语句及break、continue的使用,辅以完整代码示例,帮助开发者快速掌握Python核心编程要素。
2026-10-13
6

本文详细解析Python基础语法,涵盖字符串的三种定义方式及转义字符处理,变量类型的动态确定机制,以及基于缩进的代码块结构。重点讲解if、while、for等控制流语句及break、continue的使用,辅以完整代码示例,帮助开发者快速掌握Python核心编程要素。
本文系统介绍了Python中字符串的常用处理方法与操作技巧。内容涵盖字符串包含判断、相等性比较、多种拼接方式(包括%s格式与format)、大小写转换、居中与填充、编码处理、查找定位(find与index)、分割与连接(split/join)、替换以及标题格式转换等核心功能。通过具体代码示例,帮助开发者掌握字符串操作的关键参数与返回值,提升代码编写效率。
本文详解Python中正则表达式(re模块)的使用流程,涵盖compile、search与findall方法及Match对象的应用。通过固话匹配示例解析可选字符处理,进而演示结合requests模块提取网页中所有HTTP/HTTPS链接。最后介绍如何利用正则匹配图片后缀并配合os模块实现批量下载存储,提供从理论到实战的完整代码逻辑。
本文详解Python中re模块的正则表达式应用,涵盖match、search、findall及split函数的具体用法。通过对比各函数在匹配位置、返回结果形式上的差异,结合完整代码示例,帮助开发者快速掌握字符串处理技巧,提升代码简洁性与执行效率。
本文通过三道Python正则表达式面试题,详细演示了如何使用re模块处理常见文本清洗任务。内容涵盖利用sub方法去除HTML标签、从URL中提取域名,以及通过split或findall方法提取字符串中的单词。每道题均提供完整代码示例与运行结果,帮助开发者掌握正则表达式在数据预处理中的实际应用技巧。
本文系统介绍Python中正则表达式的基础语法、匹配原理及re模块的核心方法。详细解析贪婪与非贪婪模式的区别,列举compile、match、search、findall等常用函数的参数与返回值,并通过代码示例展示匹配对象的使用,帮助开发者高效处理字符串匹配任务。
本文详解Python求解最长回文子串长度的两种核心方法。首先介绍基础的中心扩展法,通过插入特殊字符统一处理奇偶长度回文串。随后深入分析Manacher算法的优化思路,利用已知最大半径提前剪枝,避免无效计算。通过对比1000个字符的测试数据,展示优化后算法性能提升约10倍的实际效果,并提供完整代码实现与测试案例。
本文介绍Python中处理文本字符串的常用技巧。通过string.split()进行基础分割,利用正则表达式排除标点符号,过滤空字符串,并使用.lower()统一大小写。结合完整邮件示例,展示从原始文本到标准化词表的完整处理流程,适用于基础NLP数据清洗场景。
本文深入解析Python re模块中findall()函数的返回机制。重点阐述正则表达式中括号数量对结果格式的影响:多括号返回元组列表,单括号返回匹配子串列表,无括号返回完整匹配列表。通过实例代码清晰展示不同场景下的数据提取方式,帮助开发者准确处理正则匹配结果。
本文通过Python温度转换实例,详细解析了input获取用户输入、字符串切片提取数值以及eval函数求值的核心知识点。文章展示了如何区分摄氏度与华氏度,利用float或eval处理数据,并结合条件判断实现双向转换,为初学者提供完整的代码逻辑与语法说明。
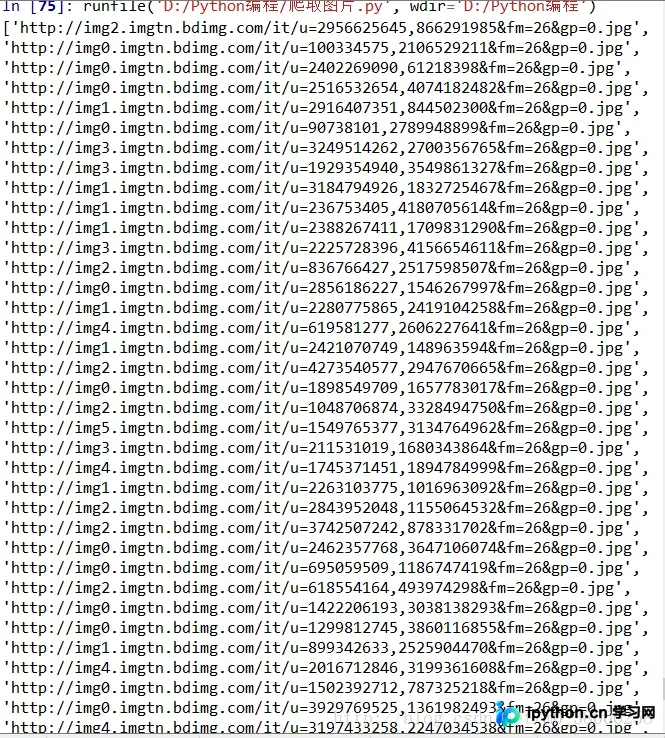
本文介绍如何使用Python标准库urllib获取网页源代码,并结合正则表达式提取页面中的图片链接。通过定义匹配thumbURL的正则模式,批量获取指定搜索页面的图片地址,适用于基础爬虫开发学习。
本文介绍使用Python编写网易网络爬虫的完整示例,通过urllib2请求页面、正则表达式提取标题及文本内容,并将结果保存至TXT文件。代码基于Python 2.7开发,涵盖页面加载、编码转换及数据存储流程,适合Python初学者参考学习网络爬虫基础实现。