

Python爬虫实战:抓取段子网搞笑段子数据
本文介绍如何利用Python语言编写一个简单的网络爬虫,从段子网(ishuo.cn)批量抓取搞笑段子。通过解析URL规律并结合urllib与re模块,实现对段子内容的自动提取与本地存储,为聊天机器人或内容发布提供数据支持。
2026-10-13
8

本文介绍如何利用Python语言编写一个简单的网络爬虫,从段子网(ishuo.cn)批量抓取搞笑段子。通过解析URL规律并结合urllib与re模块,实现对段子内容的自动提取与本地存储,为聊天机器人或内容发布提供数据支持。
本文介绍在Python中判断字符串是否为合法JSON格式的两种方法。核心思路是利用json.loads进行解析,若抛出ValueError则说明格式不合法。示例代码展示了如何封装函数,并强调需先检查变量类型是否为字符串,避免非字符串输入引发错误。
本文介绍了使用Python生成简单验证码的两种实现方式。首先展示了基于random模块的自定义代码,通过while循环和字符串拼接生成6位随机字符;随后解析了经过优化的示例代码,利用randrange、chr和randint函数组合生成包含大小写字母和数字的验证码。文章附带详细注释,适合初学者理解随机数生成及字符串操作逻辑。
本文详解Python中正则表达式如何启用ASCII模式。针对Python3默认Unicode编码与Python2 ASCII编码的差异,介绍通过re.ASCII标志实现兼容旧代码的方法。结合代码示例对比ASCII与Unicode模式下\w+匹配非ASCII字符(如法语、波兰语、德语)的结果,帮助开发者理解字符集处理机制。
本文详解C语言中字符串字符反向排列的多种实现方法,重点区分“反向排列”与“逆序打印”。内容涵盖基于sizeof与strlen的非递归循环方案,以及严格限制使用库函数的纯递归算法。通过代码解析数组传参陷阱、指针交换逻辑及递归边界处理,帮助开发者掌握底层字符串操作技巧。
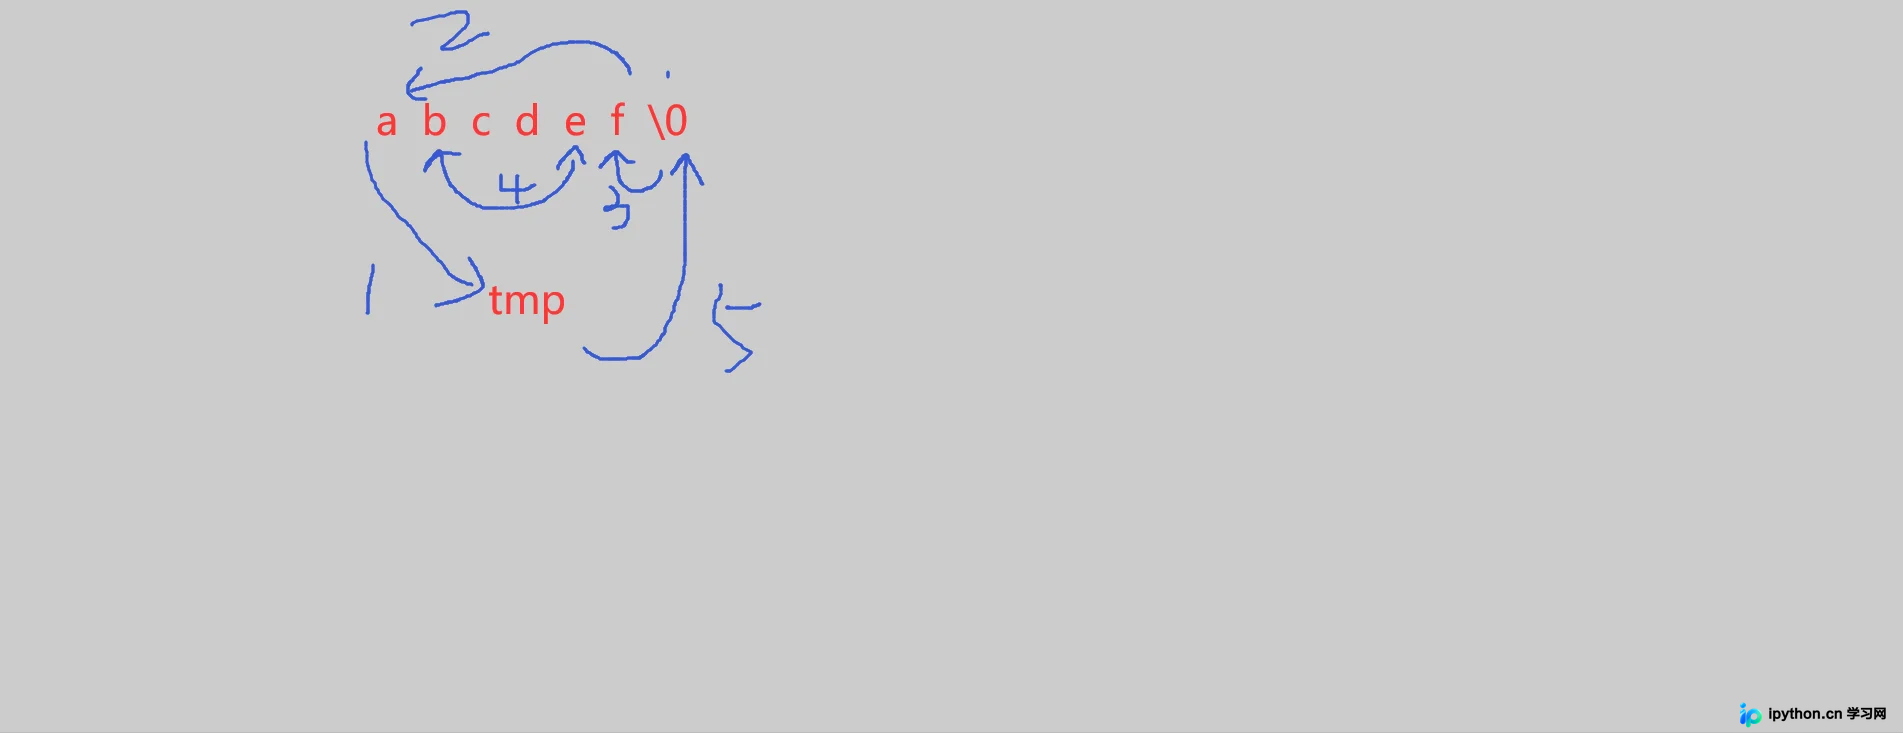
本文深入解析Python内建函数raw_input()与input()的功能差异。raw_input()始终将输入视为字符串,而input()会尝试执行输入的Python表达式并返回对应类型。文章通过代码示例说明两者在处理字符串和数字输入时的不同行为,并建议一般交互场景优先使用raw_input()。
本文详细对比了Python2与Python3中print语句/函数的差异。Python2中print为语句,支持%格式化、%r万能输出及自动换行控制;Python3中print为函数,推荐使用format()方法,支持位置索引、关键字参数及属性访问。文章涵盖整数、浮点数、字符串、列表、字典及矩阵的多种输出格式,帮助开发者掌握不同版本下的输出技巧。
本文深入解析Python正则表达式模块中的compile函数,详解其语法结构及flags匹配标志的多种用法,包括忽略大小写、多行模式等。通过具体代码示例展示如何将正则字符串转换为高效的Pattern对象,帮助开发者掌握正则表达式的优化匹配技巧。
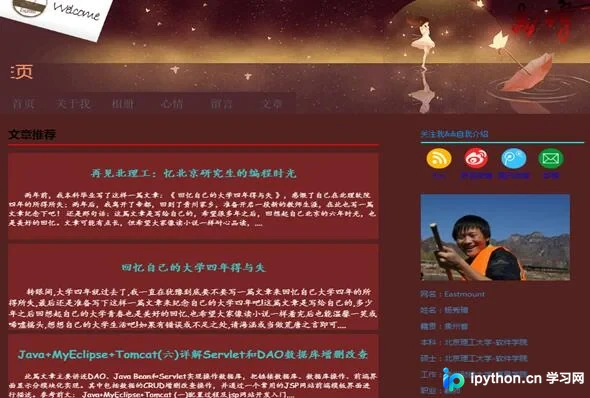
本文详细解析Python中正则表达式(Regex)在爬虫开发中的应用。通过介绍re模块的核心函数如findall、compile、match及search,结合抓取网页标题、超链接、表格内容及图片URL的具体代码示例,演示如何高效提取HTML数据。最后通过完整实例展示如何爬取个人博客的标题、图片及文章摘要,帮助初学者掌握基础网络数据抓取技巧。
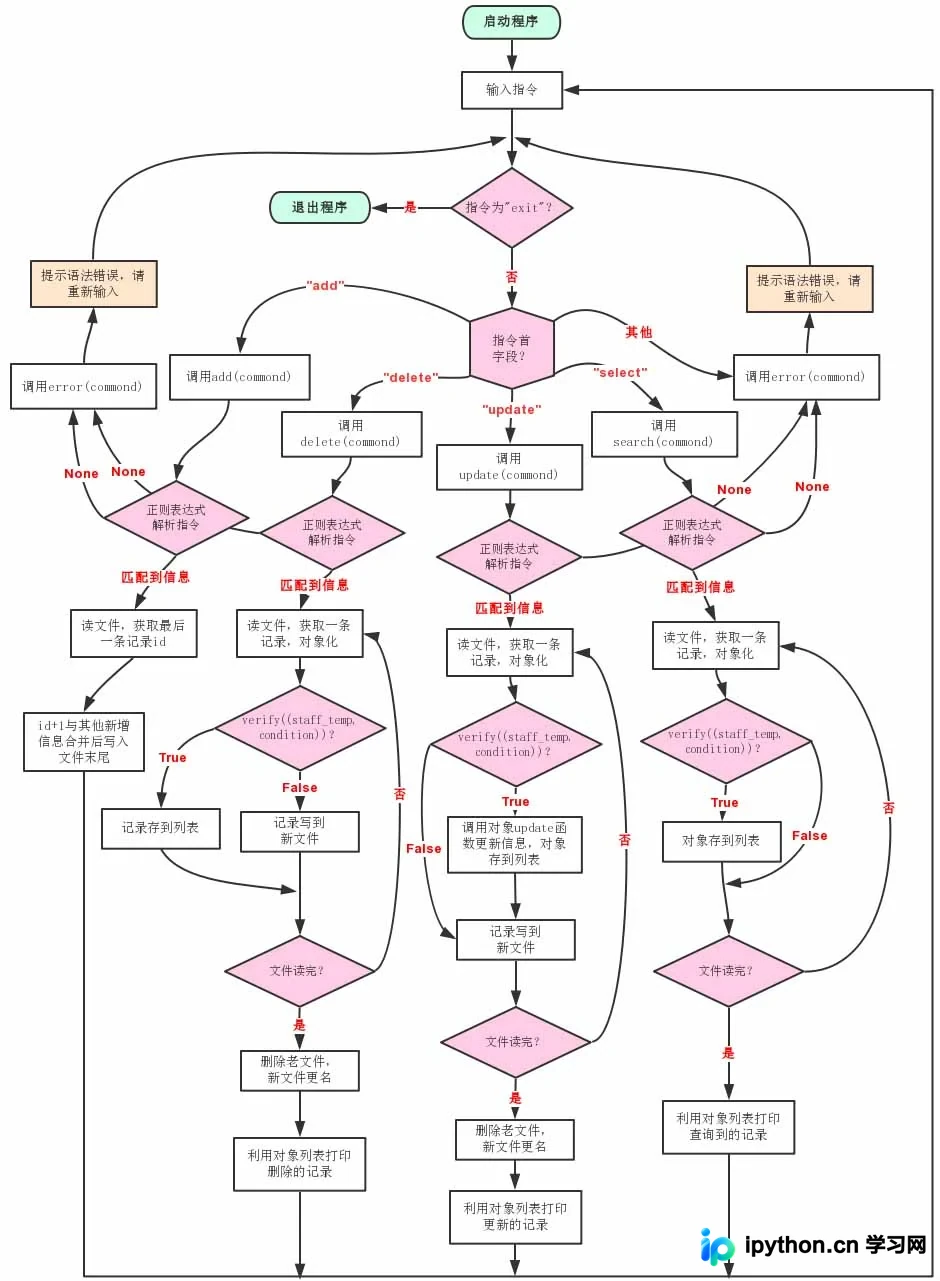
本文介绍一个基于Python编写的简易员工信息数据库模拟程序。通过正则表达式解析指令,利用面向对象方法封装员工数据,实现了增、删、改、查四大核心功能。程序支持逻辑运算符组合查询,演示了如何从文件读取数据并执行类似SQL的交互操作,适合初学者理解数据库底层逻辑与Python编程实践。
本文深入解析Python中正则表达式的组嵌套机制,通过具体代码实例展示如何构建复杂的正则模式。详细说明了利用嵌套组匹配多重字符序列的方法,并附带完整的测试代码及输出结果分析,帮助开发者掌握高级正则技巧。
本文介绍如何在Python中使用正则表达式提取包含“因为……所以”的文本,重点解决嵌套结构的查找问题。通过组嵌套技术构建复杂表达式,并展示具体的代码实现与输出格式,帮助开发者掌握正则表达式中分组嵌套的高级应用技巧。