

Python处理HTML和XML实体及特殊字符的方法
本文介绍Python中处理HTML和XML字符串的常用方法。通过html.escape()函数转义特殊字符,利用encode()方法处理非ASCII编码实体,以及使用HTMLParser和xml.sax.saxutils进行实体解码。建议优先使用解析器自动处理,确保文本安全与格式正确。
2026-10-14
6

本文介绍Python中处理HTML和XML字符串的常用方法。通过html.escape()函数转义特殊字符,利用encode()方法处理非ASCII编码实体,以及使用HTMLParser和xml.sax.saxutils进行实体解码。建议优先使用解析器自动处理,确保文本安全与格式正确。
本文介绍在Python中输出百分比的两种主要方式:使用{:.2%}直接格式化,以及先转为float再拼接%符号。详细解析了小数位控制、参数序号指定及format函数的使用细节,适用于Python3环境。
本文详解Python中实现字符串对齐的多种方法,包括ljust、rjust和center内置函数,以及更通用的format()函数。通过示例展示如何指定宽度和自定义填充字符,对比旧式%操作符,推荐在代码中优先使用format()以实现更灵活的对象格式化。
本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
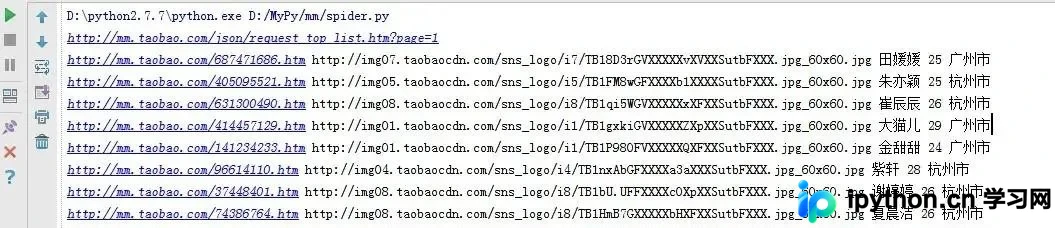
本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。
本文深入解析 Python 中合并字符串的多种方法。重点对比 join() 与加号(+)操作符的性能差异,指出在大量字符串连接时 join() 的优势。同时探讨生成器表达式与 yield 语句在构建大规模输出时的灵活性,并结合 I/O 操作场景给出最佳实践建议,帮助开发者避免常见的性能陷阱。
本文详细介绍PyCharm中的多种全局搜索方式,包括按文件名搜索文件的Ctrl+N、搜索所有类型文件的Ctrl+Shift+N(支持路径搜索)、全局字符串查找Ctrl+Shift+F(Find in Path)以及综合搜索的双Shift。内容涵盖快捷键冲突解决、精细设置选项及双Shift的多功能汇总特性,帮助开发者高效定位代码资源。
本文详解 Python 中正则表达式处理多行文本的常见陷阱。当使用点号(.)匹配任意字符时,默认无法匹配换行符。文章介绍了两种解决方案:一是通过非捕获组(?:.\n)显式包含换行符;二是利用 re.compile 的 re.DOTALL 标志,使点号能匹配包括换行符在内的所有字符。同时对比了两种方法的适用场景,建议复杂模式优先使用标志位以提高代码可读性和维护性。
本文详细介绍Python抓取指定网页图片的两种核心方法:基于正则表达式匹配URL与基于BeautifulSoup解析HTML标签。通过完整代码示例,演示如何获取网页源码、提取图片链接并保存至本地,同时提供优化建议,如结合两种方法提高抓取效率及添加请求头规避反爬机制。
本文详细解析Python中字符串方法strip()的工作原理。该函数用于移除字符串头部和尾部的指定字符或序列,默认去除空白符。通过具体代码示例,展示了不带参数及带参情况下的不同处理逻辑,强调其仅作用于首尾且忽略顺序的特性,帮助开发者准确掌握字符串清洗技巧。
本文介绍Python中字符串的upper()方法,该方法用于将字符串中的所有小写字母转换为大写字母。文章详细说明了其语法结构、参数说明(无参数)、返回值类型,并通过具体代码实例展示了upper()函数的实际调用方式与输出结果,帮助开发者快速掌握字符串大小写转换的基本操作。
本文介绍在Python中使用Pandas将指定列转换为字符串类型的两种主要方法:在读取Excel文件时通过dtype参数直接指定,以及使用apply()函数对已有数据列进行转换。此外,还补充了无需apply即可修改全列时间格式的高效技巧,适用于需要提取特定日期数据的场景。