

Python字符串格式化中双大括号{{}}的作用及元组、列表、字典基础用法
本文解析Python字符串.format()方法中使用双大括号{{}}表示字面量大括号的机制,并系统梳理Python三大核心序列类型:元组、列表和字典的基础语法、创建方式、可变性及常用内置函数,帮助开发者快速掌握基础数据结构操作。
2026-10-16
5

本文解析Python字符串.format()方法中使用双大括号{{}}表示字面量大括号的机制,并系统梳理Python三大核心序列类型:元组、列表和字典的基础语法、创建方式、可变性及常用内置函数,帮助开发者快速掌握基础数据结构操作。
本文详细解析Python中time和datetime两个内置模块在时间处理上的应用。重点介绍如何将当前时间转换为时间戳或结构化时间,以及如何在时间戳、时间字符串和datetime对象之间进行相互转换。通过具体代码示例,展示strftime、strptime、mktime、timestamp等关键函数的用法,帮助开发者掌握时间格式化处理技巧。
本文详解Python中读取TXT文件时split()函数的正确使用方法。通过对比带参与不带参的split(),揭示使用split(" ")引入空字符串和换行符的风险,并展示如何利用无参split()高效清理数据。文章提供将多行多列数据转换为二维列表和NumPy数组的完整代码示例,帮助开发者避免常见陷阱,提升数据处理效率。
本文深入解析Python中字符串截取与切片的核心机制,涵盖正向与反向索引规则、切片语法[start:end:step]的具体用法及实例演示。同时提供两种自定义字符串截取函数的实现方案,分别适用于单次提取和批量提取特定标签间内容的场景,助力开发者高效处理XML、JSON等字符串数据。
本文介绍Python中实现字符串模式匹配的方法,以及利用内建函数maketrans和translate进行字符映射与替换的技术。通过具体示例展示如何构建映射表、执行字符串替换,并指出该方法在加密解密中长度一致且字符唯一的限制条件。
本文深入解析Python中判断两个字符串是否为乱序排列的多种实现方式。从基础的遍历移除法(O(n^2))到排序比较法(O(nlogn)),再到基于字符计数的线性时间复杂度解法(O(n)),详细对比了各方案的时间复杂度与代码实现。文章还探讨了利用Counter优化计数的技巧,帮助开发者根据实际场景选择最优算法。
本文介绍使用Python统计英文单词数量的方法。通过读取文本文件并按空格分割字符串,计算列表长度及空字符串数量,从而得出实际单词数。代码示例展示了从文件读取、分割到计数的完整流程,并与Word统计结果进行对比,误差在2%以内,可作为参考。
本文详细介绍Python中将字符串转换为数字的5种常用方法。涵盖使用int()和float()进行基础类型转换,利用eval()求值表达式,通过isdigit()判断纯数字字符串,以及借助正则表达式从复杂文本中提取数字。每种方法均提供代码示例与异常处理说明,帮助开发者根据实际需求选择合适方案。
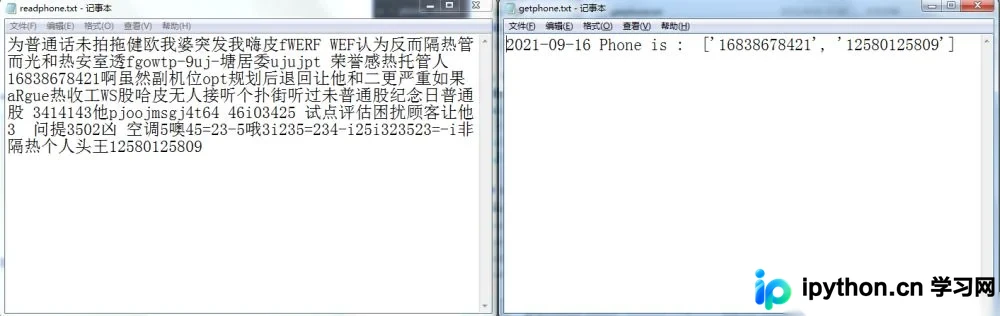
本文详细介绍如何使用Python 3.8.6结合os与re库,从TXT文本中批量提取11位手机号码。通过正则表达式精准匹配数字序列,并演示如何创建输出文件、追加写入结果及添加时间戳。提供完整可运行代码及操作步骤,适用于数据清洗与自动化办公场景。
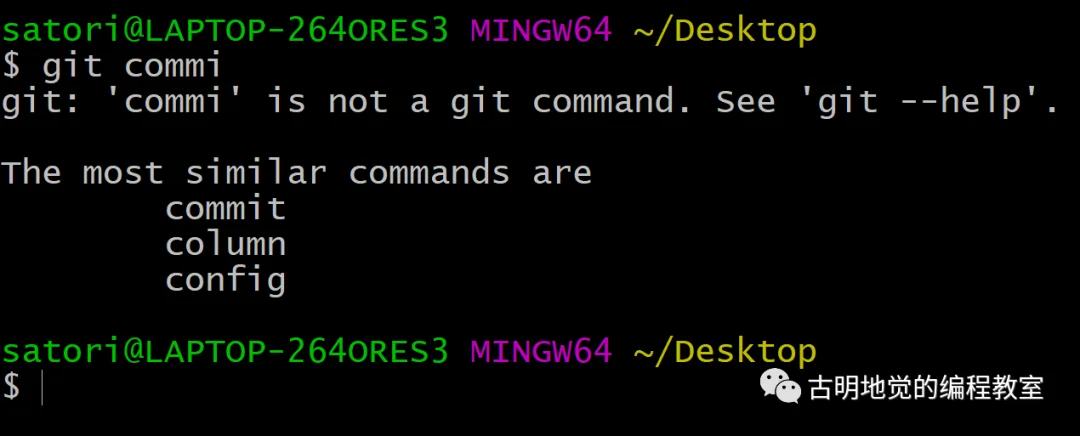
本文介绍如何使用 Python 的 fuzzywuzzy 库计算两个字符串之间的相似度。该库基于 Levenshtein Distance 算法,提供了 ratio、partial_ratio 等多种匹配模式。通过 fuzz 和 process 模块,可实现如 Git 命令输错时的相似命令推荐功能,并附带性能优化建议。
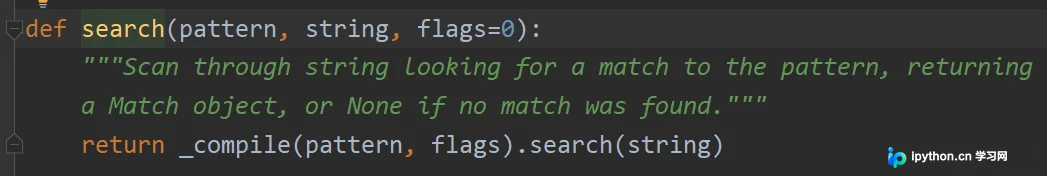
本文深入解析Python中正则表达式模块re的search()函数。详细讲解其匹配机制、可选参数flags(如re.I忽略大小写、re.S包含换行符等)的具体含义,并通过多个代码示例演示如何提取字符串、处理分组匹配及使用命名分组。结合HTML解析实战,对比search与findall的区别,帮助开发者掌握高效字符串匹配技巧。
本文深入解析Python中正则表达式圆括号()的使用陷阱。重点说明re.findall()在有分组时仅返回分组内容,而re.search().group()可获取完整匹配。通过Hive与Python代码对比,阐述括号在分组、字符集及量词中的区别,帮助开发者避免匹配结果不符合预期的问题。