

Python读取TXT文件:split()函数的正确用法与避坑指南

本文详解Python中读取TXT文件时split()函数的正确使用方法。通过对比带参与不带参的split(),揭示使用split(" ")引入空字符串和换行符的风险,并展示如何利用无参split()高效清理数据。文章提供将多行多列数据转换为二维列表和NumPy数组的完整代码示例,帮助开发者避免常见陷阱,提升数据处理效率。
在处理txt格式文件时,我们经常需要提取包含多行多列的数据。当使用Python读取这些文件时,原始数据会以string类型被载入内存,此时如何高效且准确地进行数据类型转换便成为了关键挑战。
本文将介绍一种直观的数据读取方式,并重点分析其中容易出现的错误用法及其解决方案。
为了演示,我们准备了一个包含三行数据的测试文件,其内容结构如下所示。
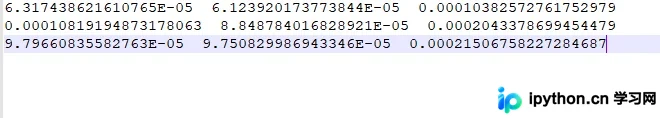
首先,我们采用以下代码片段来读取整个文件,利用readlines()方法一次性获取所有行数据。
with open(r"C:\Users\15025\Desktop\debug1.txt", "r") as f:
    all_data = f.readlines()
    print(all_data)
# ['6.317438621610765E-05  6.123920173773844E-05  0.00010382572761752979\n', '0.00010819194873178063  8.848784016828921E-05  0.0002043378699454479\n', '9.79660835582763E-05  9.750829986943346E-05  0.00021506758227284687']
观察输出结果可以发现,所有数据被合并显示在同一行中,但内部包含三个由单引号包裹的字符串片段,这与我们测试文件中实际的三行数据一一对应。
接下来,我们需要将这些整体字符串拆分为独立的string单元,随后即可利用如float等类型转换关键字对具体数值进行转换处理。
观察原始数据,各字段之间以空格分隔。基于此特征,我们直觉上会倾向于使用.split(" ")方法,通过指定空格作为分隔符来拆分数据。
让我们尝试编写如下测试代码。
with open(r"C:\Users\15025\Desktop\debug1.txt", "r") as f:
    all_data = f.readlines()
    all_data = all_data[0].split(" ")
    print(all_data)
# ['6.317438621610765E-05', '', '6.123920173773844E-05', '', '0.00010382572761752979\n']在代码实现中,我们首先通过all_data[0]选取第一行数据,接着调用split(" ")函数对其进行分割处理。
虽然这种方法看似实现了分割目的,但结果中却混入了""表示的空字符串元素,且末尾残留了\n换行符,这种数据脏污情况给后续处理带来了不小的麻烦。
上述做法实际上陷入了一个常见的编程误区。
以下是更为推荐的标准处理流程。
with open(r"C:\Users\15025\Desktop\debug1.txt", "r") as f:
    all_data = f.readlines()
    all_data = all_data[0].split()
    print(all_data)
# ['6.317438621610765E-05', '6.123920173773844E-05', '0.00010382572761752979']在使用split()函数时,若省略参数不指定分隔符,Python会自动处理连续空白字符,从而一次性清除""空字符串项并去除末尾的\n换行符,同时完成字符串的有效分割。
若需处理多行数据并输出结构化结果,建议预先定义一个容器数组来存储解析后的数据。完整的处理代码如下(该模式适用于所有多行多列数据的读取场景):
方案一:将数据解析为二维列表形式。
array2d = []
with open(r"C:\Users\15025\Desktop\debug1.txt", "r") as f:
    all_data = f.readlines()
    for i in range(len(all_data)):
        temp_list = []
        for element in all_data[i].split():
            temp_list.append(float(element))
        array2d.append(temp_list)

print(array2d)
#[[6.31743862e-05, 6.12392017e-05, 0.000103825728],
# [0.000108191949, 8.84878402e-05, 0.00020433787],
# [9.79660836e-05, 9.75082999e-05, 0.000215067582]]
方案二:将数据解析为二维数组形式。
import numpy as np

array = np.zeros((3, 3))
with open(r"C:\Users\15025\Desktop\debug1.txt", "r") as f:
    all_data = f.readlines()
    for i, line in enumerate(all_data):
        numbers = line.split()
        for j, element in enumerate(numbers):
            array[i, j] = float(element)

print(array)
# [[6.31743862e-05 6.12392017e-05 1.03825728e-04]
#  [1.08191949e-04 8.84878402e-05 2.04337870e-04]
#  [9.79660836e-05 9.75082999e-05 2.15067582e-04]]
以上为个人总结的经验分享,旨在为读者提供参考。希望本文能帮助大家更好地掌握相关技巧,也欢迎大家继续支持本站获取更多技术内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









