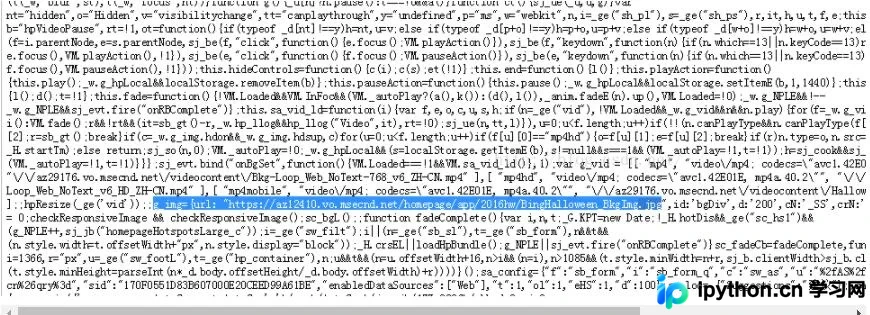
Python正则表达式re模块六大核心函数详解
本文详细解析Python中re模块的六种核心字符串匹配方法。涵盖re.match从头匹配、re.search全局搜索、re.sub替换、compile预编译优化、findall返回列表及finditer返回迭代器的具体用法与区别,结合代码示例说明正则表达式在URL解析等场景中的应用。
2026-10-13
7

本文详细解析Python中re模块的六种核心字符串匹配方法。涵盖re.match从头匹配、re.search全局搜索、re.sub替换、compile预编译优化、findall返回列表及finditer返回迭代器的具体用法与区别,结合代码示例说明正则表达式在URL解析等场景中的应用。
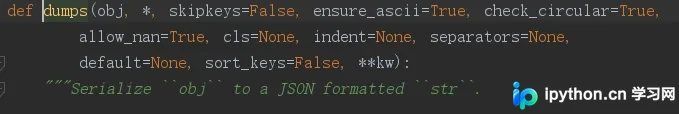
本文详解Python3中JSON数据的编解码方法,重点介绍json模块下的dumps和loads函数。通过示例演示如何将Python字典转换为JSON字符串(dict to str),以及如何将JSON字符串还原为Python字典(str to dict),适用于网络爬虫等场景下的数据解析需求。
本文探讨Python中将字符串常量动态转化为变量名的两种核心方法。通过修改全局命名空间(globals)和动态执行代码(exec),实现从字符串到变量的映射。文章详细解析了两种方案的原理、代码示例及注意事项,旨在解决动态生成变量名的技术难题,并引申出对eval与exec区别及安全性的讨论。
本文深入解析Python内置函数eval的功能与隐患。eval可将字符串表达式转换为实际对象,实现字符串到列表、字典等结构的便捷转换,并通过globals和locals参数控制变量作用域。然而,eval能执行任意系统命令,存在严重的代码注入风险。文章通过具体示例展示其强大之处与潜在危害,提醒开发者在享受灵活性的同时必须严格把控输入安全。
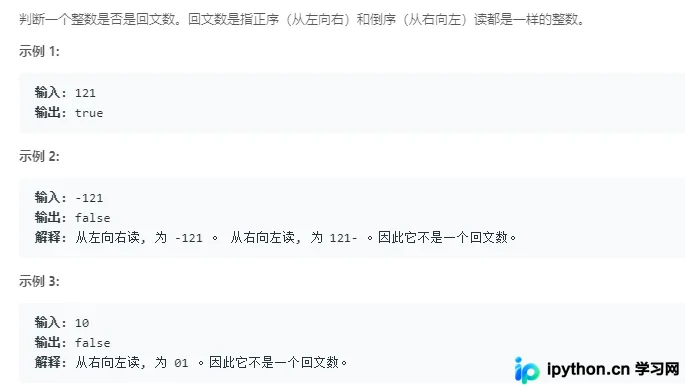
本文介绍Python中判断整数是否为回文数的两种常见算法。第一种方法通过字符串转换与切片反转实现,代码简洁直观;第二种方法避免使用字符串,通过取模运算将整数拆解为数组并检查对称性,同时处理了负数情况。两种方法各有适用场景,供开发者参考。
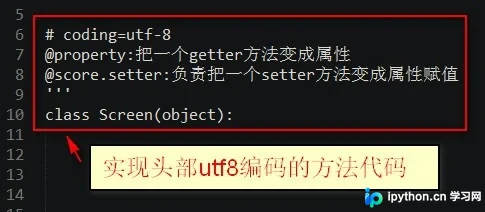
本文详细解析在Python中将数字1格式化为01的完整实现步骤。内容涵盖UTF-8编码处理、属性读取与写入方法、高度与分辨率函数的实现,以及最终判断逻辑的整合。通过分步代码展示,帮助开发者掌握字符串格式化与对象属性管理的核心技巧,适用于需要严格格式控制的开发场景。
本文深入解析Python中文件读取的三种核心方法:read()、readlines()和readline()。重点对比它们在返回类型、内存占用及适用场景上的差异,特别是针对大文件读取时的内存优化策略。同时,结合fp.readlines()、str.strip()和str.split()等常用字符串处理函数,讲解从文件读取字符串到数值转换的完整流程,并解决常见的io.UnsupportedOperation错误。
本文介绍Python中根据用户输入的月份判断季节的逻辑,以及处理固定列表并格式化为特定字符串输出的方法。通过具体代码示例,展示条件判断与列表切片拼接技巧,帮助开发者快速掌握基础语法应用。
本文介绍在Python中使用格式化字符串输出百分号的方法。由于百分号是格式化操作的特殊字符,直接输出需使用两个连续的百分号%%进行转义,例如print('%s%%'%(5))可正确输出5%。
本文介绍在Python中读取TXT文件并提取特定位置字符的方法。通过open函数打开文件,使用readlines()读取所有行,再结合split()方法以固定字符为分隔符进行分割,最后通过索引n获取目标字符串并写入新文件。
本文介绍如何在Python中从HTML的div标签中提取纯文本。通过结合使用re.compile编译正则表达式与re.sub进行替换,配合BeautifulSoup解析HTML结构,可有效去除标签符号。文中详细解析了正则编译标志及原生字符串的使用,并提供了完整的抓取与保存示例代码。
本文分析Python中使用正则表达式匹配网页图片URL时,因HTML源码包含换行符导致匹配失败的问题。通过对比单行与多行字符串匹配结果,指出默认模式下'.'不匹配换行符。解决方案为在re.compile中传入re.S标志,使点号匹配所有字符包括换行符,从而完美提取跨行显示的图片地址。