

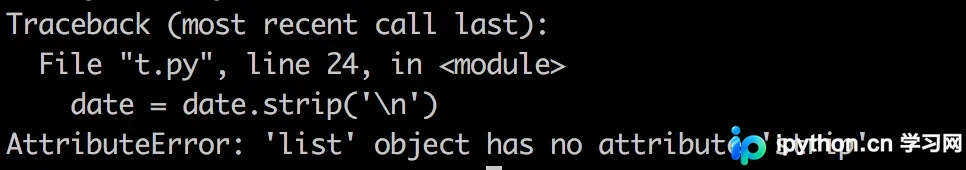
Python中消除readlines读取文件时行尾\n的方法
本文介绍在Python中使用readlines读取文件时,如何有效去除每行末尾的换行符\n。通过对比join+strip、splitlines以及逐行strip三种方法,分析其适用场景与注意事项,帮助开发者选择最合适的字符串处理方案。
2026-10-13
6

本文介绍在Python中使用readlines读取文件时,如何有效去除每行末尾的换行符\n。通过对比join+strip、splitlines以及逐行strip三种方法,分析其适用场景与注意事项,帮助开发者选择最合适的字符串处理方案。
本文介绍如何使用Python编写脚本实现文件中指定子串的替换功能。通过读取源文件并写入新文件,支持可选的备份参数,确保操作安全。文章提供了完整的代码示例及执行过程解析,适用于需要批量修改文本内容的场景。
本文详细解析使用Python3爬取淘宝商品信息的完整代码流程。通过requests获取网页源码,利用正则表达式精准提取价格、名称、地址及图片链接,并展示如何遍历多页数据并格式化输出结果。代码包含异常处理机制,适合初学者理解网络爬虫的基本逻辑与实现细节。
本文详细解析Python基础语法,涵盖字符串的三种定义方式及转义字符处理,变量类型的动态确定机制,以及基于缩进的代码块结构。重点讲解if、while、for等控制流语句及break、continue的使用,辅以完整代码示例,帮助开发者快速掌握Python核心编程要素。
本文系统介绍了Python中字符串的常用处理方法与操作技巧。内容涵盖字符串包含判断、相等性比较、多种拼接方式(包括%s格式与format)、大小写转换、居中与填充、编码处理、查找定位(find与index)、分割与连接(split/join)、替换以及标题格式转换等核心功能。通过具体代码示例,帮助开发者掌握字符串操作的关键参数与返回值,提升代码编写效率。
本文详解Python中正则表达式(re模块)的使用流程,涵盖compile、search与findall方法及Match对象的应用。通过固话匹配示例解析可选字符处理,进而演示结合requests模块提取网页中所有HTTP/HTTPS链接。最后介绍如何利用正则匹配图片后缀并配合os模块实现批量下载存储,提供从理论到实战的完整代码逻辑。
本文系统介绍Python中正则表达式的基础语法、匹配原理及re模块的核心方法。详细解析贪婪与非贪婪模式的区别,列举compile、match、search、findall等常用函数的参数与返回值,并通过代码示例展示匹配对象的使用,帮助开发者高效处理字符串匹配任务。
本文深入解析Python re模块中findall()函数的返回机制。重点阐述正则表达式中括号数量对结果格式的影响:多括号返回元组列表,单括号返回匹配子串列表,无括号返回完整匹配列表。通过实例代码清晰展示不同场景下的数据提取方式,帮助开发者准确处理正则匹配结果。
本文介绍使用Python编写网易网络爬虫的完整示例,通过urllib2请求页面、正则表达式提取标题及文本内容,并将结果保存至TXT文件。代码基于Python 2.7开发,涵盖页面加载、编码转换及数据存储流程,适合Python初学者参考学习网络爬虫基础实现。
本文分享了一个基于Python字符串和列表基础知识的简易名片管理系统实现。作者通过添加、删除、修改和查询功能演示了列表的基本用法,其中修改功能采用先删除后添加的策略。文章提供了完整代码示例,旨在帮助初学者理解列表在简单业务逻辑中的应用。
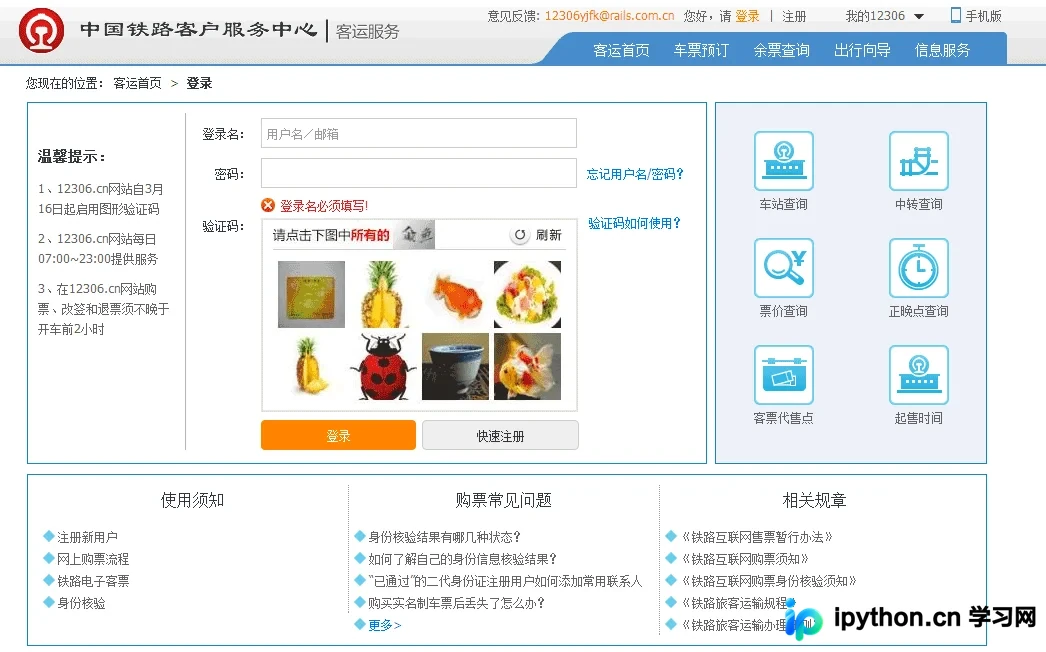
本文介绍利用Python破解12306按字找图验证码的方法。主要流程包括下载并裁剪验证码图片,调用百度识图接口进行图像分析,最后通过正则表达式提取关键字。文中提供了完整的Python实现代码,并推荐了正则表达式在线测试与生成工具,供开发者参考使用。
本文介绍如何使用Python生成随机日期字符串并插入数据库。通过设定起止时间元组,转换为时间戳后随机选取,再格式化为指定字符串。示例代码展示了从时间元组到时间戳,再到格式化输出的完整流程,适用于需要批量生成测试数据的场景。