

Python实现百度贴吧帖子全楼层图片批量下载
本文提供基于Python 2.7的百度贴吧图片爬取完整代码。通过requests获取页面,利用BeautifulSoup解析img标签,结合正则表达式提取最大页码,实现自动遍历所有楼层并批量保存高清原图至本地指定目录。
2026-10-13
6

本文提供基于Python 2.7的百度贴吧图片爬取完整代码。通过requests获取页面,利用BeautifulSoup解析img标签,结合正则表达式提取最大页码,实现自动遍历所有楼层并批量保存高清原图至本地指定目录。
本文详细介绍如何利用Python语言随机生成符合规范的手机号码,并结合2017年最新正则表达式进行有效性验证。文章提供了完整的代码实现、运行结果展示以及正则测试工具推荐,帮助开发者快速掌握手机号生成与校验的核心技巧。
本文介绍在Python中利用locale模块实现中文按拼音排序的具体方法。通过安装中文语言包并设置LC_COLLATE环境变量,结合strcoll函数与sort排序算法,可完成中文列表的有序排列。文中提供了完整的测试代码及输出示例,并推荐了在线排序工具供参考。
本文介绍在CentOS7.3.1611_x64系统Python 2.7.5环境下,如何高效批量替换多个源文件中的指定字符串。提供了两种方案:利用sed与grep组合命令快速处理,以及编写Python脚本实现跨平台(含Windows)的目录遍历替换。
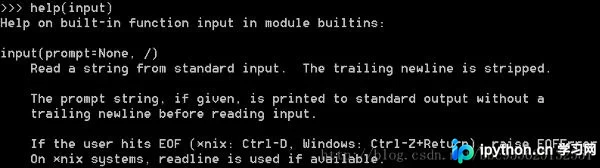
本文详细解析Python3中的input函数,说明其作为内建函数从标准输入读取字符串并忽略换行符的机制。重点对比Python2中input与raw_input的区别,指出Python3整合二者后统一将所有输入视为字符串处理的特性,并介绍类型转换方法。
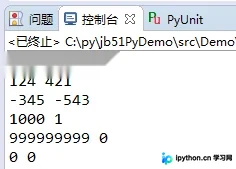
本文介绍Python中实现数字逆序输出的具体方法。代码处理正负数、前导零及溢出情况,通过字符串转换与列表操作完成逻辑。提供完整函数定义及测试用例,帮助开发者理解字符串切片与条件判断在数值处理中的应用。
本文详细解析Python中正则表达式的贪婪与非贪婪匹配机制,通过re.findall示例对比\d+与\d+?的差异。同时深入讲解多行匹配场景,说明如何运用re.S使点号匹配换行符,以及利用re.M让^和$符号作用于每一行,帮助开发者精准控制正则匹配行为。
本文介绍一种利用Python将字符串按指定行数进行Z字形(或之字形)列分配,随后按行拼接输出的实现方法。通过构建二维矩阵并填充空白占位符,清晰展示字符在行与列间的分布逻辑,提供完整代码及多组测试用例,帮助开发者理解字符串重排算法的核心思路。
本文介绍如何使用pandas库将包含日期字符串的Series转换为表示星期几的Series。主要步骤包括利用pd.to_datetime将字符串序列转换为datetime格式,随后通过weekday()方法提取每个日期的星期信息,实现从日期字符串到星期几的高效转换。
本文总结Python中将字符串转换为字典的三种常用方式:利用eval函数直接转换、通过json模块进行双向转换以及处理Unicode编码字符串。文章详细解析了各方法的代码示例、适用场景及注意事项,帮助开发者根据实际需求选择最合适的转换方案,确保数据处理的准确性与安全性。
本文深入解析Python中re模块findall函数在处理包含括号的正则表达式时的行为差异。重点说明当正则表达式存在多个捕获组时,findall返回的是元组列表而非完整匹配字符串;单括号时返回括号内内容;无括号则返回整体匹配结果。理解这一机制有助于避免数据提取错误。
本文详细介绍Python中百分号%的两种主要用途:数值模运算与字符串格式化。通过具体代码示例,讲解如何获取余数以及利用%s、%d等占位符进行字符串拼接,涵盖宽度、精度及对齐方式等格式化参数设置。