Python利用正则与linecache自动提取C函数声明生成头文件
本文介绍使用Python处理自动生成C代码的需求。通过正则表达式匹配以UINT32 O_开头及OUT关键字的行,结合linecache模块按行号截取内容,自动将函数实现转换为extern声明并写入.h文件。该方法适用于批量处理大型C源文件,提高头文件生成效率。
2026-10-13
6

本文介绍使用Python处理自动生成C代码的需求。通过正则表达式匹配以UINT32 O_开头及OUT关键字的行,结合linecache模块按行号截取内容,自动将函数实现转换为extern声明并写入.h文件。该方法适用于批量处理大型C源文件,提高头文件生成效率。
本文详细介绍Python中将列表转换为字符串的多种实现方式,包括使用join方法、map函数以及列表推导式。同时涵盖字符串分割为列表的split操作及去除首尾字符的strip用法,通过具体代码示例展示不同数据类型下的转换技巧与注意事项。
本文介绍在Python中将列表(List)转换为字符串并添加指定分隔符的方法。核心技巧是使用join函数配合生成器表达式。针对包含中文的情况,需特别注意编码设置,文中提供了针对Python 2的sys.setdefaultencoding解决方案及通用处理建议,帮助开发者避免编码错误。
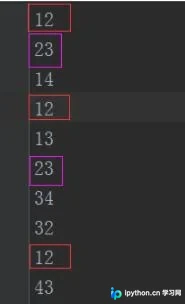
本文介绍使用Python读取TXT文件内容,按行分割后利用列表特性去除重复行,并将去重后的结果写入新TXT文件的完整方法。通过具体代码示例展示文件读写及列表操作过程,帮助开发者快速实现文本数据的清洗与备份。
本文介绍Python中利用strip()函数清除字符串前后空格的方法。该方法仅去除首尾空白,保留中间空格,区别于正则表达式re.sub会清除所有空格。通过代码示例对比strip()与re.sub(' ','',str)的输出结果,帮助开发者根据需求选择合适方案。
本文介绍如何利用Python的re库和正则表达式快速提取文件名的前缀部分。通过解析正则模式r'(.+?)\.',实现从完整文件名中剥离扩展名并获取核心名称,适用于需要批量处理或重命名文件的场景。
本文介绍Python中保留两位小数的三种常用方法:字符串格式化'%.2f'、Decimal类以及round函数。重点指出round函数可能丢失末尾零,而Decimal需接收字符串或整型参数以避免浮点精度误差。通过代码示例对比各方法输出结果,帮助开发者根据需求选择合适方案。
本文深入解析Python中的编码机制,通过复现常见的UnicodeDecodeError错误,剖析ASCII默认解码导致的冲突。详细阐述decode与encode的工作原理,解释Unicode对象作为内部统一表示形式的优势,并提供处理多编码文本文件的最佳实践建议。
本文介绍在Python3中如何高效提取大段文本内两个指定关键字之间的内容。通过结合使用字符串查找或正则表达式模块re,可以精确捕获目标区间数据。文中提供了基于re.compile和findall方法的完整代码示例,适用于日志分析、数据清洗等场景,帮助开发者快速实现文本内容截取功能。
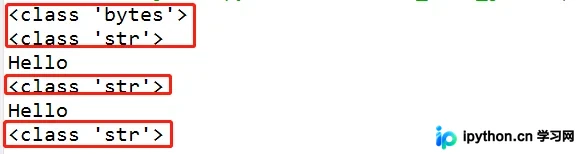
本文详解Python3中bytes与str类型的核心区别,重点演示如何创建bytes数据,并通过UTF-8和GB2312编码将字符串转换为字节序列,再解码回字符串。内容涵盖encode与decode方法的具体用法及参数设置,帮助开发者掌握二进制与文本数据的处理技巧。
本文详解Python3中bytes类型转换为str类型的两种常用方法。针对URL解析中因类型混用导致的TypeError,分别介绍了利用str()函数和bytes.decode()进行解码的操作步骤。通过完整测试代码展示转换过程,帮助开发者正确处理文本与二进制数据的区分问题。
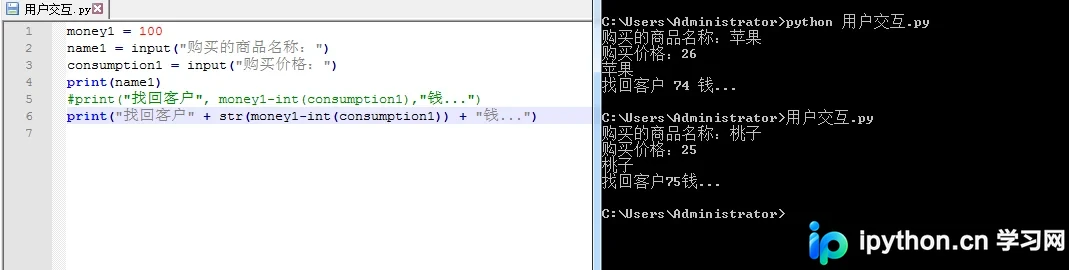
本文详解Python中实现用户交互的核心方法,重点解析input函数获取字符串数据的特性。通过账号密码输入及购物找零两个实例,演示如何利用int()和str()函数进行类型转换,并对比逗号与加号在输出拼接中的差异,帮助初学者掌握基础输入输出与类型处理逻辑。