

Python使用urllib2爬取搜狗微信搜索公众号文章
本文介绍如何使用Python的urllib2库结合正则表达式,通过搜狗微信搜索接口爬取指定公众号的文章列表。教程涵盖从构建请求URL、解析HTML文本、提取JSON数据到拼接完整文章链接的完整流程,并提供可直接运行的代码示例,帮助开发者快速实现公众号文章抓取功能。
2026-10-13
6

本文介绍如何使用Python的urllib2库结合正则表达式,通过搜狗微信搜索接口爬取指定公众号的文章列表。教程涵盖从构建请求URL、解析HTML文本、提取JSON数据到拼接完整文章链接的完整流程,并提供可直接运行的代码示例,帮助开发者快速实现公众号文章抓取功能。
Python标准库json模块严格遵循JSON规范,仅支持双引号字符串。当输入数据包含单引号时,json.loads会抛出JSONDecodeError。本文介绍一种通过eval结合json.dumps进行预处理的方法,将单引号字符串转换为标准JSON格式,从而实现正确解析。
本文介绍利用Python脚本从文本文件中筛选包含中文字符行的方法。通过结合文件读写操作与正则表达式匹配Unicode范围,实现高效的内容过滤。文中提供了完整代码示例,解析了with语句的资源管理优势及正则匹配原理,适用于多语言版本处理场景。
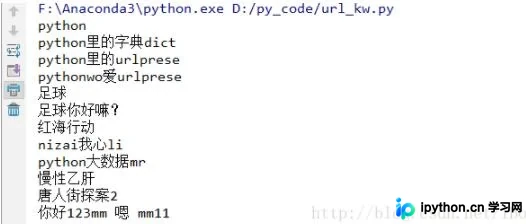
本文详细介绍如何利用Python解析URL并提取关键字。通过对比Python2与Python3的urlparse模块差异,结合正则表达式匹配query和path中的关键参数。文章提供了针对百度、搜狗等主流网站及特殊域名如weibo.com的字典映射规则,并附带完整代码与测试案例,帮助开发者高效处理各类URL解析需求。
本文深入探讨Python中按固定长度切分字符串的多种实现方式。针对无分隔符的字符串,对比了传统的for循环切片、列表推导式以及利用re模块findall函数的正则匹配方案。重点解析了正则表达式\w{1,4}在自动分组中的巧妙应用,帮助开发者根据场景选择最高效的代码实现。
本文介绍利用Python进行文件读写、正则表达式提取及集合去重的完整流程。通过示例代码展示如何遍历源文件,使用re模块匹配特定字段,并借助set数据结构实现高效去重,最终将唯一结果写入目标文件。
本文深入解析Python3中format()函数的多种用法。通过实例演示如何结合{}和:号实现字符串格式化,涵盖位置参数、关键字参数、填充对齐、精度控制及索引引用等核心功能。文章提供完整代码示例,帮助开发者掌握高效、灵活的字符串处理技巧,适用于各类Python开发场景。
本文介绍在Python中为数字字符串左侧补零的两种实用方法。第一种通过设定足够大的基数进行加法运算后截取指定子串;第二种通过计算当前字符串长度与预期长度的差值,动态生成前导零。这两种方法均可有效解决URL中日期格式需补零的问题,适用于新闻爬虫等场景。
本文详细解析Python中bytes类型数据的split分割操作。通过对比str类型的split方法,展示了bytes类型在处理二进制数据时如何正确使用分隔符进行分割。文章提供了具体的代码示例,包括测试环境版本说明,旨在帮助开发者准确掌握bytes类型的切片与分割技巧,避免常见错误。
本文介绍了在Python中去除拼音声调字母并替换为普通字母的两种方法。第一种方法利用unicodedata模块进行NFD标准化,结合dict.fromkeys和translate函数移除组合字符;第二种方法为推荐方案,通过NFKD标准化后使用encode('ascii', 'ignore')直接编码为ASCII字符串,从而高效去除声调符号。
本文介绍在 Python 3.5 环境中,通过 GBK 编码转换与 ASCII 码区间判断,实现将中文字符串转换为拼音首字母的方法。代码包含核心转换逻辑及完整调用示例,适用于需要快速获取中文拼音首字符的场景。
本文介绍在Python中如何将汉字列表保存为文本文件。关键在于处理字符编码,需在文件头部指定编码格式,并在写入时对每个汉字字符串进行UTF-8编码转换。通过示例代码展示了如何正确配置编码并执行写入操作,确保汉字内容能正确保存。