Python 通过 pyhs2 连接 Hive 并配置 Kerberos 认证详解
本文详细介绍 Python 使用 pyhs2 库连接 Hive 的方法,重点讲解 Kerberos 环境下的认证配置。内容涵盖系统依赖安装、SASL 错误排查、HiveClient 封装类实现,以及对接 Superset 时 SQLAlchemy URI 和连接参数的具体配置,帮助开发者解决大数据环境下的连接难题。
2026-10-13
5


本文详细介绍 Python 使用 pyhs2 库连接 Hive 的方法,重点讲解 Kerberos 环境下的认证配置。内容涵盖系统依赖安装、SASL 错误排查、HiveClient 封装类实现,以及对接 Superset 时 SQLAlchemy URI 和连接参数的具体配置,帮助开发者解决大数据环境下的连接难题。
本文详细解析 Flask 中 SQLAlchemy ORM 框架的数据查询方法,重点讲解一对多(如班级与学生)和多对多(如学生与课程)关系的定义与查询。通过 relationship 函数配置关联属性,利用 backref 和 lazy 参数优化加载策略,并提供具体的代码示例展示如何高效获取关联数据。
本文深入解析 SQLAlchemy 使用中易被忽视的性能陷阱,涵盖计数方式、列选择、批量更新、级联删除、加载策略及批量导入等场景。通过对比错误与正确用法,提供具体的代码优化方案,帮助开发者避免不必要的数据库往返和内存开销,提升应用响应速度。
本文详细介绍如何利用Python工具sqlacodegen自动生成SQLAlchemy的Model文件。通过pip安装该工具后,使用指定命令格式连接MySQL数据库即可生成对应模型代码。文章还演示了如何通过--tables参数仅生成指定表的Model,并提供了完整的命令示例及生成的Python代码结构分析,帮助开发者快速搭建数据库映射层。
本文详细介绍如何在Python中利用Pandas库结合SQLAlchemy和pymysql模块实现MySQL数据库的读写操作。文章解析了ORM概念,重点讲解了to_sql与read_sql_query函数的使用,并通过DataFrame写入及CSV文件导入两个实例,展示了从连接配置到数据持久化的完整流程。
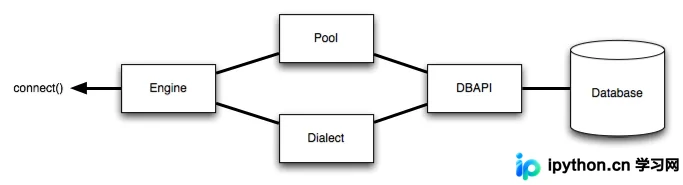
本文深入解析 SQLAlchemy 中 Engine 的核心作用,阐述其如何通过连接池(Pool)和方言(Dialect)驱动数据库交互。重点介绍 create_engine 的初始化流程、延迟连接机制,以及 echo、pool_size、pool_recycle 和 pool_pre_ping 等关键参数的配置方法,帮助开发者优化数据库连接效率与稳定性。
本文深入解析Python SQLAlchemy中ORM映射的两种实现方式。首先介绍传统的mapper函数映射机制,通过定义Table、类及mapper关联实现对象与数据表对应;随后重点讲解Declarative声明式系统,展示如何继承Base类简化映射配置。通过对比两种方式的代码结构,帮助开发者理解ORM底层原理并选择合适方案。
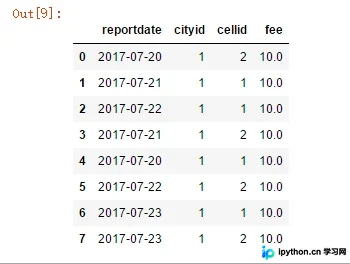
本文介绍如何利用pandas的to_sql方法将DataFrame数据保存至数据库。重点解析chunksize批量处理、if_exists冲突策略及index索引控制等关键参数,结合MySQL连接与数据汇总示例,展示从数据读取、处理到入库的完整流程。
本文介绍如何使用Python工具sqlacodegen自动生成ORM实体类。通过安装该工具,指定数据表名称和输出文件,可快速生成如Fund.py的映射代码,避免手动编写,提高开发效率。
本文详细介绍如何在Python中通过aiomysql库实现MySQL的异步操作。内容涵盖环境依赖(Python3.4+、asyncio、PyMySQL)、aiomysql的安装方法,以及三种核心应用场景:基础异步连接、异步连接池的使用,以及结合SQLAlchemy进行对象关系映射(ORM)的完整代码示例。
本文详细介绍Python中如何使用SQLAlchemy模块连接各类数据库,涵盖MySQL、PostgreSQL等常见引擎配置。通过完整示例演示模型定义、Session会话创建、数据查询(filter、order_by)、结果映射为DataFrame以及聚合统计等核心操作,帮助开发者快速掌握SQLAlchemy在Python项目中的实际应用。
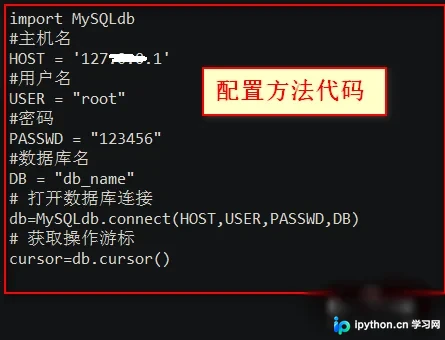
本文详细解析在Python中处理模块更新与数据修改的三种核心方法。首先介绍利用原生MySQLdb执行SQL语句的配置与执行流程;其次阐述基于Flask框架结合SQLAlchemy进行数据库连接、表处理及更新函数的完整实现;最后探讨通过封装reload机制防止数据对象被重置的编码方案,为开发者提供多样化的技术选型参考。