

MySQL连接错误2013及启动失败问题的排查与解决
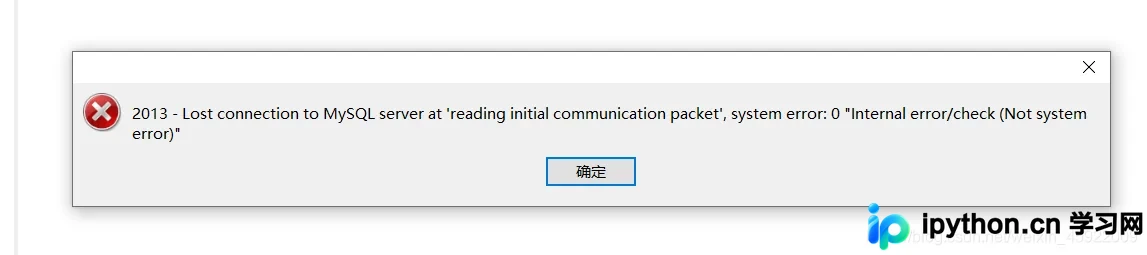
本文详细解析MySQL连接时报错2013(远程连接超时)的成因,并提供简单的服务重启法。同时针对Windows下MySQL服务启动报错“系统找不到指定文件”及“自动停止”的情况,给出通过注册表修正ImagePath和使用命令行重新初始化的具体操作步骤,帮助快速恢复数据库服务。
2026-10-15
6

本文详细解析MySQL连接时报错2013(远程连接超时)的成因,并提供简单的服务重启法。同时针对Windows下MySQL服务启动报错“系统找不到指定文件”及“自动停止”的情况,给出通过注册表修正ImagePath和使用命令行重新初始化的具体操作步骤,帮助快速恢复数据库服务。
生产环境中SQL因in条件过多导致响应缓慢(由80ms升至5.8s)。通过EXPLAIN定位到关联表未走索引,排查发现字段字符集不一致导致隐式转换。统一字符集后耗时降至1秒内,并补充了强制索引与in选择性的优化建议,确保高并发场景下的查询效率。
在SQL Server中,当数据量大时,使用NOT IN或NOT EXISTS子查询可能导致全表扫描,造成执行时间长达30秒以上甚至服务无响应。通过将NOT IN改为LEFT JOIN配合IS NULL判断,可将执行时间显著降低至毫秒级,有效解决性能瓶颈。
本文深入解析 SQL 中强大的行转列技术。通过 Group By 与 Sum + Case 结合,实现已知科目的静态交叉表展示;利用子查询动态拼接字符串,应对科目不固定的场景。同时介绍基于 syscolumns 系统表的自动化 SQL 生成方法,适用于复杂报表开发。
本文整理了在 SQL Server 中查询所有数据库名称、指定数据库内所有表名称以及特定表中所有字段名称的常用 SQL 语句。通过访问 Master..SysDatabases、SysObjects 及 SysColumns 等系统视图,可快速完成元数据检索与审计工作,无需编写复杂的 Join 逻辑即可实现基础信息的高效提取。
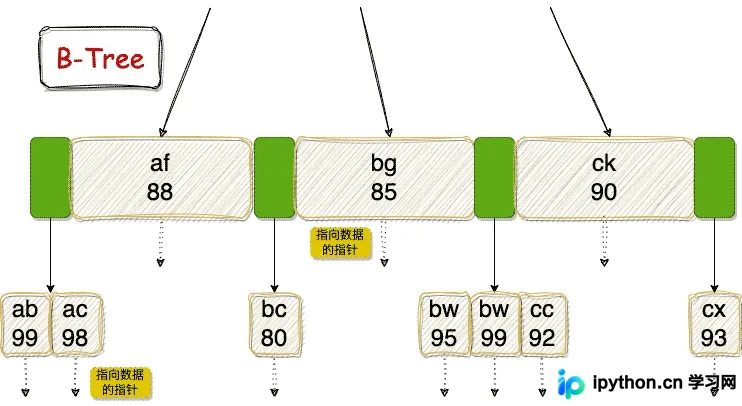
本文解析 MySQL InnoDB 引擎的索引底层实现。重点对比 B-Tree 与 B+Tree 的区别,阐述页大小、树高对查询效率的影响及 IO 次数。涵盖联合索引的最左前缀原则、范围搜索限制及自适应哈希索引机制,帮助理解 SQL 优化的核心基础。
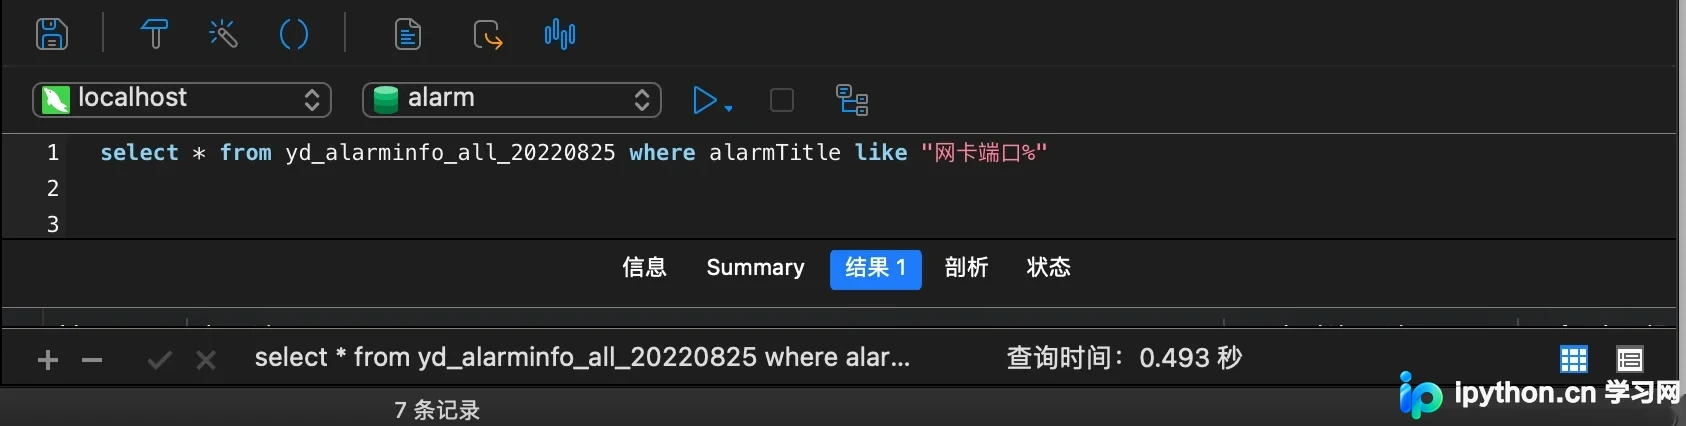
本文深入探讨 MySQL 中模糊查询(LIKE)的优化方案。通过实测对比,展示了普通索引、左前缀索引对查询效率的巨大提升(最高达数百倍)。同时验证了 LOCATE、POSITION 等函数无法替代索引加速,澄清了常见的 SQL 优化误区,为处理大数据量下的字符串搜索提供可靠参考。
本文详解如何解决Node.js连接MySQL时遇到的两类常见报错:"Error: Cannot enqueue Query after fatal error"与MySQL 8.0+特有的认证协议不支持问题。前者可通过开启连接池配置解决,后者需修改用户认证方式为mysql_native_password,附带完整操作步骤与代码示例。
本文系统梳理了 MySQL 慢 SQL 优化的核心思路与开发规范,涵盖索引设计的六大原则(如最左前缀、避免冗余)、查询语句的十七项规范(如禁止 SELECT *、大分页处理)。通过 EXPLAIN 分析和代码示例,帮助开发者识别 Using temporary/filesort 等性能瓶颈,提供从建表到 SQL 编写的完整优化方案。
本文系统介绍XSL/XPath中的核心运算符,包括路径选择、逻辑判断(And/Or/Not)及关系比较。结合简历XML文档实战,演示如何运用通配符与集合函数精确筛选包含特定技能或符合日期范围的节点,并输出结构化数据。
在 SQL Server 数据库备份还原或主从切换后,常出现登录名与数据库用户不匹配的孤立用户错误。本文介绍利用系统存储过程 sp_change_users_login 的 Auto_Fix 动作自动关联登录名,并提供针对多数据库的批量处理思路及安全性注意事项。
本文深入解析 SQL Server 中 EXCEPT 与 NOT IN 运算符在数据去重场景下的性能差异。通过实际测试发现,在小数据量下两者差异不大,但随着数据量增加,EXCEPT 凭借 Merge Join 机制展现出更优的执行效率,而 NOT IN 则可能因 Null 值处理产生额外开销。文章结合执行计划分析,揭示了统计数据和索引对性能的关键影响,为生产环境中的查询优化提供实操建议。